六款中国大模型的权重里,留着Blackwell的指纹
一份取证报告称,DeepSeek、Moonshot、MiniMax 和蚂蚁的六款模型在初始化时留下 NVIDIA Blackwell 的指纹。作者在真实芯片上复现了部分结果,同时明确:指纹只能说明初始化硬件,不能说明芯片在哪、归谁、是否违法。
一份发布于 2026 年 11 月 12 日的取证报告称,六款中国大模型的初始化权重带有 NVIDIA Blackwell 的指纹。Blackwell 是 NVIDIA 当前旗舰 AI 芯片,B200、B300、GB200、GB300 对华出口需要美国许可证。报告称未见获批记录。报告作者 Will DePue 来自 Unemployment Labs,推文称结果已由 OpenAI 和 Anthropic 的资深研究者独立复核。证据来自公司自己发布的模型权重,不依赖内幕或泄露。

指纹怎么留下
模型权重是决定模型如何处理信息的数十亿个数字。训练开始前,这些数字要先初始化。报告称,PyTorch 在 NVIDIA GPU 上用 Philox 伪随机数生成器产生初始值。seed 决定生成什么数字,GPU 的 SM 数量决定线程如何分配,也决定这些数字被放进权重的哪个位置。
Hopper H100 SXM、H200、H800 有 132 个 SM,使用 270,336 个线程。Blackwell B200/B300 有 148 个 SM,使用 303,104 个线程。GB200/GB300 有 152 个 SM,使用 311,296 个线程。训练后,没被更新的权重会保留起始值,被训练改过的权重也可能留下弱痕迹。
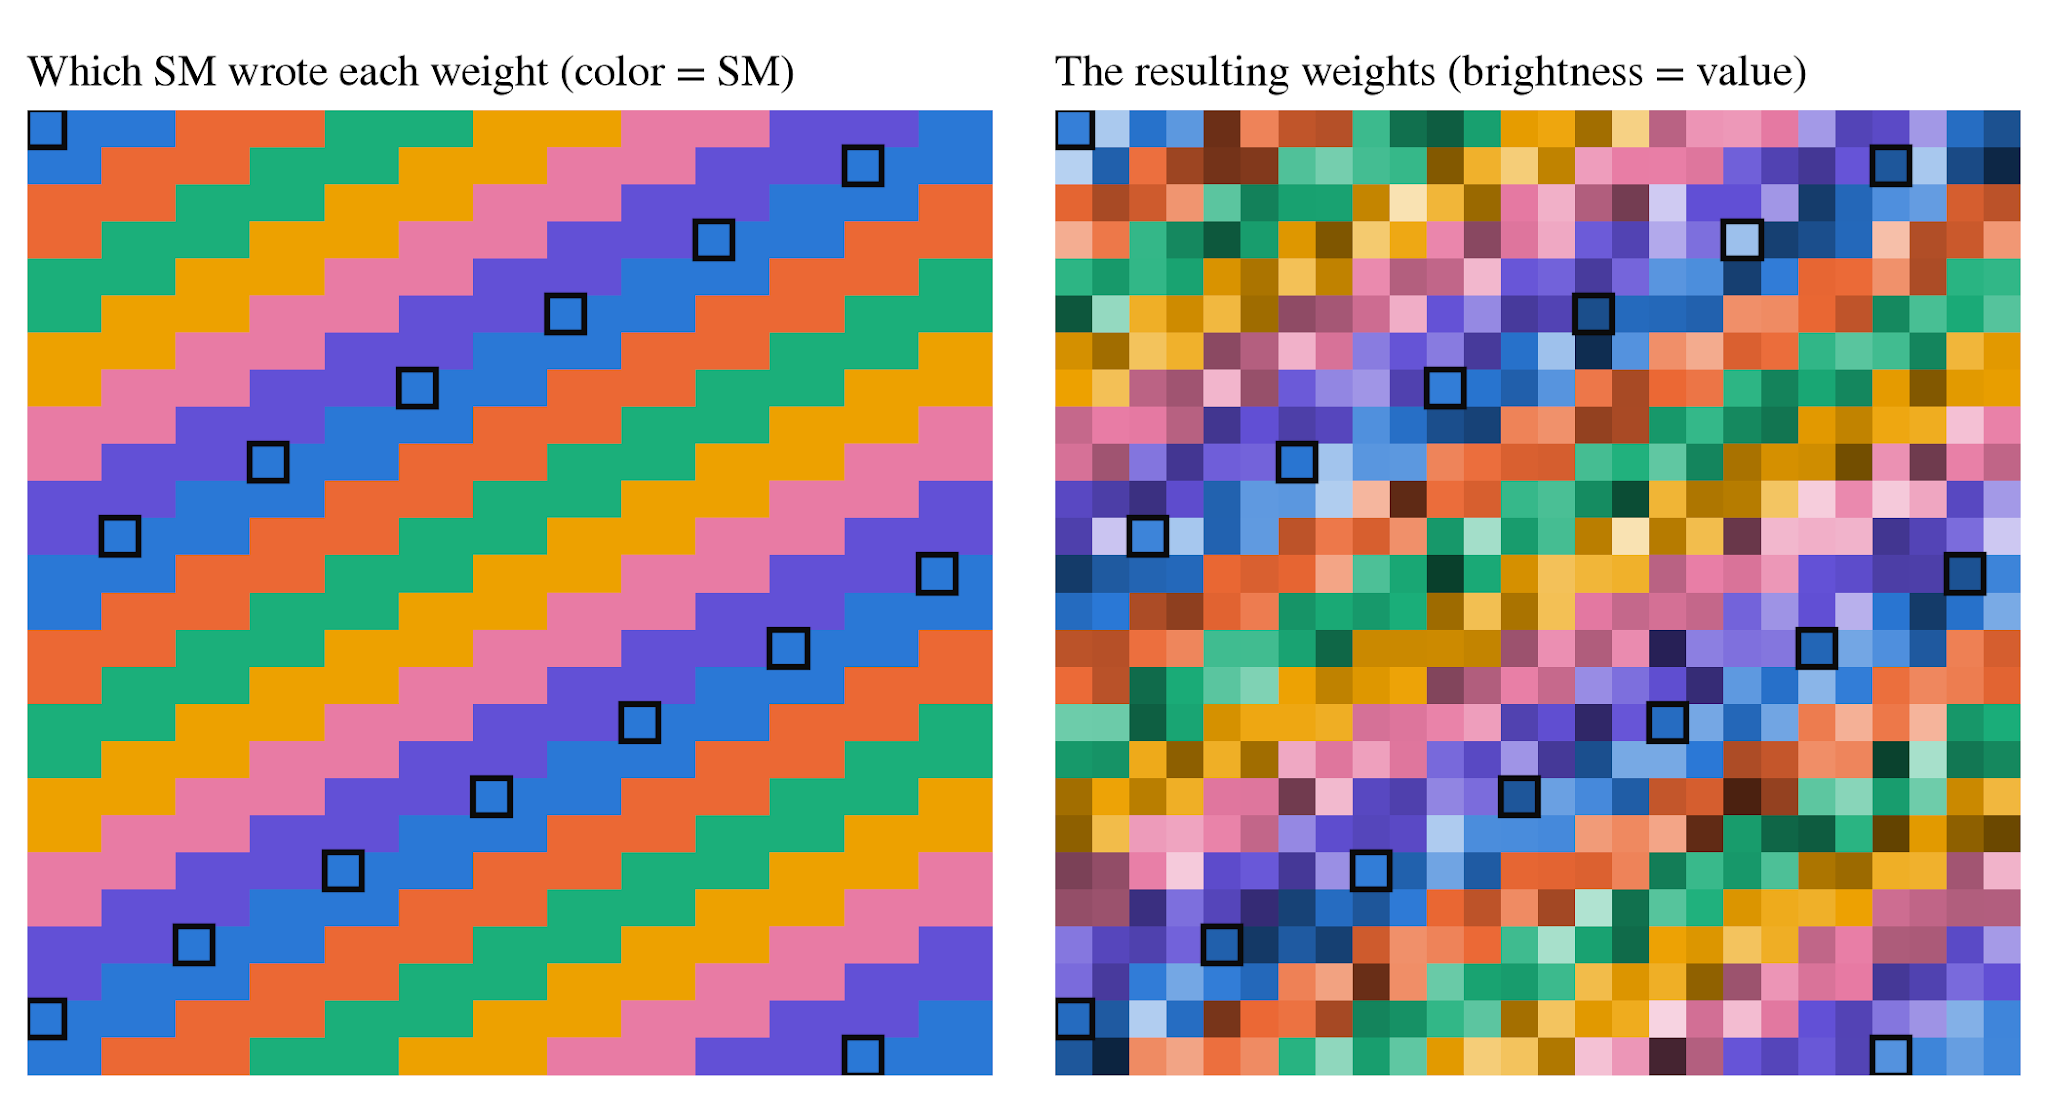
图1用简化例子说明 GPU 如何填充权重。真实芯片的线程数更多,摆放规则相同。
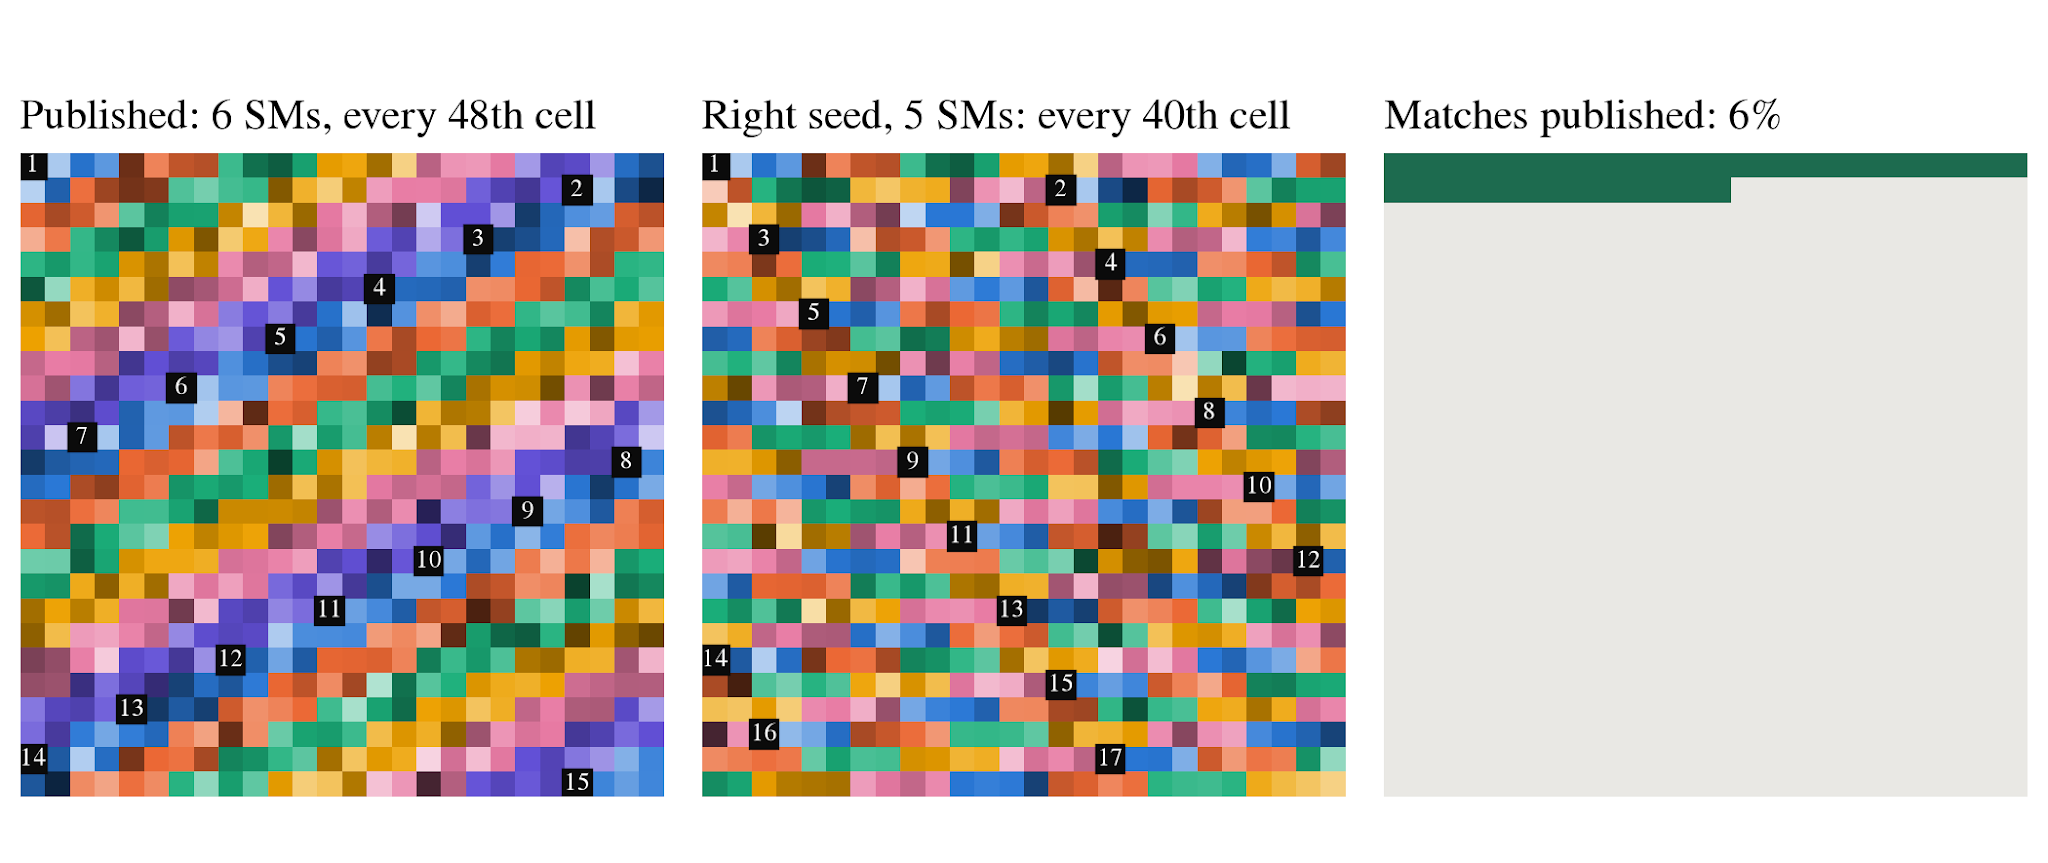
图2显示同一个 seed 换到不同 GPU 后,数字序列没变,位置变了。
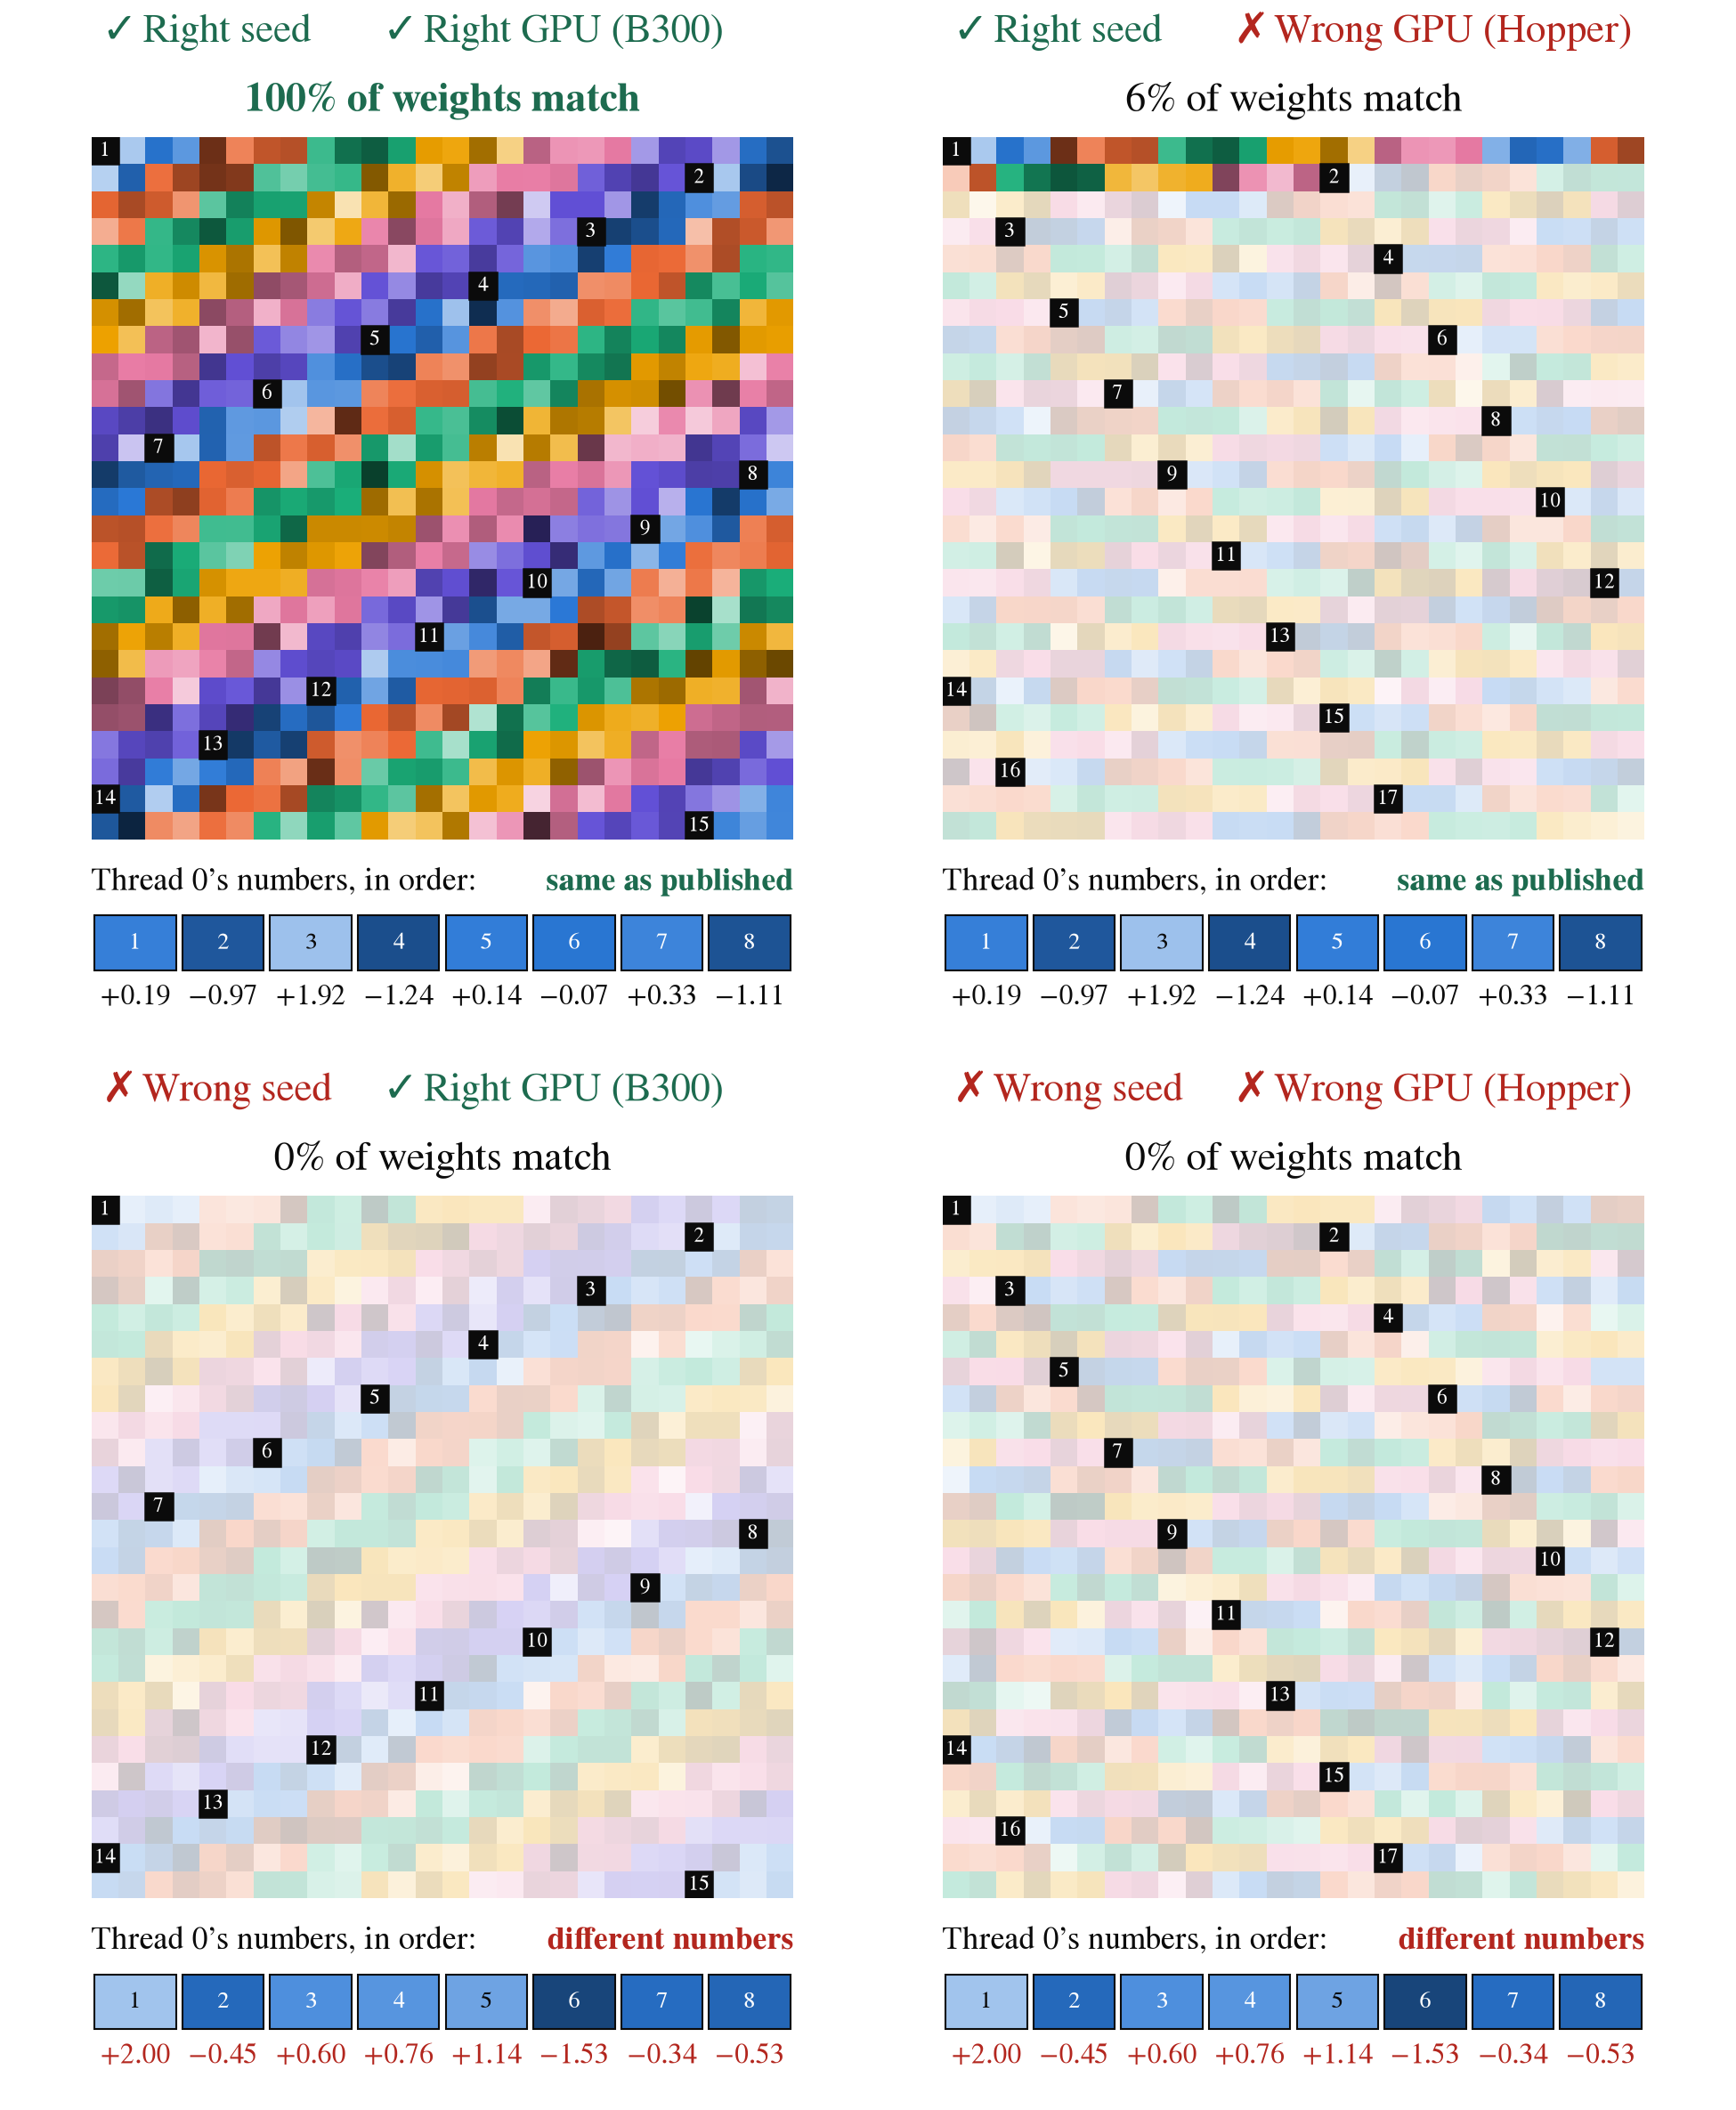
图3说明 seed 和线程布局要同时正确,才能复现原始排列。
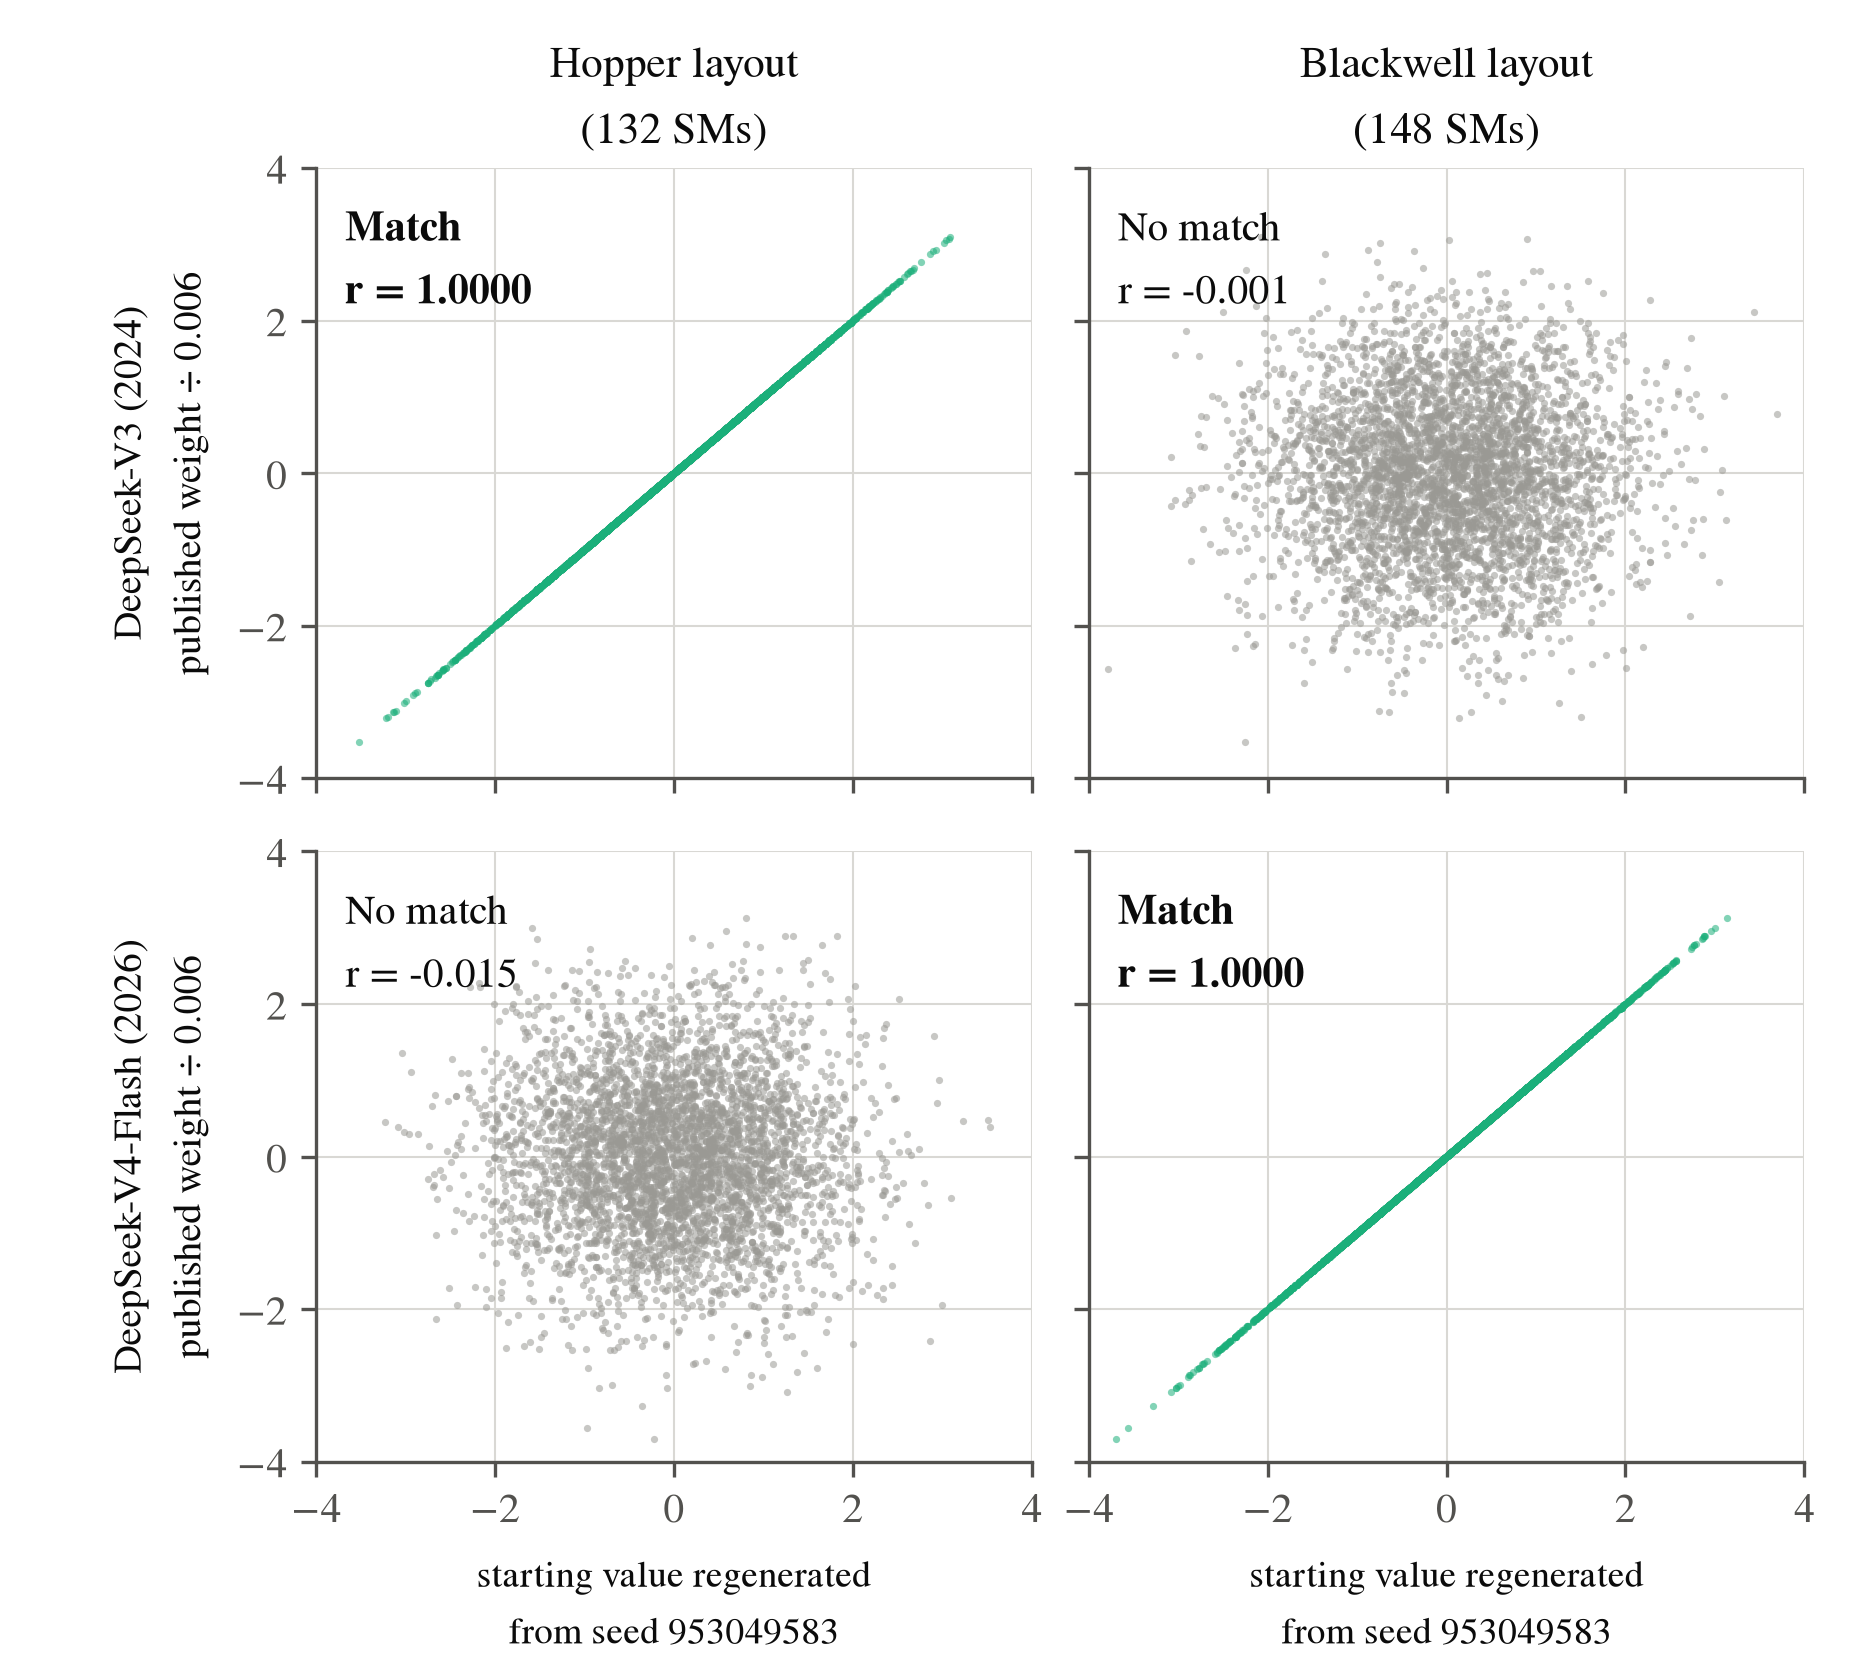
图4对比保留的起始值。DeepSeek-V3 匹配 Hopper 布局,DeepSeek-V4-Flash 匹配 Blackwell 布局。
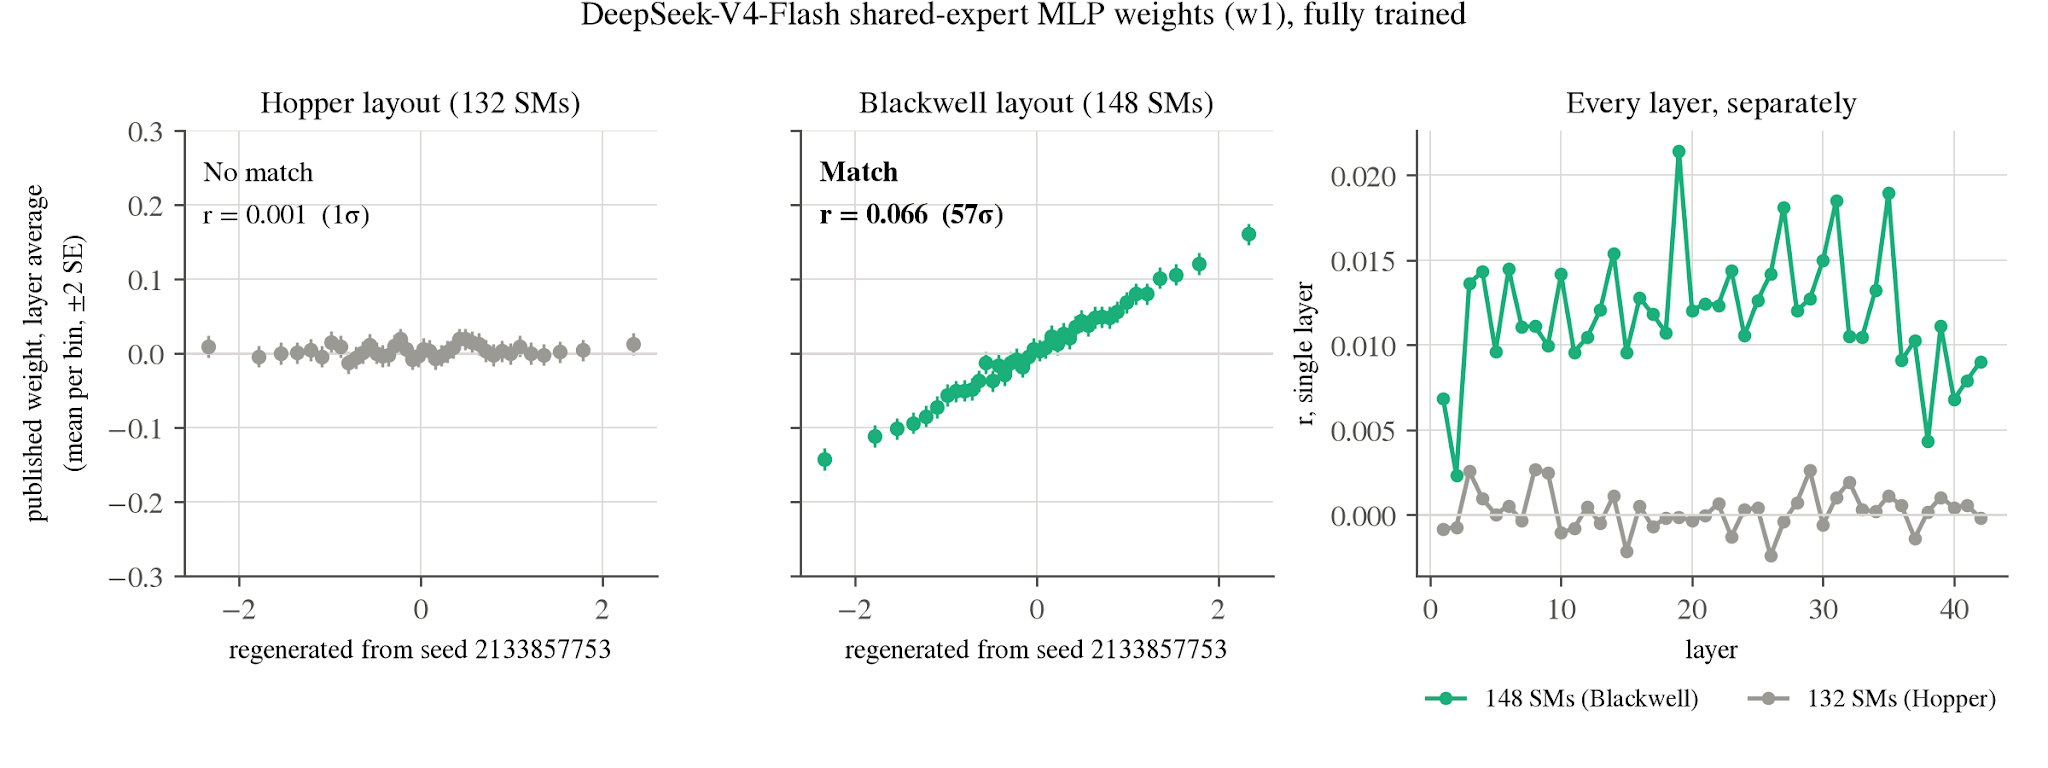
图5展示训练过的权重仍保留弱痕迹。DeepSeek-V4-Flash 在 Blackwell 布局下,起始值更高的权重,最终值也略高。
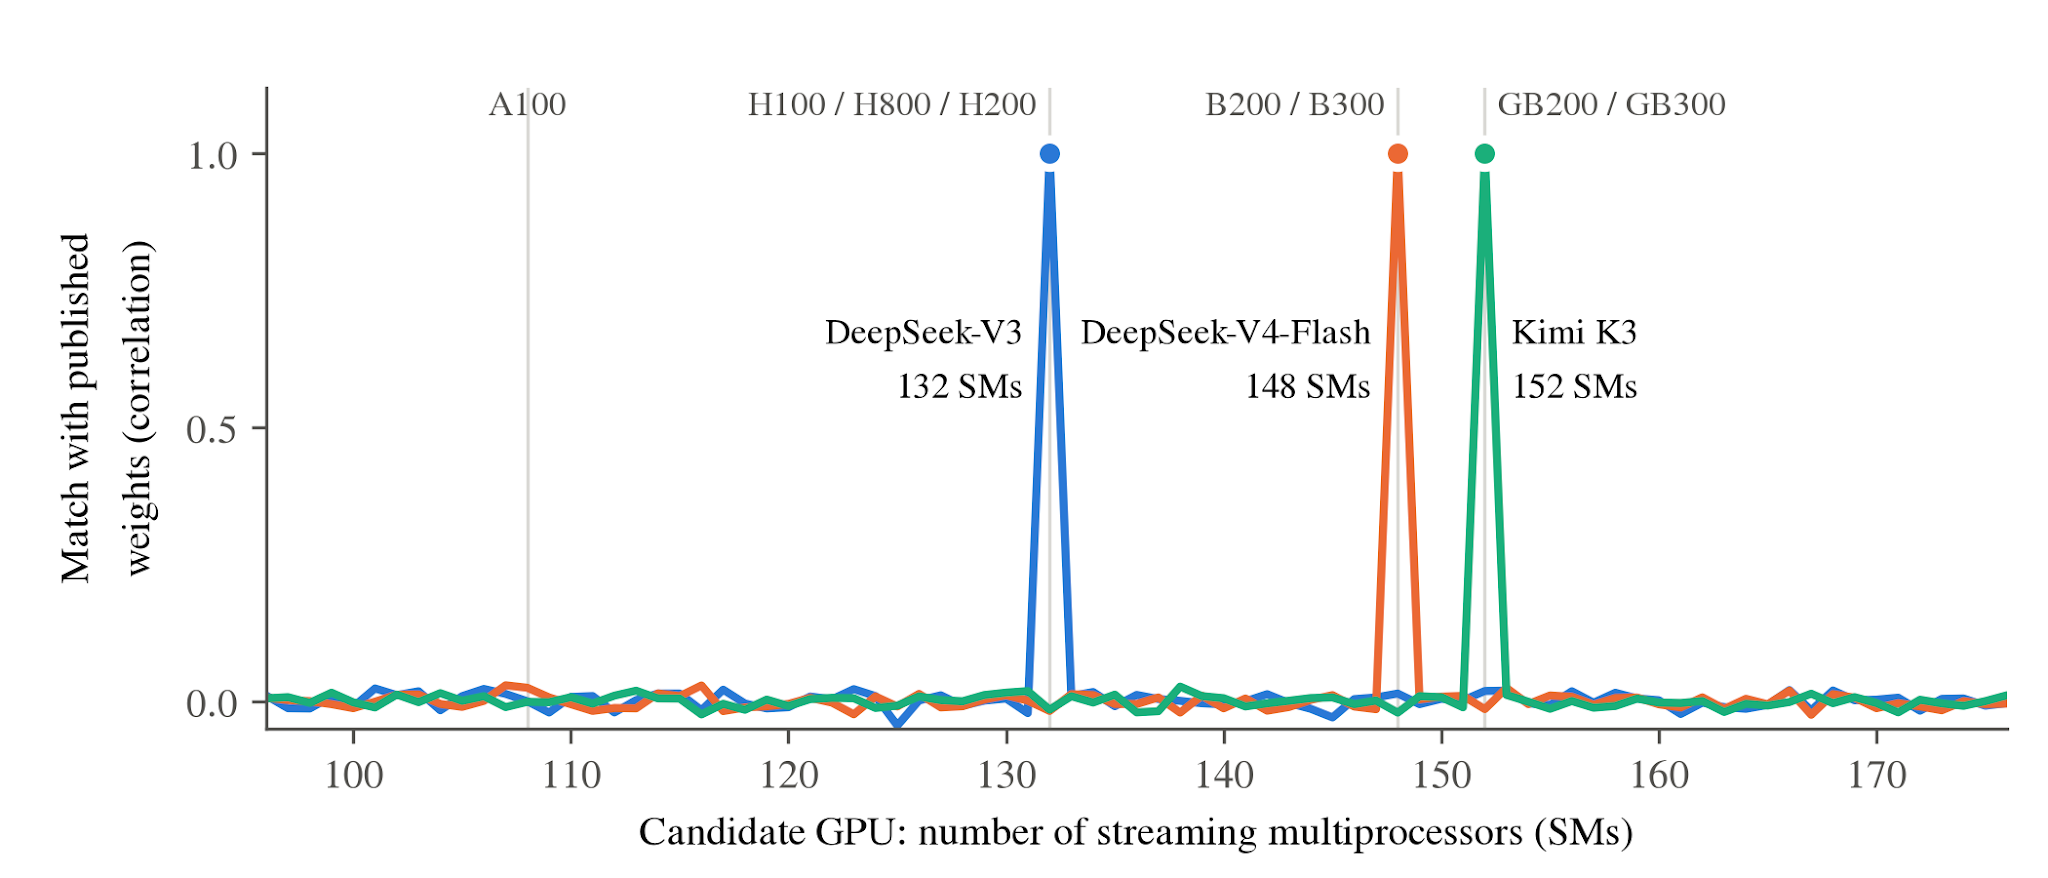
图6比较候选布局。DeepSeek-V3 在 132 SM 处峰值,V4-Flash 在 148,Kimi K3 在 152。
六款模型和验证
报告列出的六款模型如下:
| 实验室 | 模型 | 匹配布局 | 发布时间 |
|---|---|---|---|
| DeepSeek | DeepSeek-V4-Flash | 148 SM,B200/B300 | 2026 年 4 月 |
| DeepSeek | DeepSeek-V4-Pro | 152 SM,GB200/GB300 | 2026 年 4 月 |
| Moonshot AI | Kimi K3 | 152 SM,GB200/GB300 | 2026 年 7 月 |
| Moonshot AI | Kimi K3.1-Pro | 152 SM,GB200/GB300 | 2026 年 11 月 |
| MiniMax | MiniMax-M3 | 148 SM,B200/B300 | 2026 年 6 月 |
| Ant Group | Ling-3.1-flash | 152 SM,GB200/GB300 | 2026 年 10 月 |
报告称 Kimi K3.1-Pro 与 K3 使用同一 seed,可能是 K3 的检查点继续后训练。
验证部分更硬。报告作者在真实 B300 上用未修改的 PyTorch 复现 DeepSeek-V4-Flash 的保留起始值,461 行中有 445 行逐位匹配。H100 复现了 DeepSeek-V3,GB200 复现了 Kimi K3。DeepSeek 的 seed 是 953049583,Moonshot 的 seed 是 20256586。把 seed 改 1,匹配消失。
统计上,报告搜索了约 6 万亿个 seed 和布局组合。随机情况下最强误匹配约为 8 sigma。六款模型的证据在 49 到 1385 sigma 之间,最弱的单项测试也有 20 sigma。
成本与边界
报告估算,最大训练运行 Kimi K3 和 DeepSeek-V4-Pro 各用了 2000 到 3000 块 Blackwell。单个集群采购成本约 1.5 亿到 2 亿美元。五个训练运行合计超过 5 亿美元,实验室在受出口管制 GPU 上的总支出可能达到数十亿美元。
边界也写得清楚。指纹只能说明初始化权重由哪类硬件生成,不能证明整个训练都用了同一批芯片。权重可以在一套系统初始化,再移到另一套系统训练。混合集群会削弱推断。指纹不能确定芯片在哪、归谁,也不能单独证明出口管制被违反。
AMD MI300X 是报告认真排除的替代解释。它在特殊配置下可以产生 148 或 152 的布局。但在 DeepSeek-V4-Flash 的 377 个数值差异点上,公开权重有 363 个匹配 NVIDIA,0 个匹配 AMD。其他五款模型没用这个测试排除,报告仍认为 AMD 解释极不可能。
还有一些盲区。闭源模型查不了。CPU 初始化的模型没有 GPU 指纹。百度 ERNIE-5.5 使用 PaddlePaddle,报告恢复出 seed 2760,但认不出硬件。Hopper 指纹也不能区分 H800、H100 SXM 和 H200。
报告还显示,不是所有中国实验室都换了 Blackwell。阿里 Qwen、智谱 GLM、腾讯、小米、StepFun 的新模型仍读作 Hopper。美团 LongCat-2.0 称训练在 AI ASIC 超级集群上,报告没在权重里找到 NVIDIA 指纹。
为什么值得看
出口管制的争论通常盯着物流、报关单和采购记录。公开权重提供了另一个检查口。模型公司公开权重,原本是生态策略,现在也成了硬件取证材料。闭源模型则留下盲区。
这份报告没有给出芯片来源的答案。它把问题推到了更具体的位置:如果这些指纹成立,这些 Blackwell 系统从哪里来,谁有访问权,出口管制该如何核查。
发布时间: 2026-11-13 06:27