vLLM跑出58倍吞吐,单用户387 tokens/s,token要过剩了?
vLLM 公布 DeepSeek-V4.1-Flash 在 Vera Rubin NVL72 上的成绩:P90 单用户 387 tokens/s 时每 GPU 吞吐 170 万 tokens/s,58 倍于 GB300;峰值 252 万,单并发 P90 1810 tokens/s。58 倍有前提,官方把内核、TP8 低延迟路径和机架级 KV/Engram 池都拆开讲了。
vLLM 在 X 上公布一组数据:DeepSeek-V4.1-Flash 跑在 NVIDIA Vera Rubin NVL72 上,P90 单用户 387 tokens/s 时,每 GPU 吞吐 170 万 tokens/s,达到 GB300 NVL72 的 58 倍。峰值每 GPU 252 万 tokens/s,单并发 batch size 1 时 P90 1810 tokens/s。基准是 SemiAnalysis AgentX,配置为 P/D 分离和 Wide-EP。P/D 分离指 prefill 和 decode 分开部署,Wide-EP 指专家并行铺得更宽。
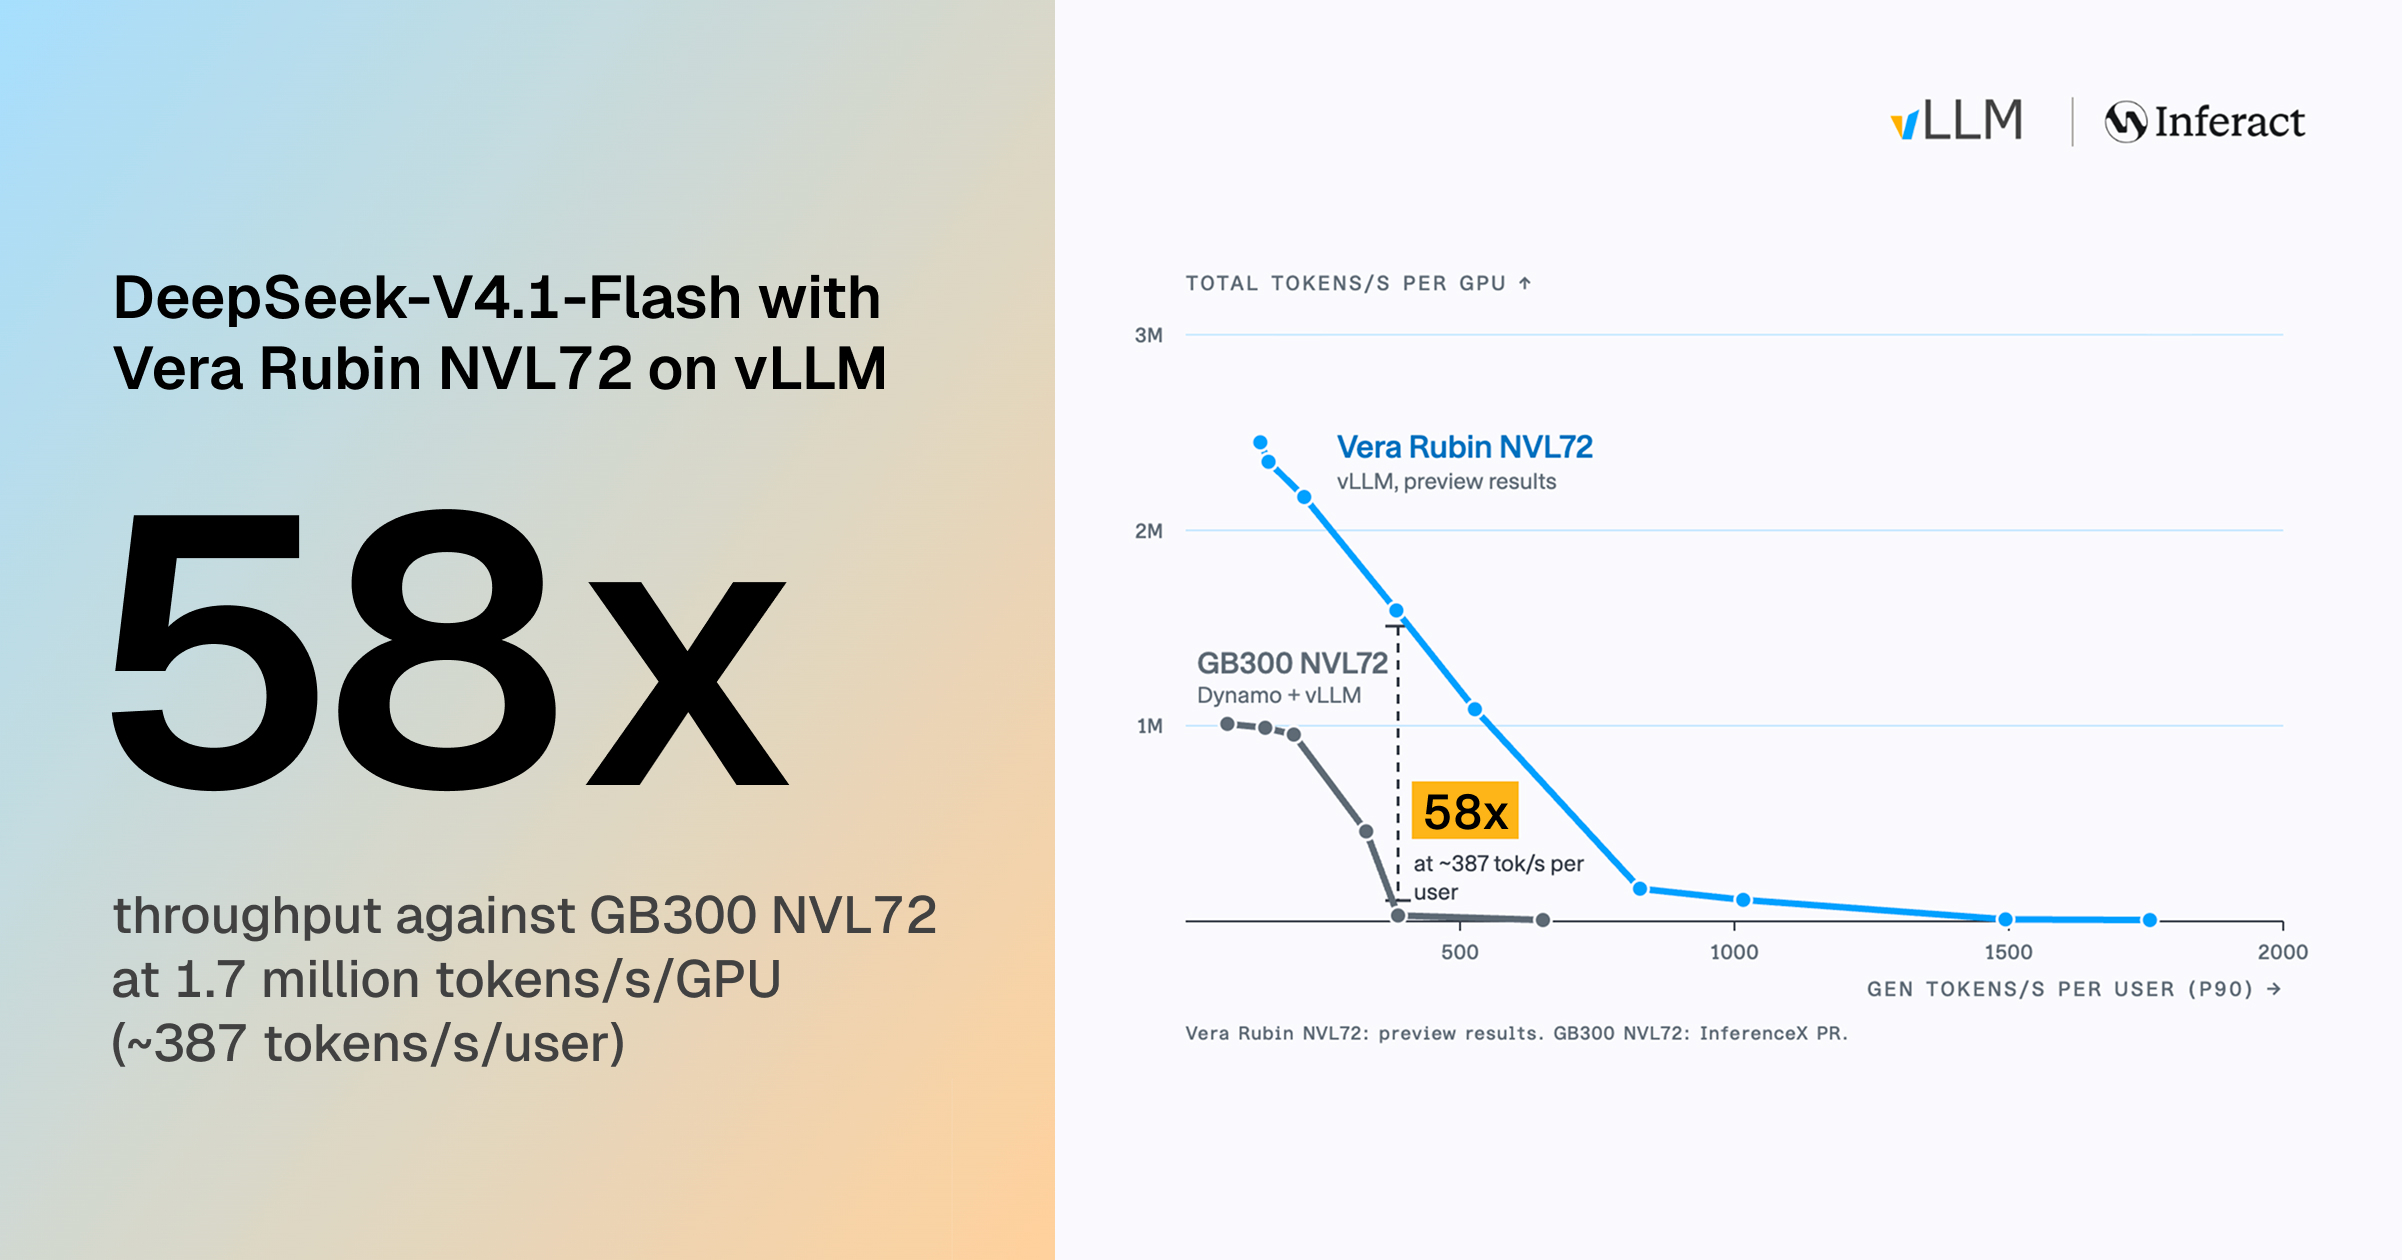
数字列清楚:
- 峰值吞吐 252 万 tokens/s/GPU,GB300 的 2.7 倍。
- P90 387 tokens/s/user 时,170 万 tokens/s/GPU,58 倍于 GB300。
- 单并发 batch size 1,P90 1810 tokens/s,使用 TP8。
- 吞吐统计缓存输入、未缓存输入和输出 token。
58 倍有前提。换 benchmark、并行策略或硬件,数字不能直接搬。官方给了测量方法:用 vllm bench forward 走真实 execute_model 路径,真实权重和 AgentX token,内核 A/B 循环数秒取持续值。

Rubin 的三个硬件特性决定了大部分优化方向。第一,每 GPU 有两个内存域,SM 读自己的域快,读另一个域慢。带宽敏感数据留在本地域:MoE 权重、LM head、MegaMoE combine buffer、mHC residual。第二,SM107 加了更宽的 block-scaled MMA。K64 FP8×FP4 一次做两倍工作,用在 MegaMoE 和低延迟 routed GEMM;K128 FP4 MMA 用在 indexer,decode MQA logits 快 15% 到 22%。第三,72 GPU 共享一个 NVLink 域。TP8 跨两个 compute tray,all-reduce 成本只多 0.3 微秒,每 GPU 权重读取几乎减半。
vLLM 保留 GB300 的三种引擎形态:DEP2 prefill、Wide-EP decode、低延迟 TP decode。DeepSeek 的 kernel set 也保留,MegaMoE、MegaAttn、Mega-mHC、MegaGate、DeepSelect 重写给 SM107。
DEP2 prefill step 快约 28%。Mega-mHC 把 residual 放在 die-local 内存;MegaAttn 让 tensor core 不等 load;MegaGate 只给仍有机会进 top 6 的专家算精确 sqrt-softplus,384 个专家里约 7 个通过。MegaMoE 按最忙 rank 的 token 数量定 tile,40 步 replay 里时间降 55%。
DEP decode step 快约 25%。MoE 权重按输出列拆到两个内存域,每个域 SM 只读本地 tile;Wide-EP dispatch 每个 token 一次 NVLink 往返;combine 用 sentinel 等数据,不靠 barrier;split-K GEMM 在 SM107 cluster 上摊 K。
低延迟 TP8 decode 跨两个 tray,每个 rank 放 288 列专家和 8 个 attention head。官方称 batch size 1 时 P90 1810 tokens/s,P50 从 1117 到 1844 tokens/s/user。技巧包括 packed FP4 weight stages 把 shared memory 从 7 stage 提到 11 stage,每步省 57 微秒;shared expert 塞进 routed GEMM,低于 16 行时每步省 220 微秒;all-reduce 和 mHC 合成一趟;sparse MLA 提前 gather KV。
Rubin 算得快,一机架同时服务的 session 变多,live prefix 超过单 rank cache。vLLM 把机架内存池化:Mooncake KV pool 跨 DRAM 和 spare HBM,走 RDMA;Engram 两张 94.4 GiB 的 hashed n-gram 表分片到 GPU HBM,走 NVLink,不再每个 prefill 实例留一份 host memory。高并发下 prefix 命中率 96.5% 到 97%。Dynamo 路由把请求发给未缓存工作最少的 worker 和 DP rank。三台 DEP2 实例并发 4800 时,请求数多 68%,TTFT P50 从 29.8 秒降到 4.2 秒,命中率从 91.8% 到 96.1%。12 个 DEP2 模拟里,rank 空闲时间从 10.3% 降到 1.3%,TTFT P90 从 0.98 秒到 0.38 秒。

有网友问并发怎么改变曲线;有人说 1810 tokens/s 终端滚不动;也有人认为 2027 到 2028 会出现 token 过剩。@阿哲聊芯片 的观察值得记:总吞吐和单用户速度一起列,比只报峰值直观。只看峰值容易忽略并发下的单用户速度,官方这次把 P90 387 tokens/s 和 170 万 tokens/s/GPU 放在一起,信息量比单看 58 倍大。token 是否过剩,看效率提升后应用侧消耗怎么变,也看这些优化能否从特定 benchmark 走到通用负载。
原文:https://vllm.ai/blog/2026-11-12-deepseek-v41-flash-vera-rubin
X 帖:https://x.com/vllm_project/status/2121008091538092393
发布时间: 2026-11-13 07:25