4B模型追平GPT-5.4:Agent记忆难在判断写什么
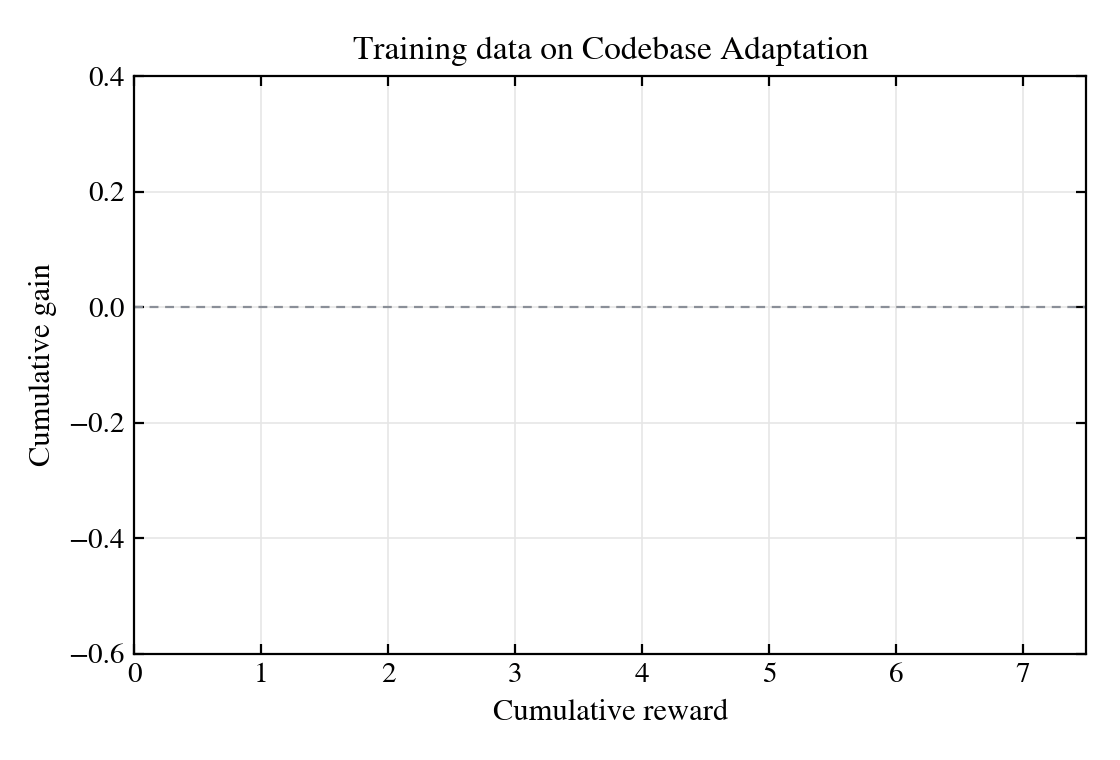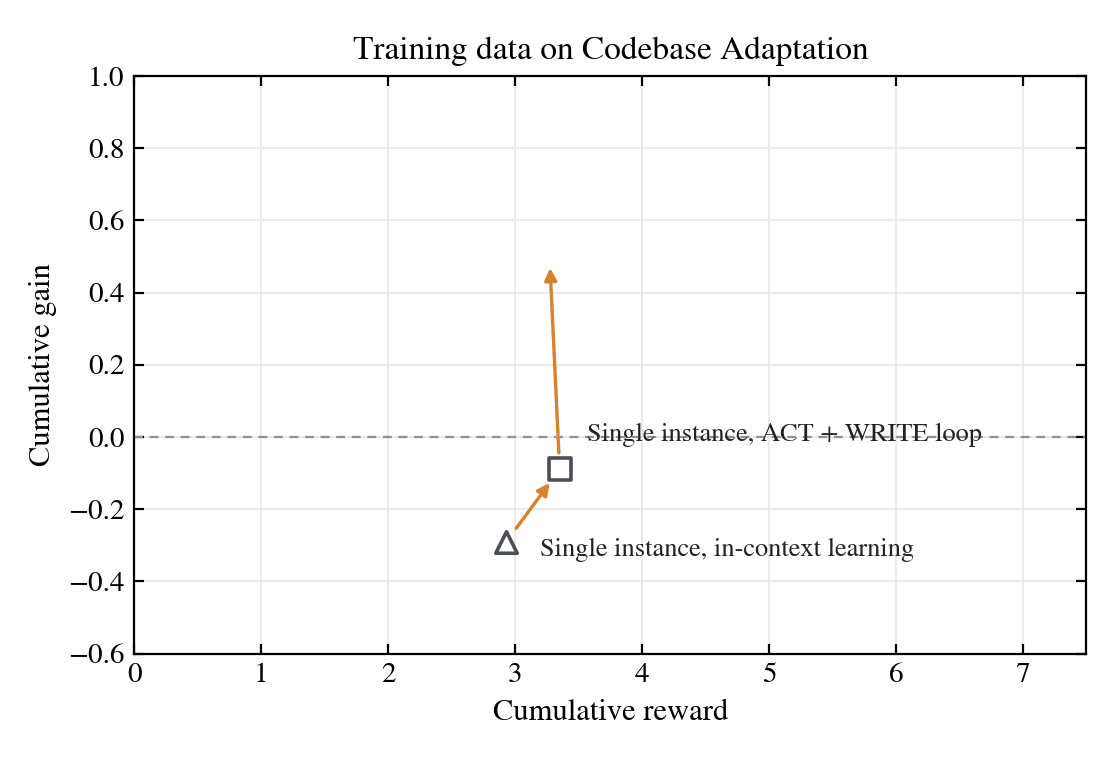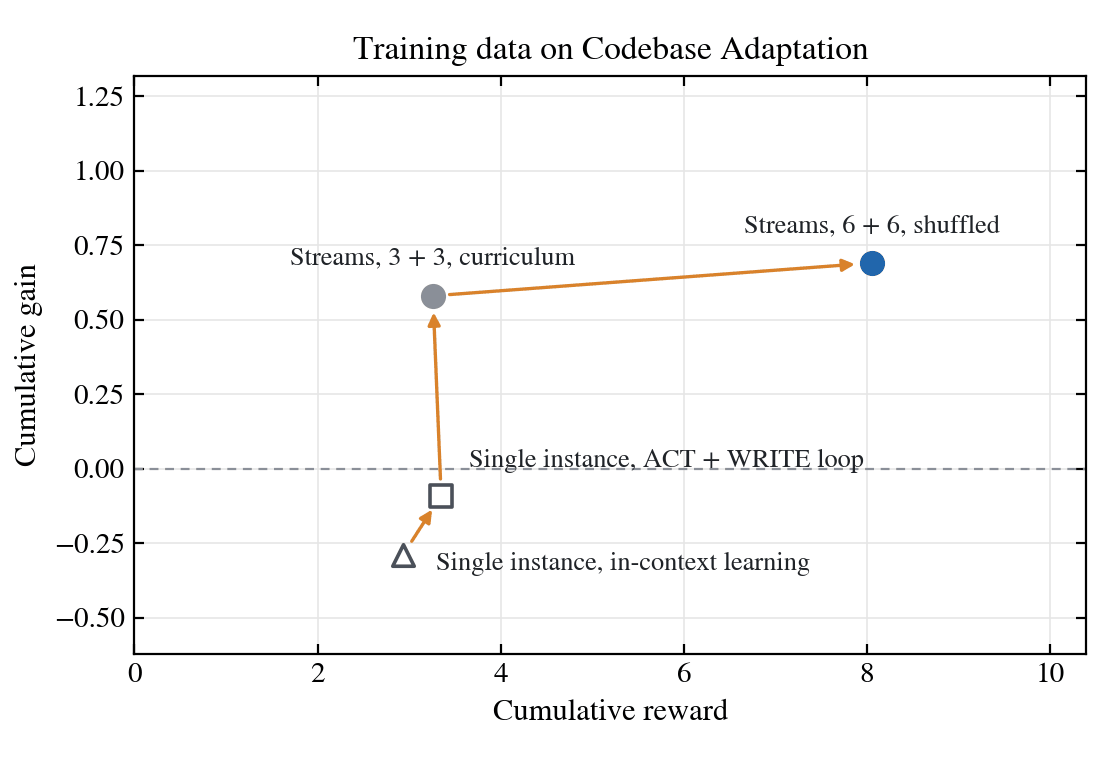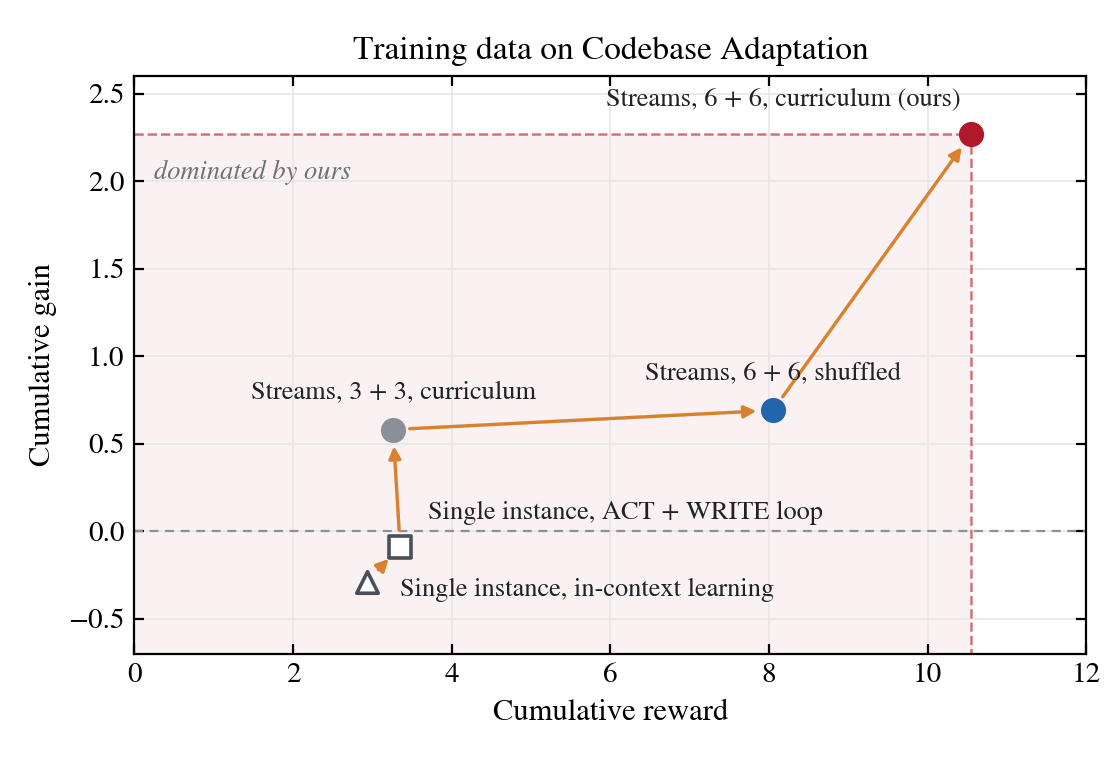
CMU团队用RL让同一个模型分饰actor和writer,在代码库适配任务上,Qwen3.5-4B拿到10.55累计奖励和+2.27累计增益。结论很具体:只训练解题不够,只训练写记忆也不够,探索和记忆得一起长。
给Agent一个MEMORY.md,让它边干活边记笔记,这个做法很常见。问题在于,很多Agent记了一堆流水账,关键决策反而没留下,下一轮照样踩同一个坑。
CMU的RIME工作把这件事拆开:记忆系统本身未必是瓶颈,模型对何时写、写什么的判断更关键。elvis在推文里推荐了这篇工作,他的笔记提到,这跟记忆系统关系不大,更多是模型对何时行动的意识和判断。这个判断值得注意。
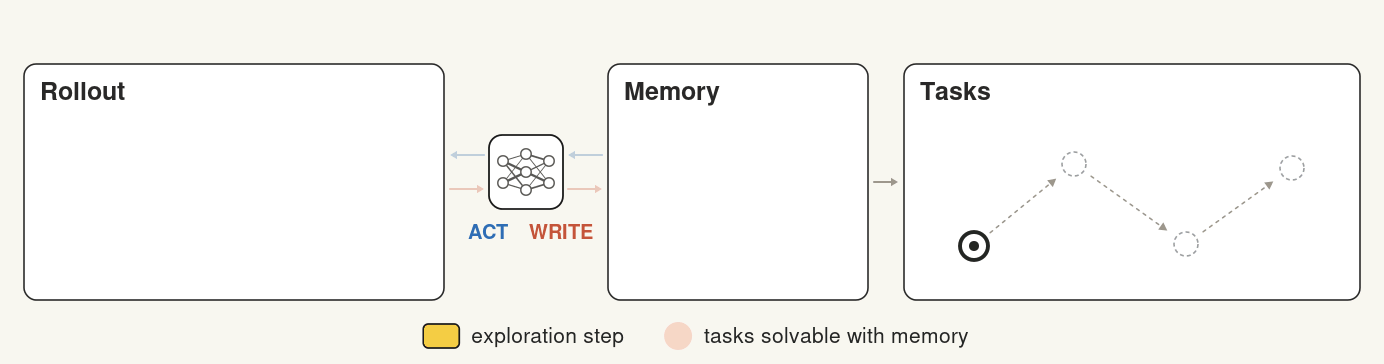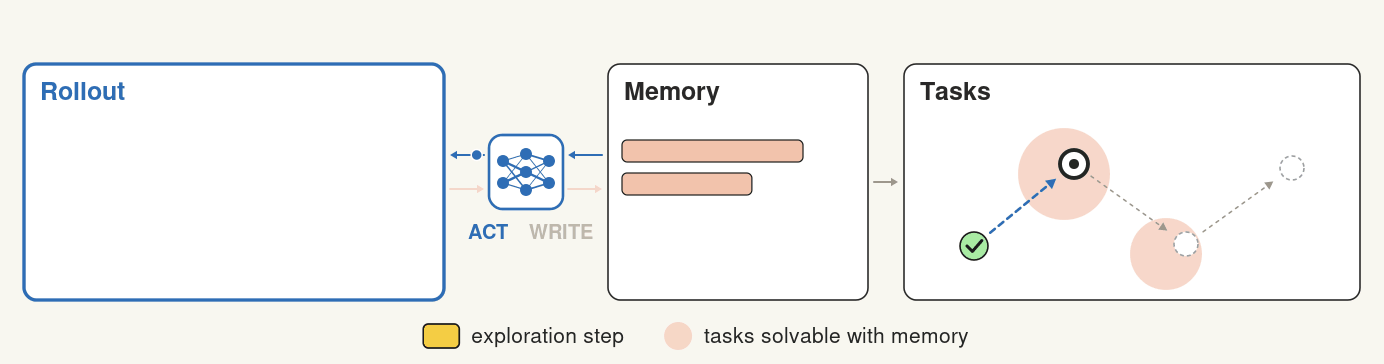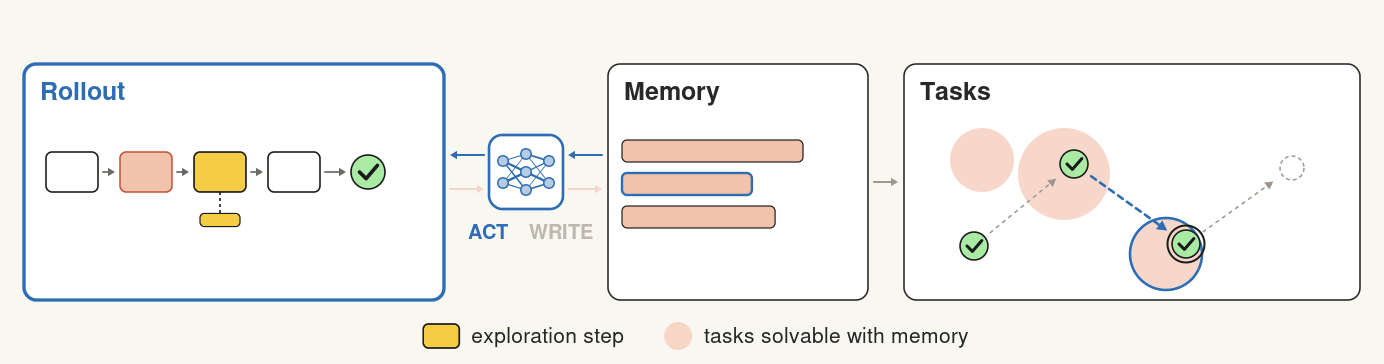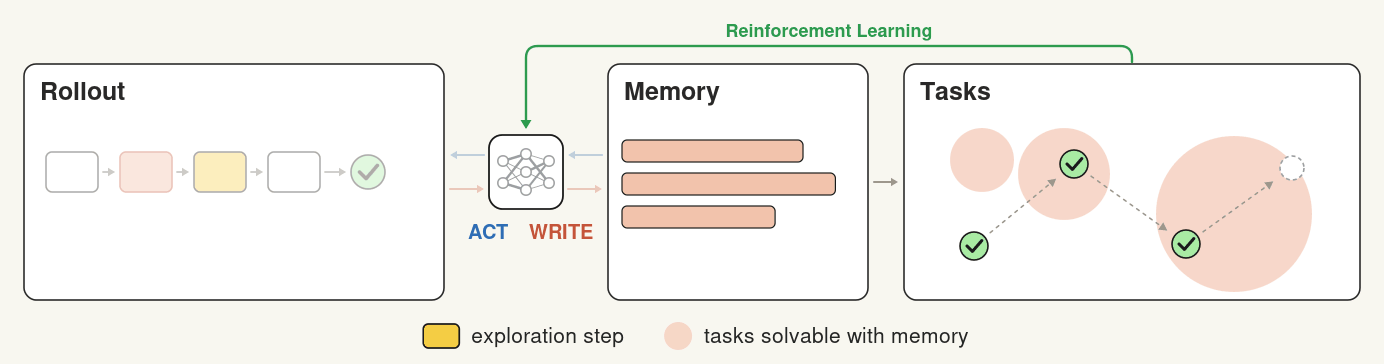
RIME训练一个模型干两个角色。actor用现有记忆解题,writer在任务结束后复盘,更新给下一个任务用的笔记。两个角色共享参数。训练时,writer的奖励是接下来K个任务的平均表现减去过去K个任务的平均表现。它奖励的是记忆带来的提升,跟记住多少字关系不大。actor的奖励除了任务完成,还有一个探索奖励。一个LLM judge比较任务前后的记忆,看有没有新发现、纠正错误、给出具体线索、避免重复。改写同义句拿不到分。
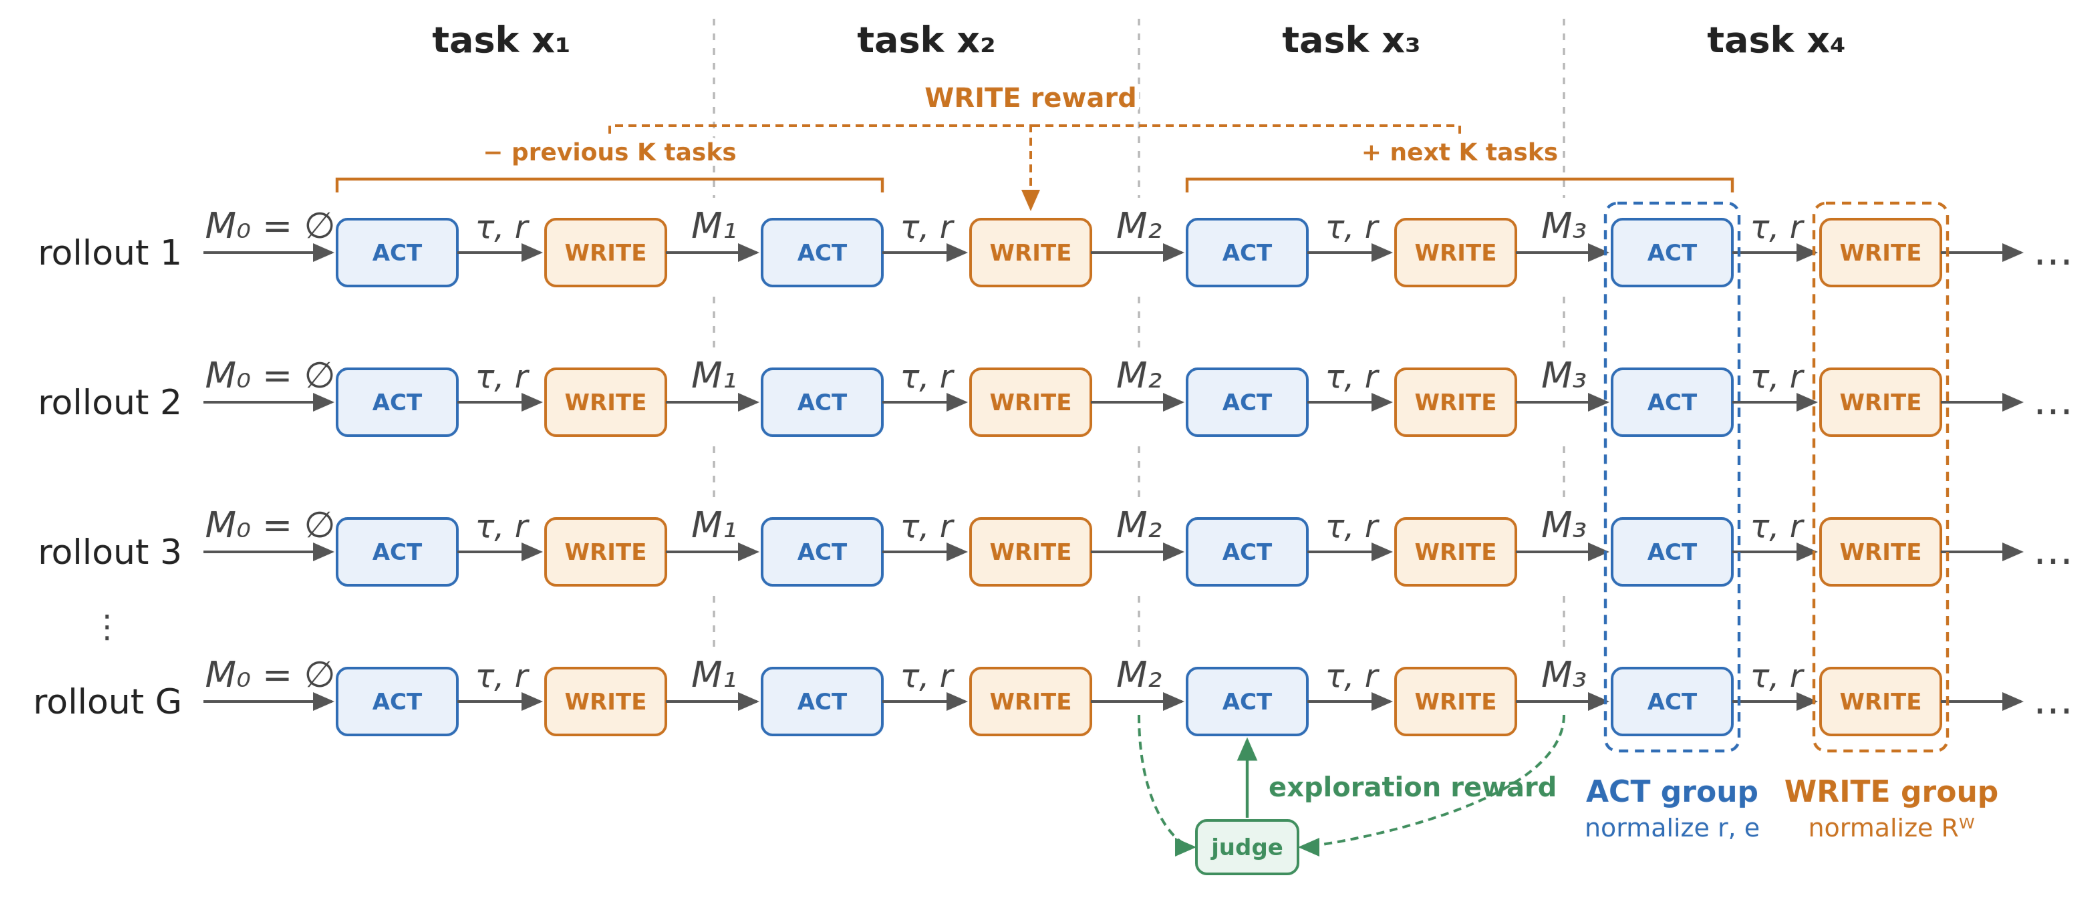
这个设计里有个反常识的点。只训练actor,用任务奖励做多轮RL,能提高解题能力,但不会提高记忆质量。只训练writer也不够。文章的实验说,writer能从actor的轨迹里保留信息,actor又依赖writer留下的记忆。如果actor只盯着当前任务,轨迹里没有值得记的东西,writer再强也没用。所以actor需要被奖励去探索,去产生可复用的信息。探索奖励看的是记忆更新有没有实际内容,跟状态新颖关系不大。这个思路比传统novelty bonus更通用,不需要手设计状态表示。
实验分两个域:Symbolic Alchemy和Codebase Adaptation。后者来自Continual Learning Bench,测试流是19个bug修复实例,来自tablib和tenacity两个仓库,训练时没见过。指标有两个:累计奖励看任务表现,累计增益看带记忆比每次从零解题好多少。这个区分很重要。一个模型可能累计奖励很高,但增益很低,说明它本来就强,没从历史里学到东西。
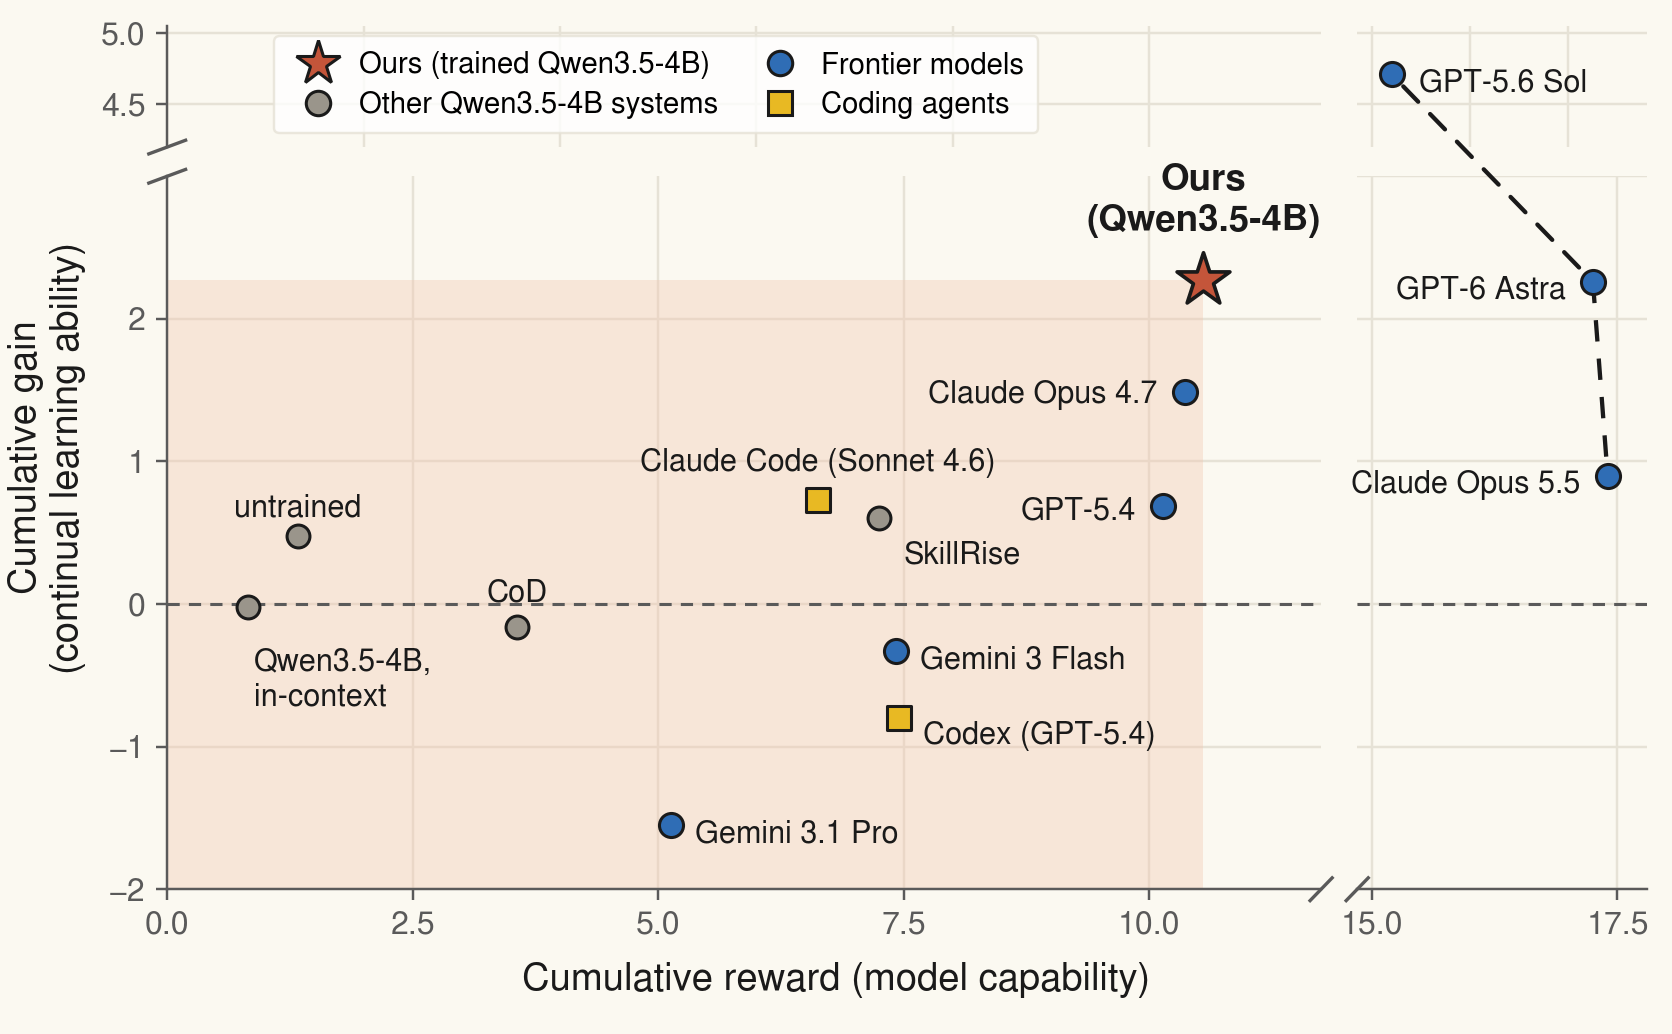
结果:Qwen3.5-4B在Codebase Adaptation上累计奖励10.55,累计增益+2.27。原文说,这个累计奖励接近GPT-5.4和Claude Opus 4.7 with in-context learning,累计增益接近GPT-6 Astra。表格里GPT-5.4是10.14和+0.69,Claude Opus 4.7是10.36和+1.49,GPT-6 Astra是17.25和+2.26。注意累计奖励和增益的排名不一致,Claude Opus 5.5累计奖励最高17.40,但增益只有+0.90。这个现象说明,强模型未必会从经验里学习。把前沿模型塞进Claude Code或Codex也不自动解决问题,Codex甚至比它的底层模型GPT-5.4在纯in-context learning下更差。这个结果对套个harness就能持续学习的假设不太友好。作者还提到,这里没有蒸馏或SFT,只有带正确奖励和课程设置的RL。
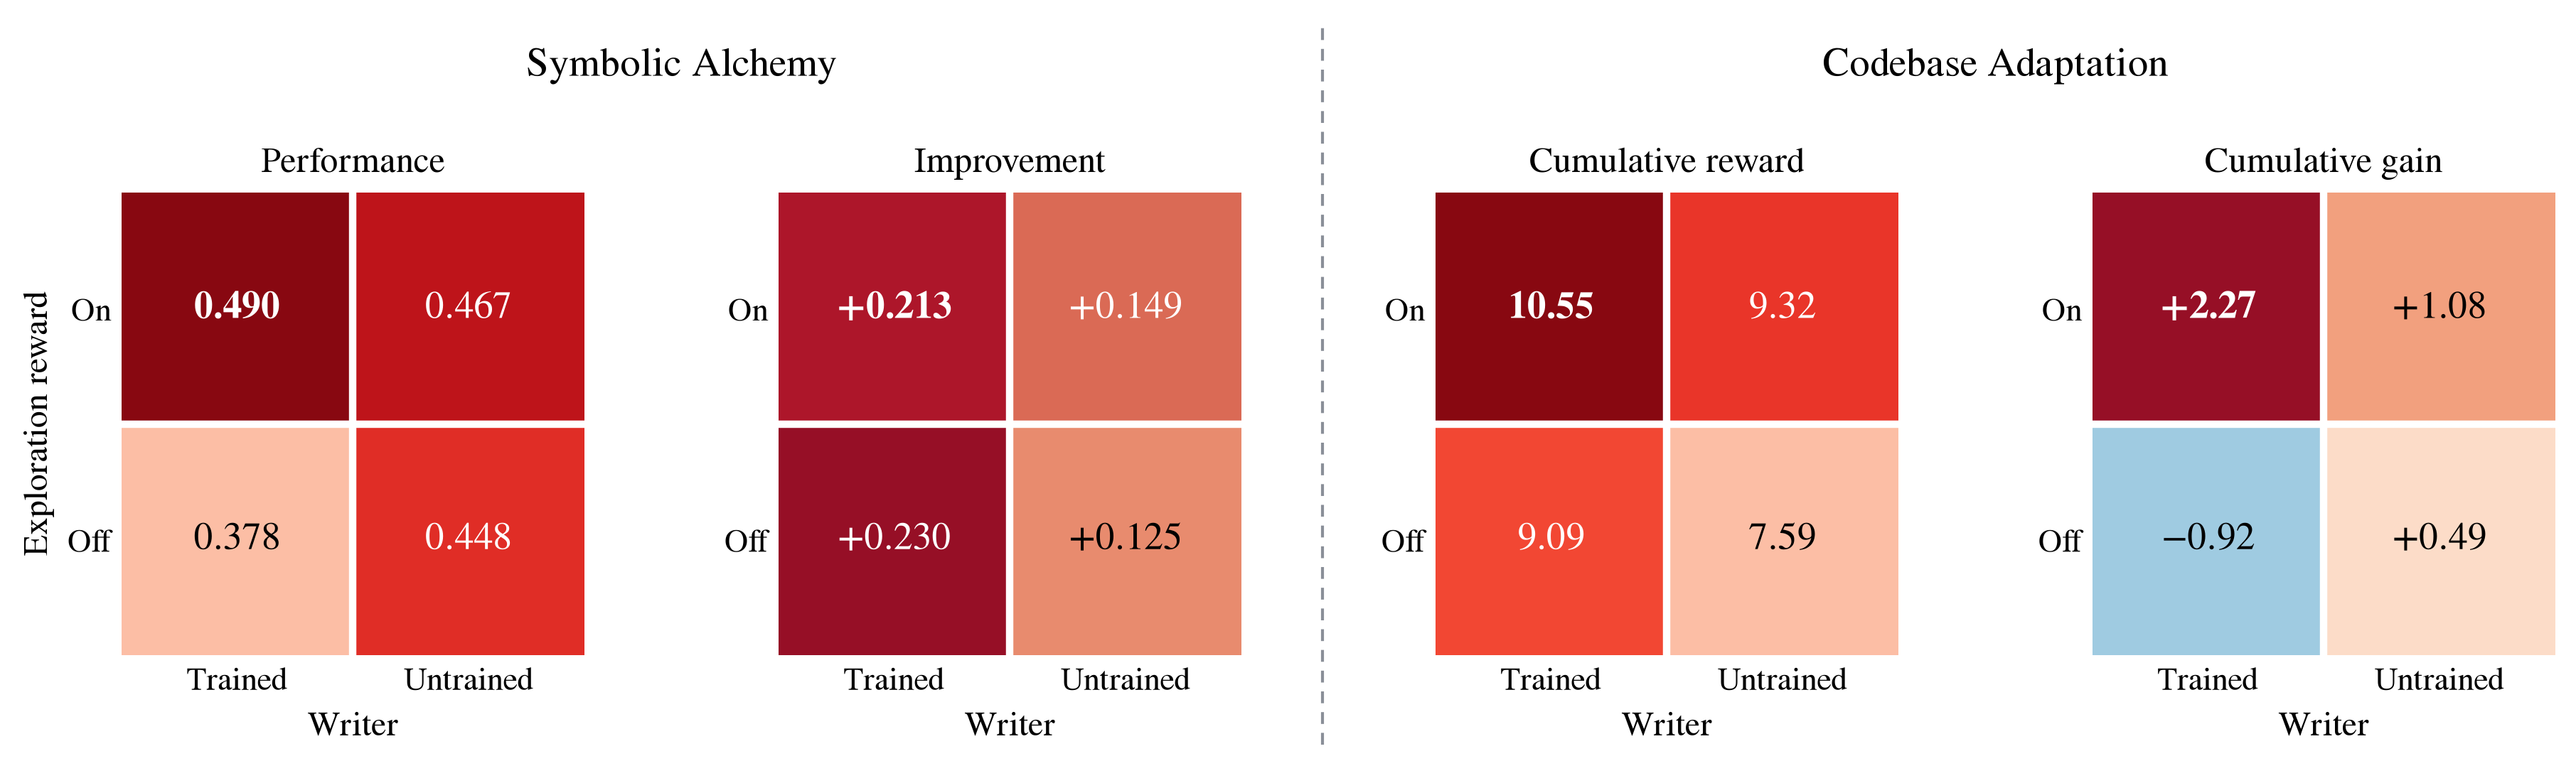
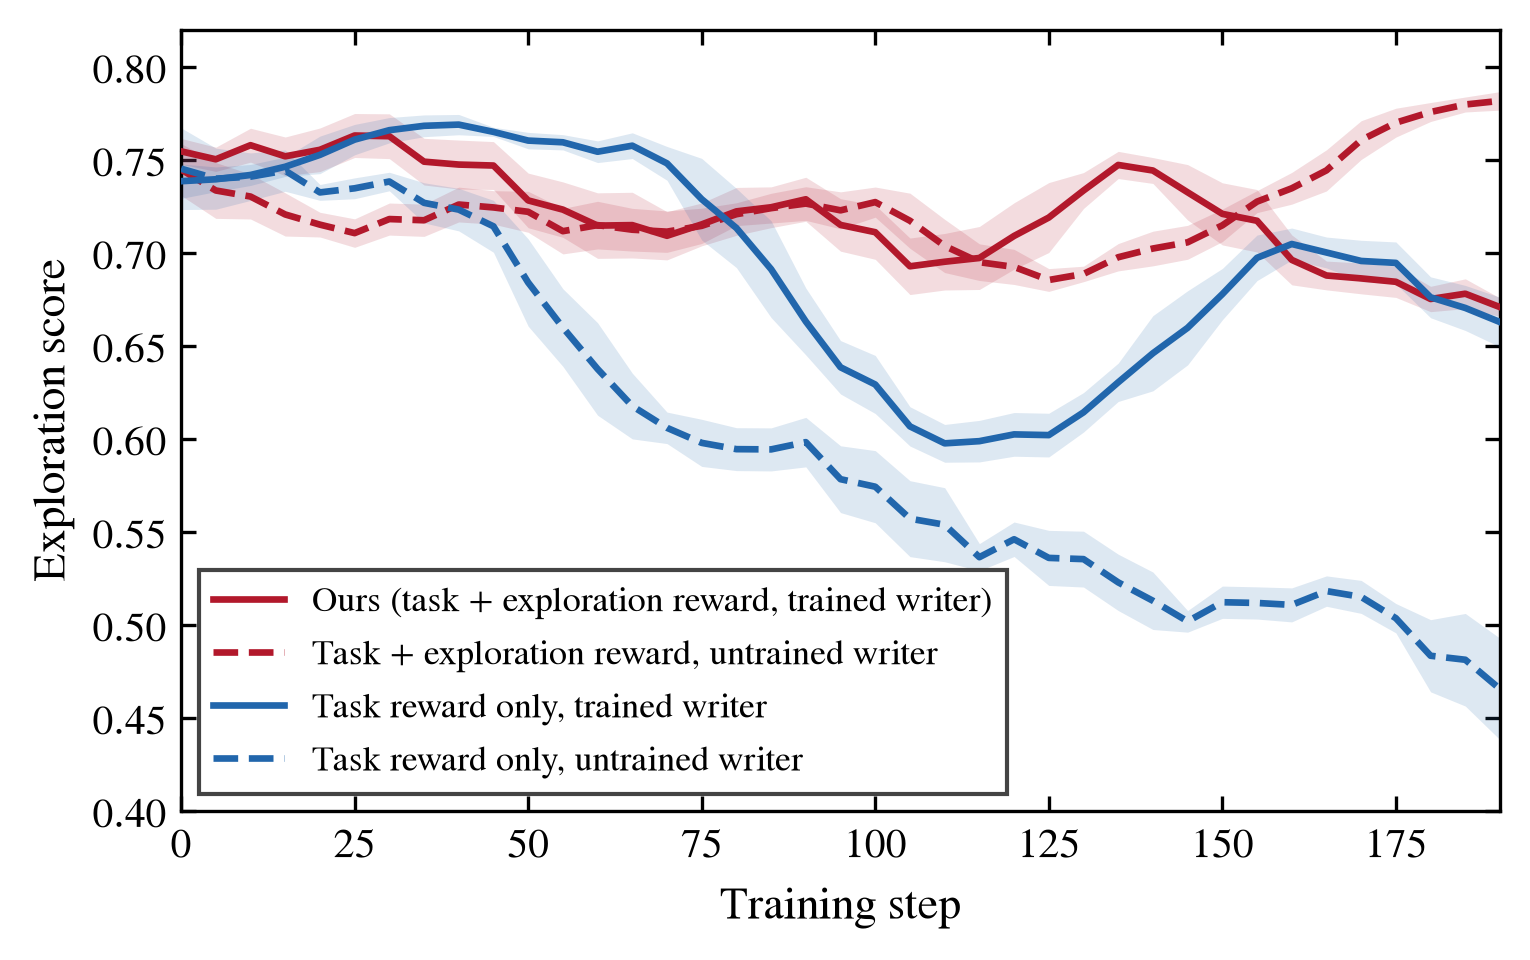
消融里最值得看的是探索奖励。去掉探索奖励,就算writer训练过,Codebase Adaptation的累计增益会变成负数,模型带着记忆反而不如每次从零解。训练writer加探索actor是四种组合里最好的。图10显示,联合训练时探索分数大致稳定,因为writer变强后actor要找到新信息更难,探索奖励让它继续找。只训练actor不奖励探索,分数会下降。
训练任务流的构造也重要。同样是6+6的流,按从易到难排序,累计增益+2.27,打乱顺序+0.69,把每段缩到3个任务+0.58。原文的解释是,早期任务要容易到让模型学会仓库怎么组织、测试怎么跑,后面的难任务才有机会用上记忆。训练流太短,记忆没有足够机会被使用,writer学不到什么值得保留。这个细节对做Agent产品的人有用:给个记忆文件只是起点,任务顺序和长度会改变记忆的价值。在两个26和27个issue的留出长流上,6+6课程训练的模型累计增益仍然最高。
还有一个分支实验:共享参数比解耦参数好。冻结writer只训练actor,累计增益几乎归零。把writer单独训练能恢复一些增益,但仍低于共享参数继续训练。原文的推测是,共享参数让actor的探索奖励和writer的改进奖励更新同一套权重,一个角色的学习能帮到另一个角色。
评论区有几个问题值得记。有网友问,让4B写笔记、前沿模型解题会怎样。有网友建议给writer加固定存储预算,并奖励下游成功,延迟回访可能帮它判断哪些经验值得留。还有网友问遗忘,Agent把记忆做成小笔记文件时,难的是决定删什么。另一个评论提到奖励horizon:帮下一个任务的笔记,和一个月后还有用的知识,可能不是一回事。有人问writer能不能从自己的错误笔记里恢复。这些问题原论文没有全部回答,文章也列了未来工作:效率、集成到agent系统、经验不是清晰任务流时怎么训练、写记忆和更新参数之间的取舍、多智能体并行时能不能用类似探索奖励。
最后回到那个场景。Agent的记忆问题,存储系统只是表面。真正难的是训练出判断:这次经历里什么值得写,什么写了会害下一个任务。RIME给出的信号很具体,用后续任务的表现来给记忆打分,再让actor为了写出有用的记忆去探索。4B模型能追到前沿模型的累计奖励,说明这条路至少在小规模上跑通了。但原文也承认规模还小,效率和集成是开放问题。对做Agent的人来说,先别急着堆记忆文件,看看你的任务流有没有给记忆被使用的机会。
原文和项目页:https://cmu-aire.github.io/RIME/ ,榜单:https://continual-learning-bench.com/leaderboard.html
发布时间: 2026-11-14 23:37