最像当前状态的记忆,对智能体常常没用
MemCredit把记忆选择从语义相似度改成决策效用:先用反事实干预算每条记忆的边际贡献,再训练轻量估计器。ALFWorld 500 token预算下成功率86.57%,BM25为65.67%。
智能体做长任务时,记忆系统通常按语义相似度检索:当前状态像哪段历史,就把那段历史塞回上下文。MemCredit这篇论文盯住一个尴尬问题:最相似的记忆,未必能帮你选对下一步动作。Elvis在X上汇总时说,多数被检索到的记忆对决策没有影响,语义相关性和有用性相关性很差。

论文的做法很直接:给每条记忆做受控反事实干预,保留它和去掉它各跑一次,看智能体动作怎么变,把变化记成credit。再用这些credit训练一个轻量估计器。推理时,语义相关性只负责高召回候选,估计器在固定token预算里决定谁留下。底层agent policy不改,推理时也不额外跑环境。
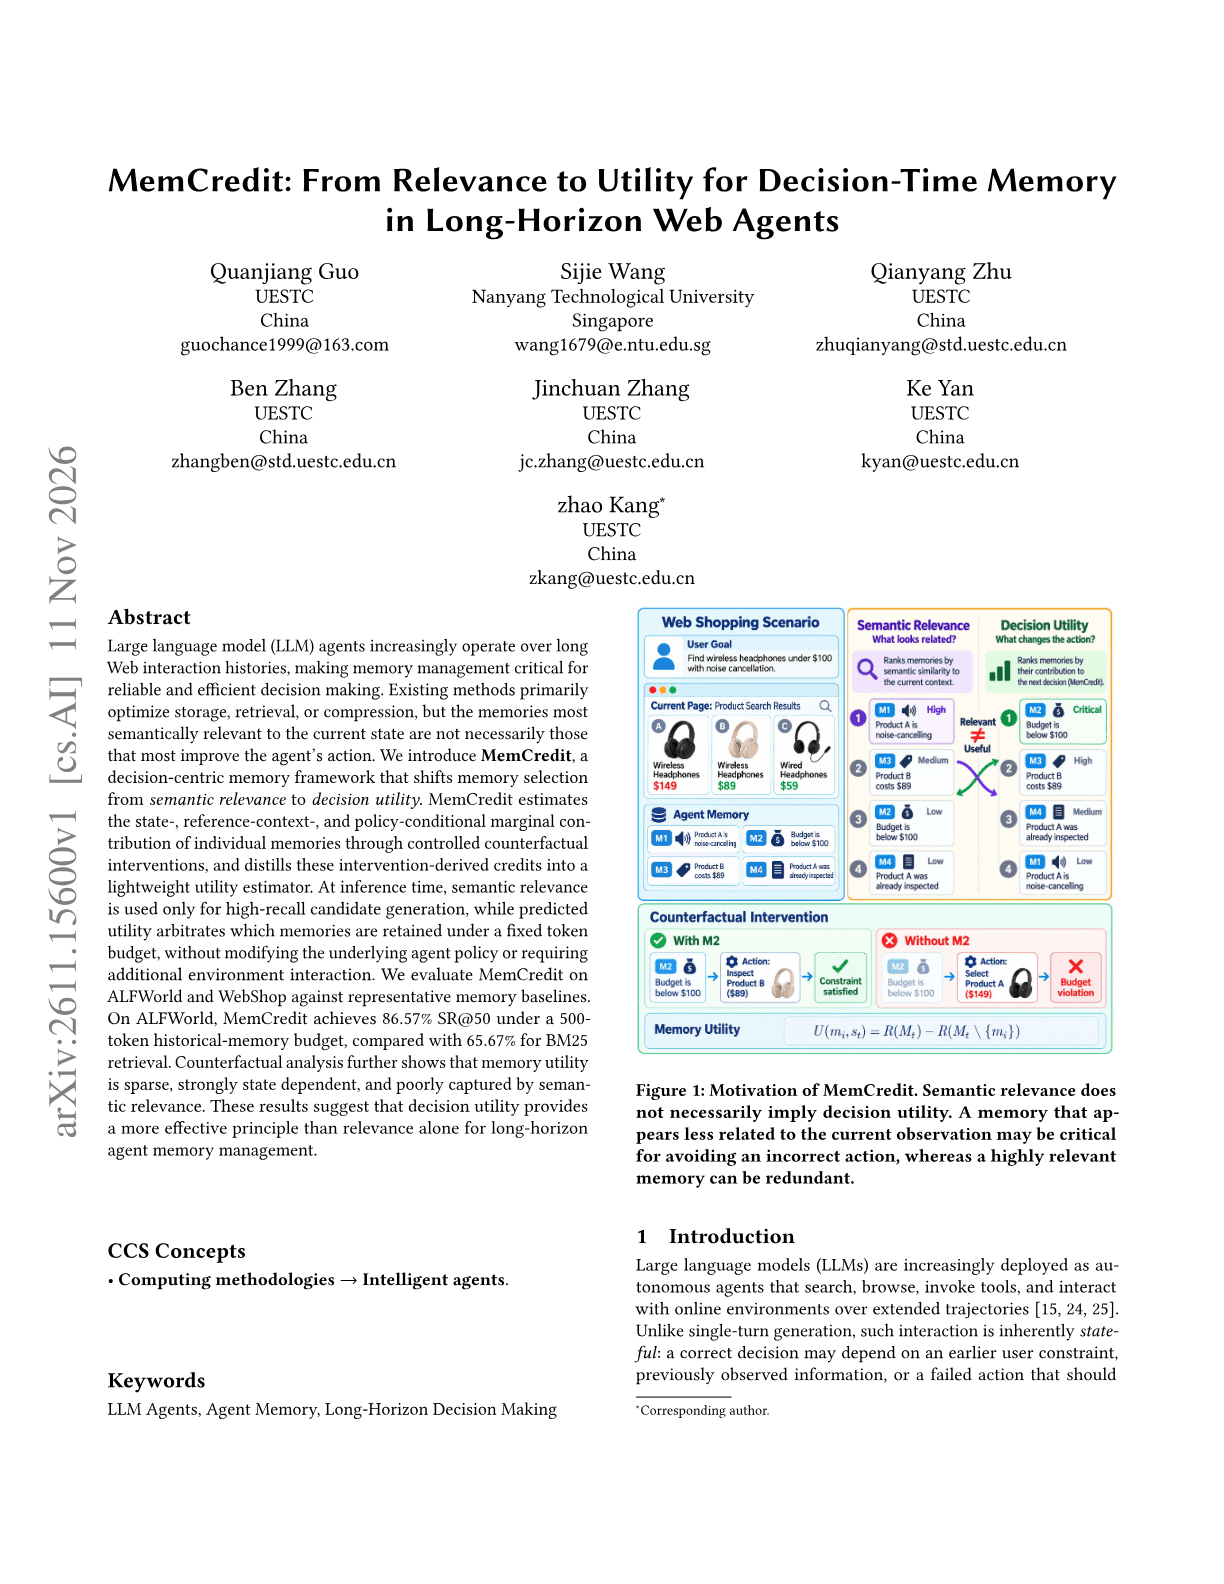
ALFWorld上的数字:500 token历史记忆预算,MemCredit成功率86.57%,BM25是65.67%。每次决策平均用152.1个记忆token,比BM25少74.5%。DAIR.AI Academy的论文页补充,750 token时到90.30%,比MemArbiter少64.4%记忆token。论文在ALFWorld和WebShop上评估,公开摘要主要给了ALFWorld对比。
数据侧面更反常识。论文的分析说记忆效用稀疏、强状态依赖,语义相关性抓不住。X用户Saeid Sisakhti从论文里拎出一组数:失败状态下记忆平均效用0.176,其他状态0.029,基于1041次ALFWorld干预。一个便宜策略由此浮出来:失败后多花记忆预算,平时保持精简。但他也提醒,换成GPT-5.4做policy时,BM25在SR@50上反而略胜。
评论里追问最多的是成本。Adam Wang指出,credit来自对每条记忆做有它/没它的重跑,算力账单藏在这里。ellipsis问组合效应:一条记忆只在和另一条配合时有用,逐一消融会不会把它判成废料。Blum和Giacomo Masseroni也在问干预数据和rollout数量。论文说推理不改policy、不额外跑环境,训练阶段的反事实数据仍要花成本。
另一个来自实践的类比更扎心。MJ说做编码智能体时,最相似的记忆常是上次撞到同一个错误,于是智能体重复同一种失败修法。按这条记忆有没有带来好的下一步排序,比按像不像排序更管用。这个观察和论文方向一致,也解释了为什么有些记忆看似高度相关,实际只是把智能体按回原地。
论文链接:https://arxiv.org/abs/2611.15600
Chat with Paper:https://academy.dair.ai/papers/memcredit-from-relevance-to-utility-for-decision-time-memory-in-long-horizon-web-2611.15600
判断可以放小一点:记忆管理从找相关转向算作用,方向清楚,但效用依赖状态、策略和记忆组合。训练干预成本、跨环境迁移、组合credit的算法,都会决定它能不能从ALFWorld走到真实网页任务和编码任务。至少现在,语义相似度不该独自决定记忆预算怎么花。
发布时间: 2026-11-15 03:25