always-on agent 大部分时间在睡觉。叫醒它之后的事,指南没写完
Anthropic 给 always-on agent 拆了五个模块:事件收件箱、定时器、精简记忆、无人值守权限、发件箱。架构很干净,但评论区里半夜那次连不上,才是这类东西真正要面对的部分。
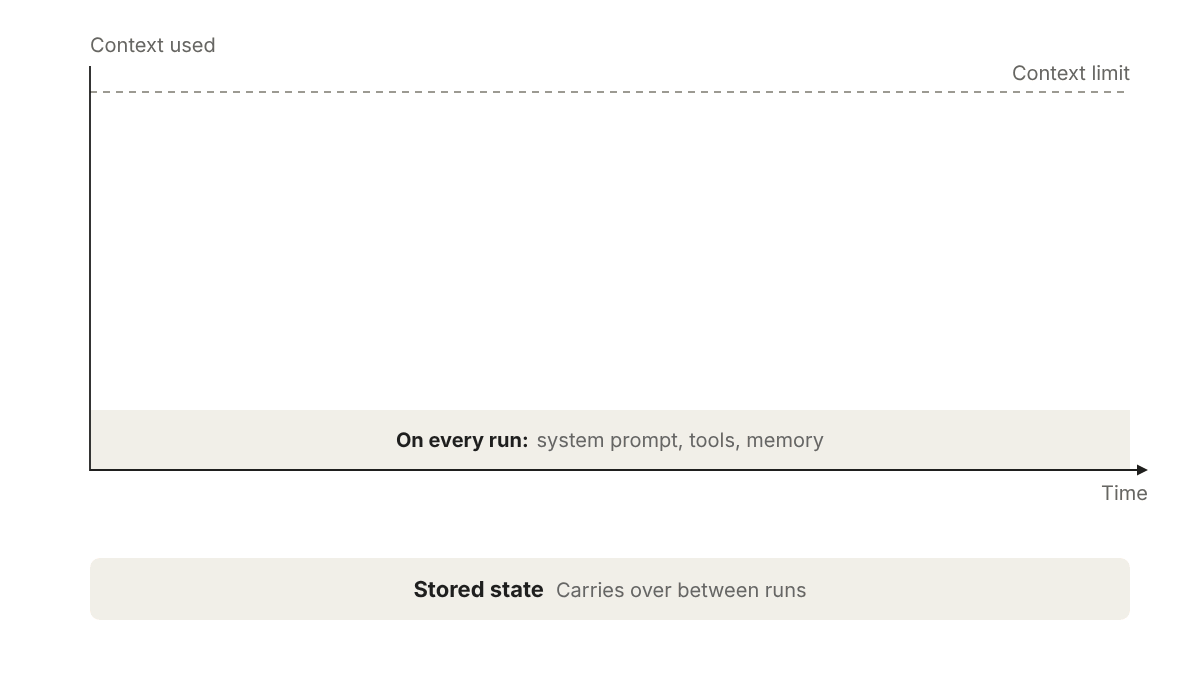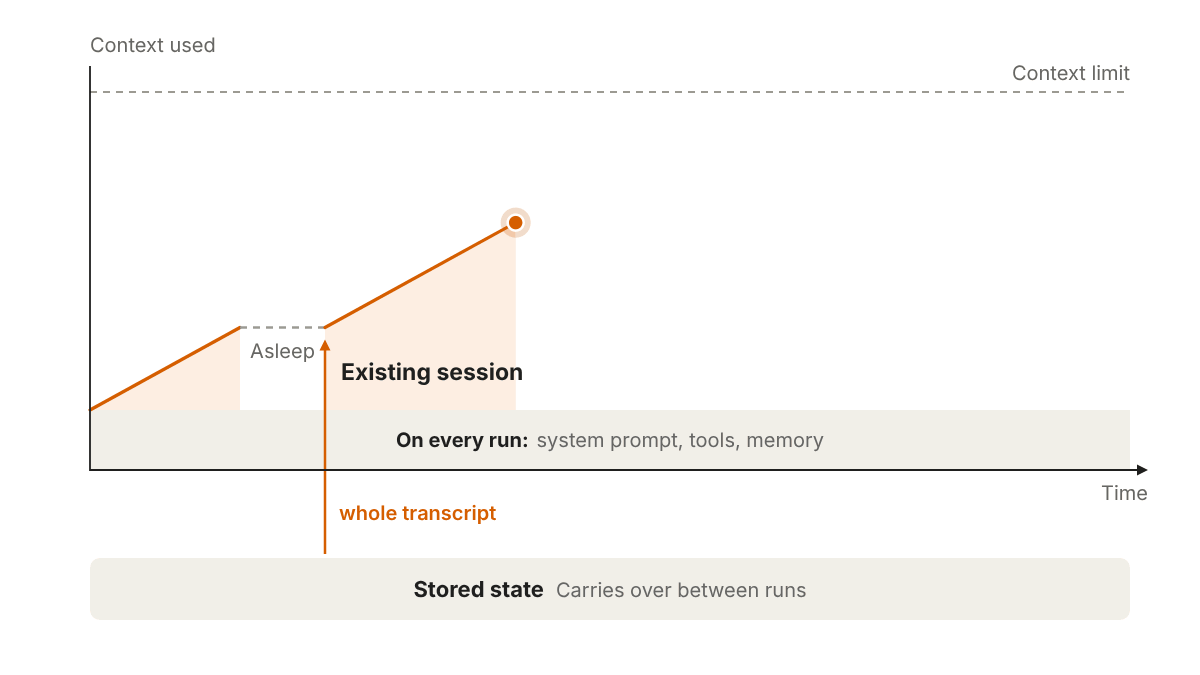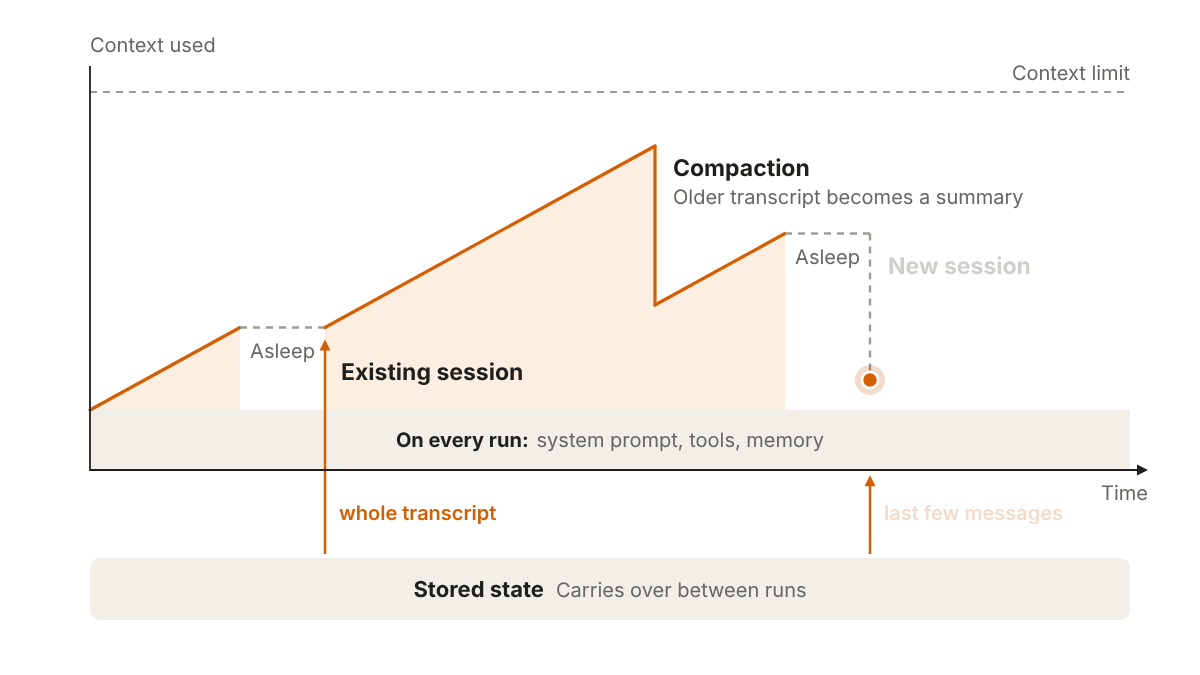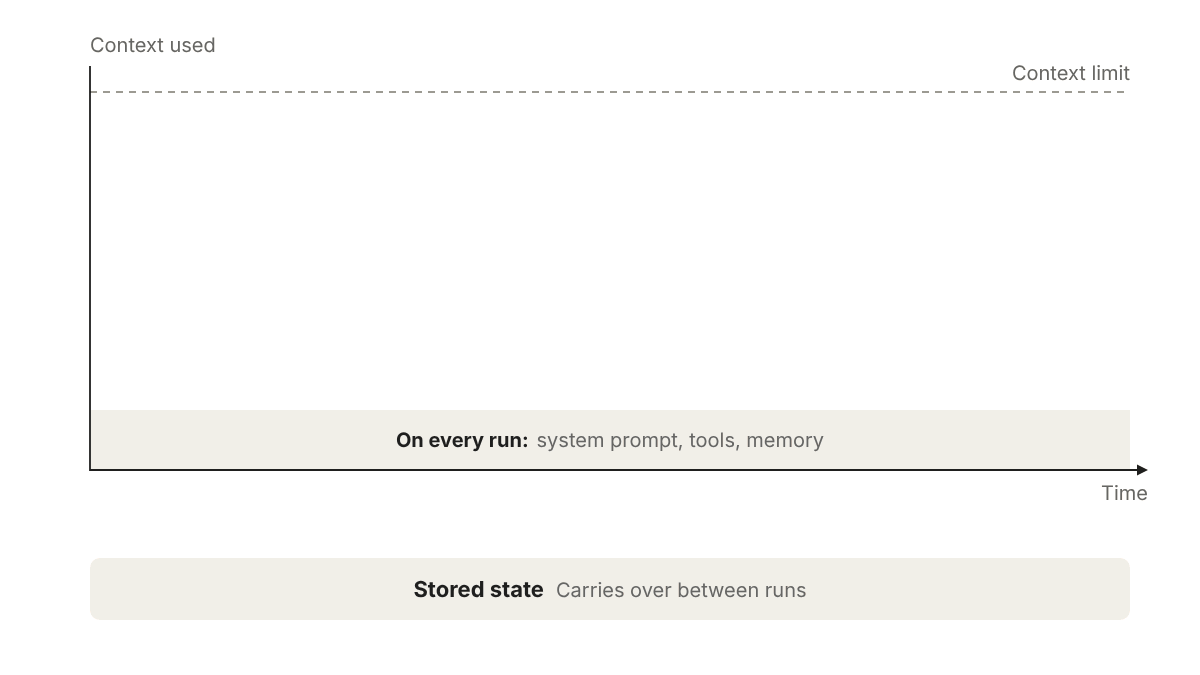
Anthropic 发了篇技术指南,讲怎么搭 always-on agent。何笠同学把要点整理了一遍,最值得先记住的一句是:always-on agent 不是 24 小时不停跑。它一天里几乎都在休眠,醒过来干一小轮活,把状态存好,接着再睡。
指南里把它拆成五块积木。
一、Event Inbox(事件收件箱)
webhook 和 agent 之间加一张数据库表。所有事件先写进表里,worker 从表里取。别让事件源直接调 agent,两个事件同时到会起两个 run 互相撞,worker 崩了事件也丢了。
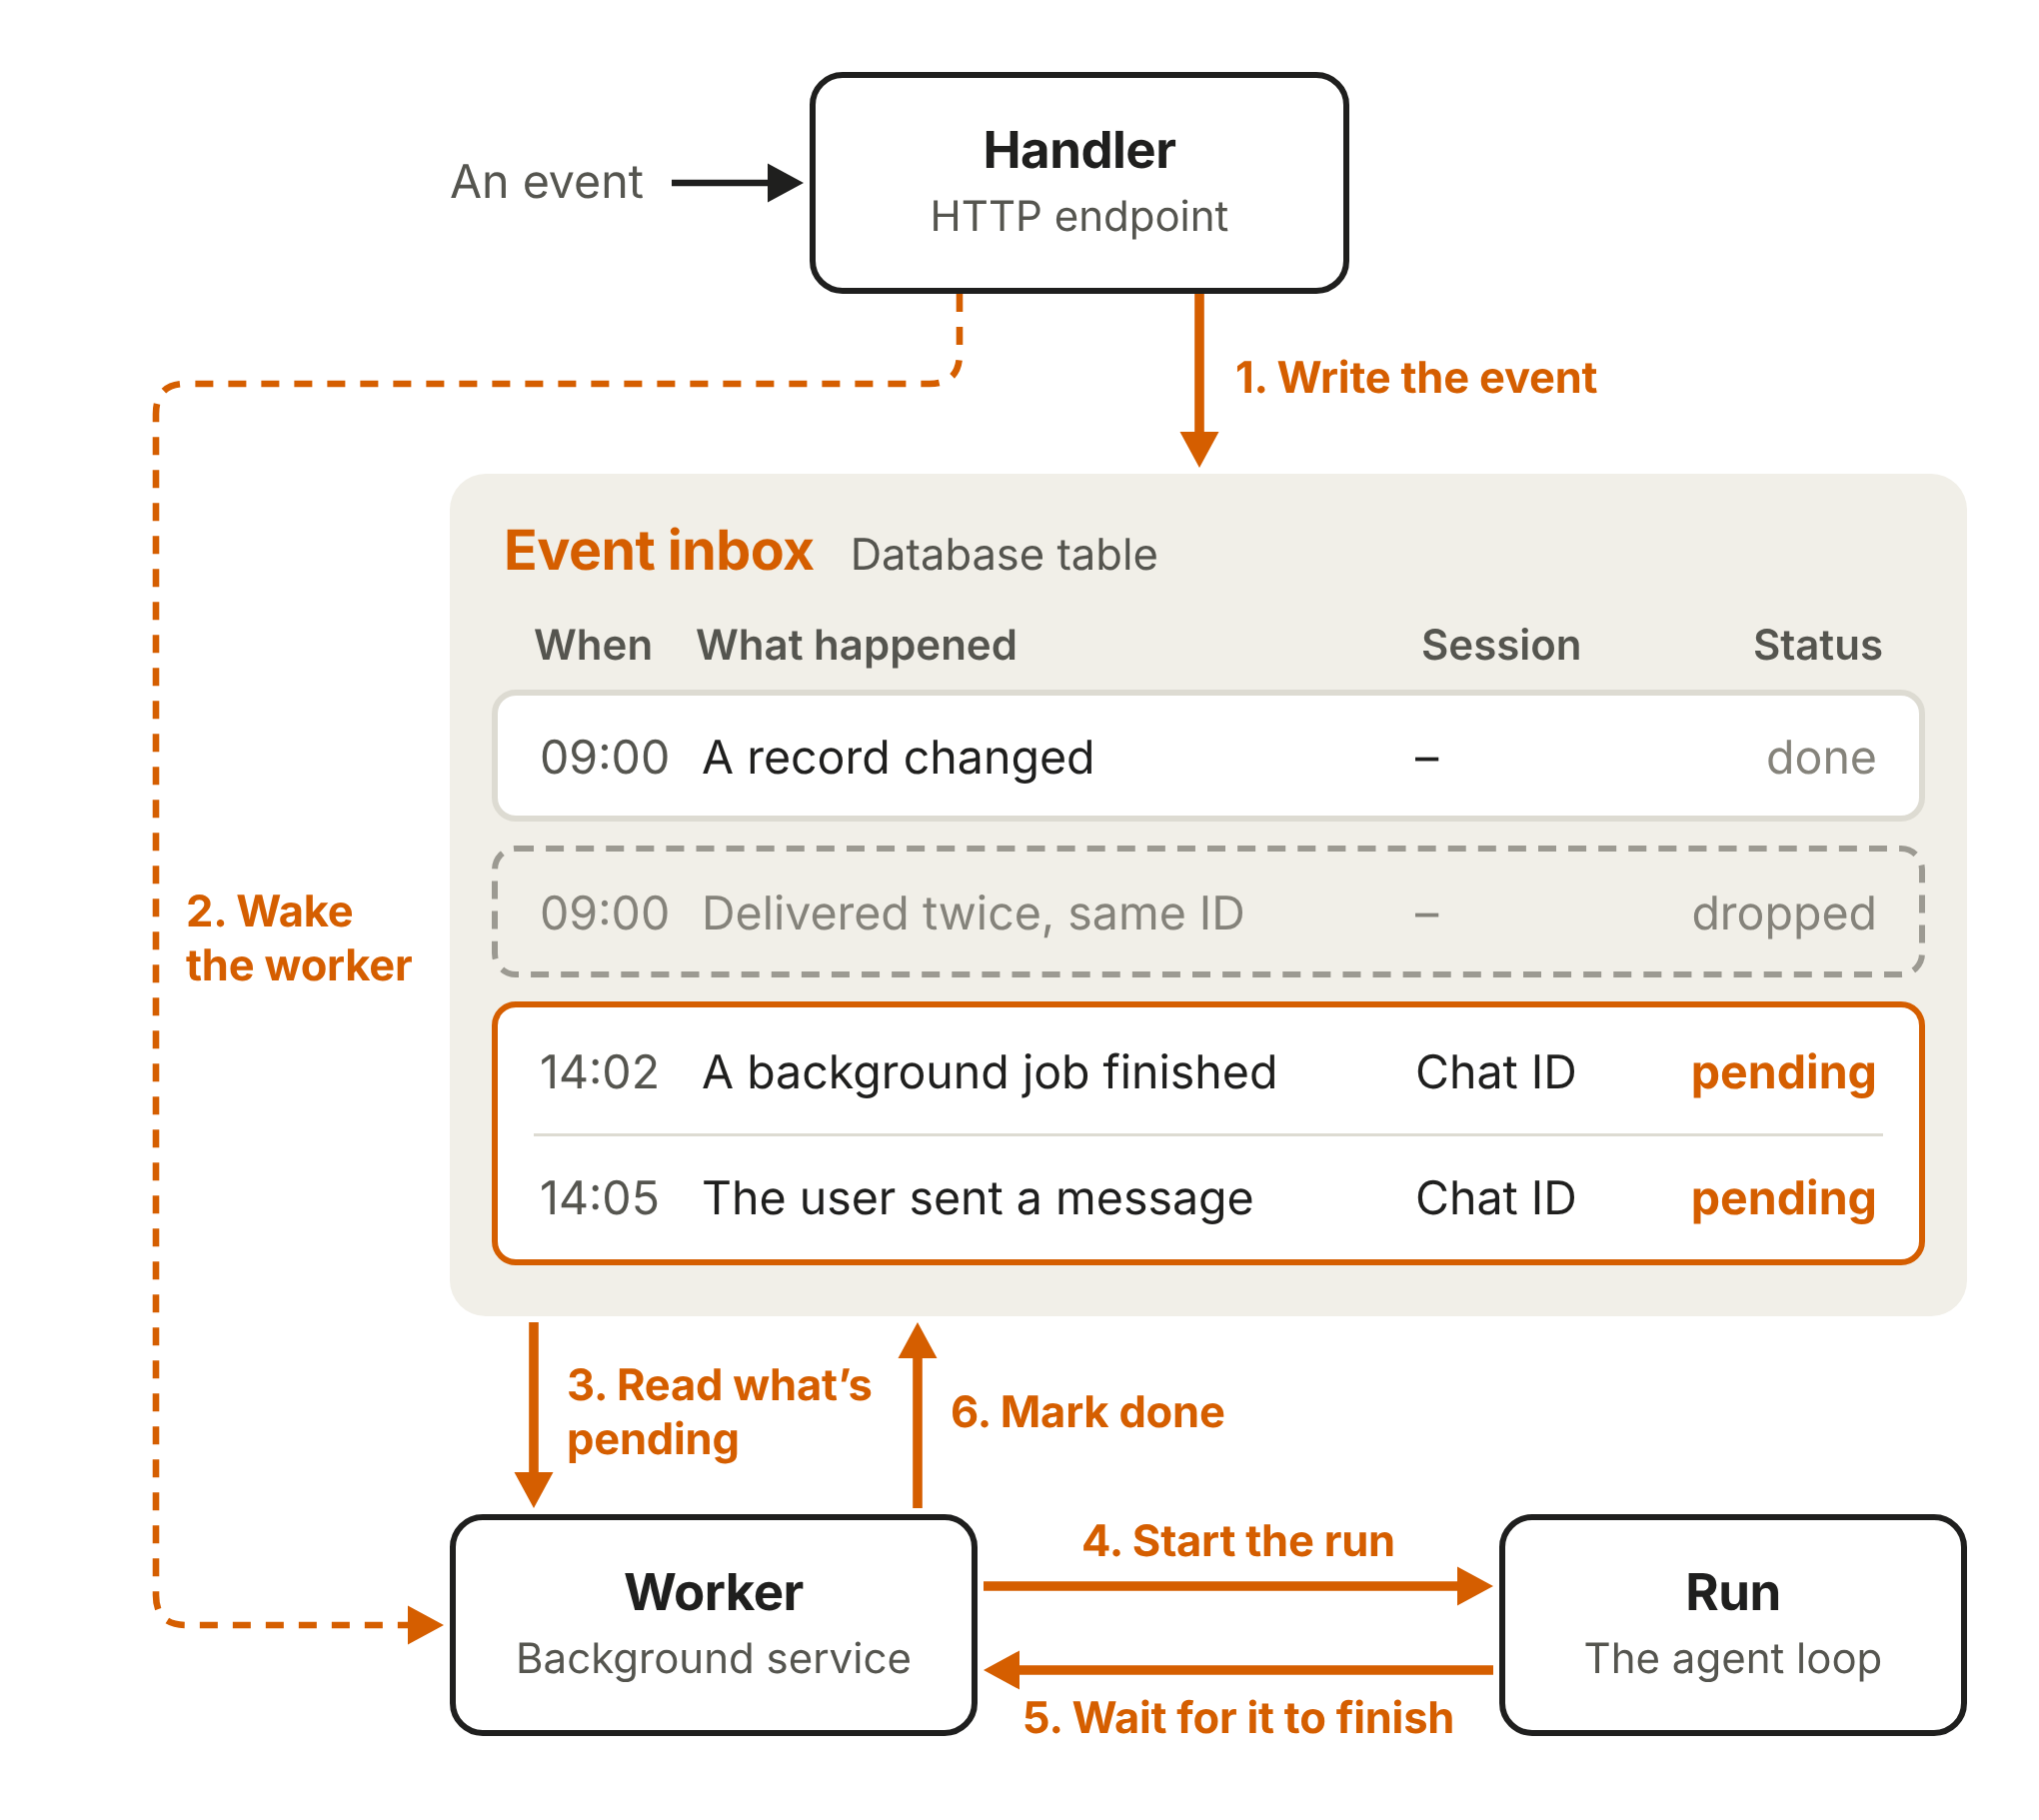
几个实操细节:handler 收到事件要尽快回确认,深度校验留到 run 里做;inbox 是唯一事实来源,worker 被叫醒先拉表里最新状态;同一个 inbox 同一时刻只开一个 worker;短时间里连续进来的事件合并成一个 run。有网友补充,连发两条 webhook 时,去重键落在消息 id 上比较稳。
二、Timers(定时器)
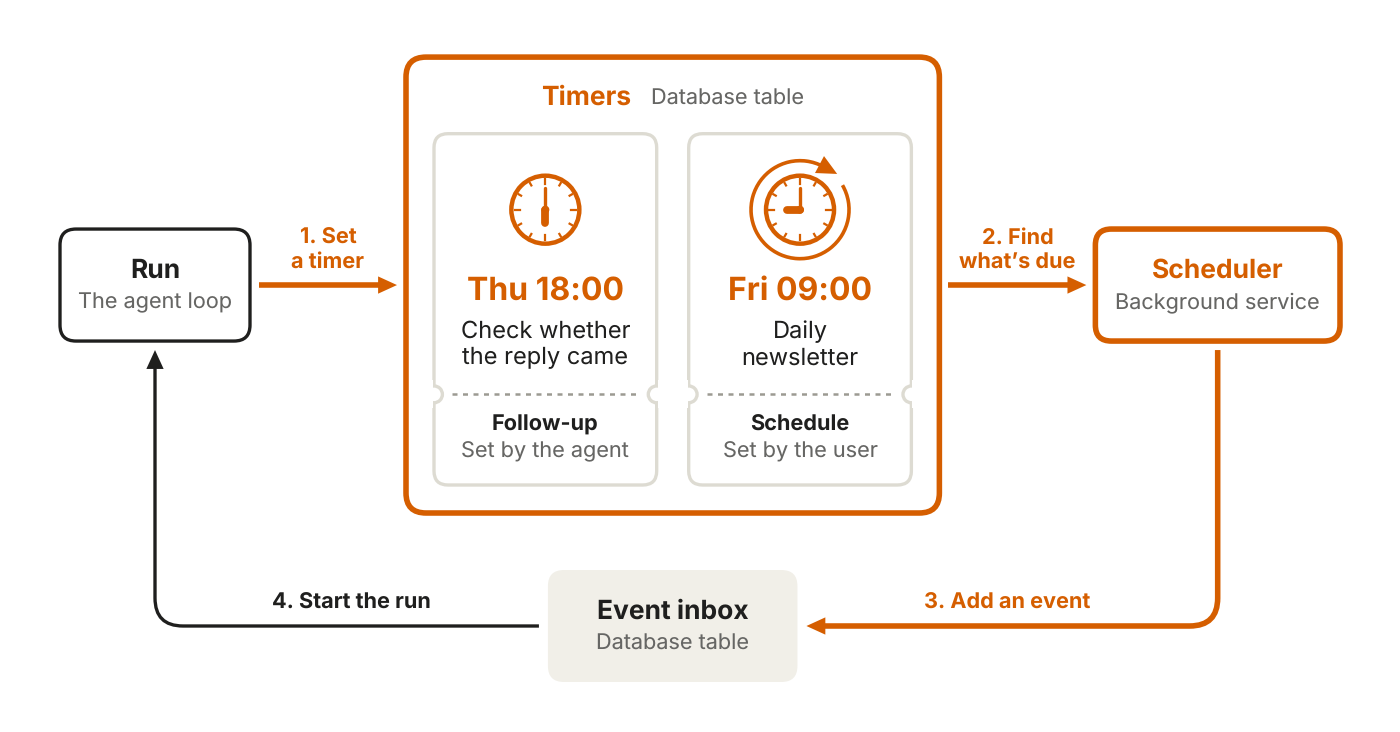
定时器单独一张表,不跟 inbox 混。分两类:单次跟进,agent 给自己定的截止时间;周期安排,用户定的重复任务。后台有个 scheduler 轮询,到期就往 inbox 塞事件。
三、Lean Memory + Dreaming
记忆只留没法重新查回来的东西:用户指令、用户笔记、过往消息、任务进展。如果在别处能查到,就存个指针,别复制。
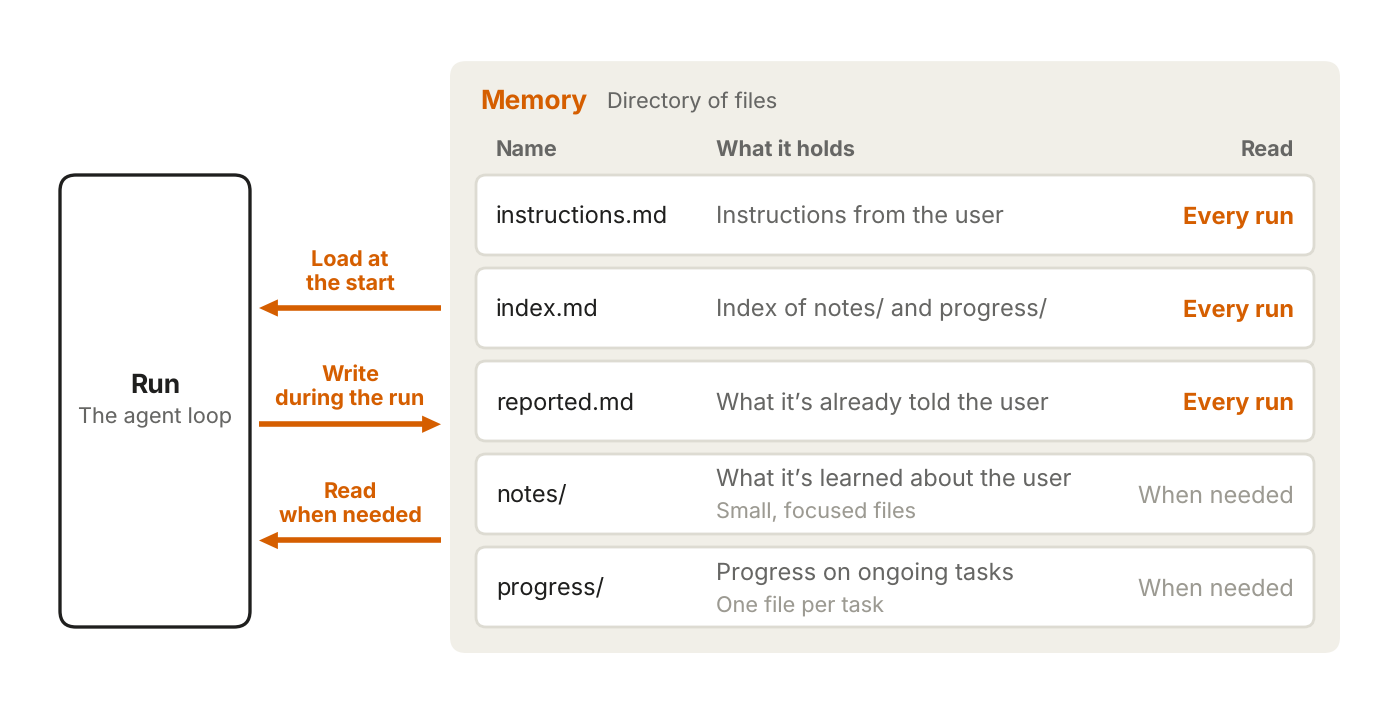
每次醒来先读一份短索引,需要细节再翻具体文件。跑久了还会做 dreaming,清掉过时内容,找跨多次 run 才显现的模式。评论区网友副驾本人分享了自己的做法:index 就一个文件,每条笔记占一行,带日期和来源文件,开工时自动检查过期。Dominik 提到,只读短索引而不是把所有文件塞进来,能省很多 context。
四、Unattended Permissions(无人值守权限)
原始 API key 别直接放进 agent 沙箱,外面套一个 proxy,发请求时注入凭证。遇到高风险动作,用 Deferred Tool Calls 停住等人批准,run 结束、session 存好,用户答复作为新事件回来接着跑,worker 不用干等着。
五、Outbox(发件箱)
回复先排进队列,由 dispatcher 按节奏投递。让 agent 自己掌握推送快慢,别凌晨三点把人刷爆。
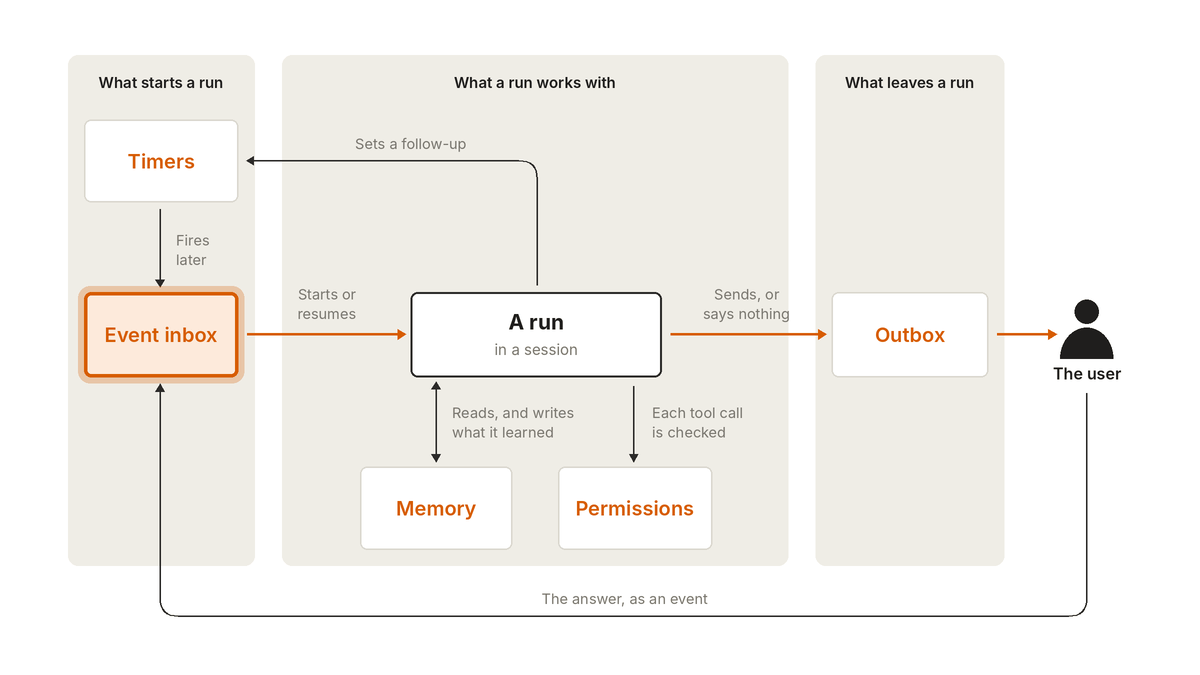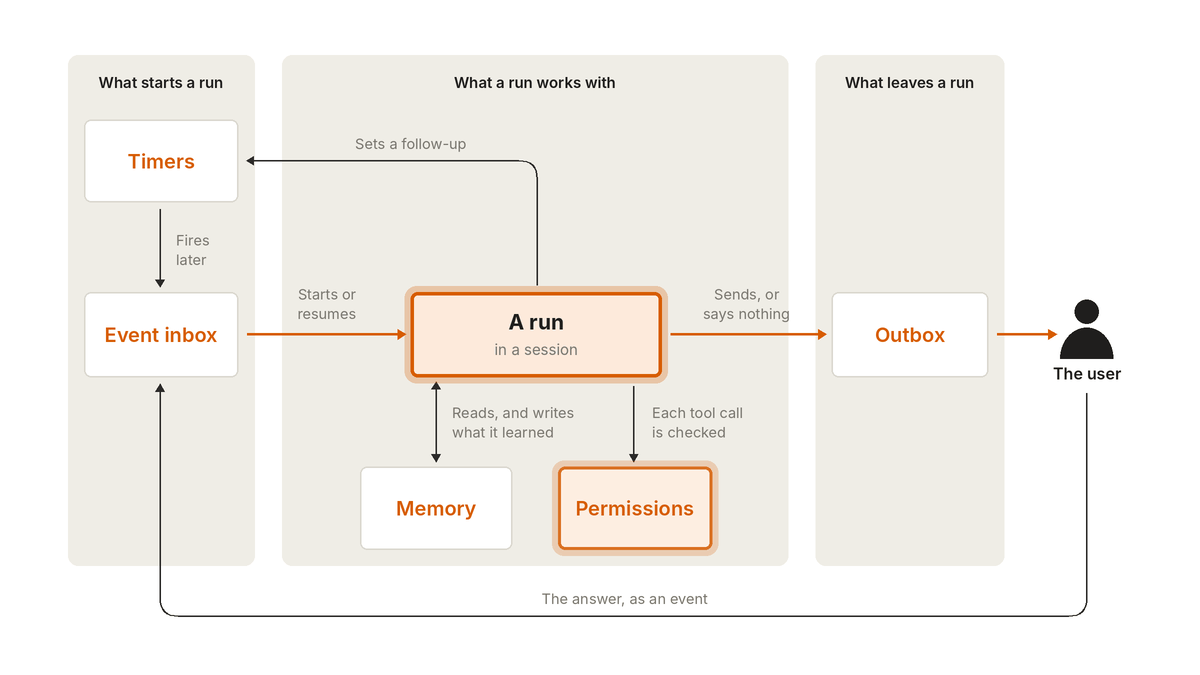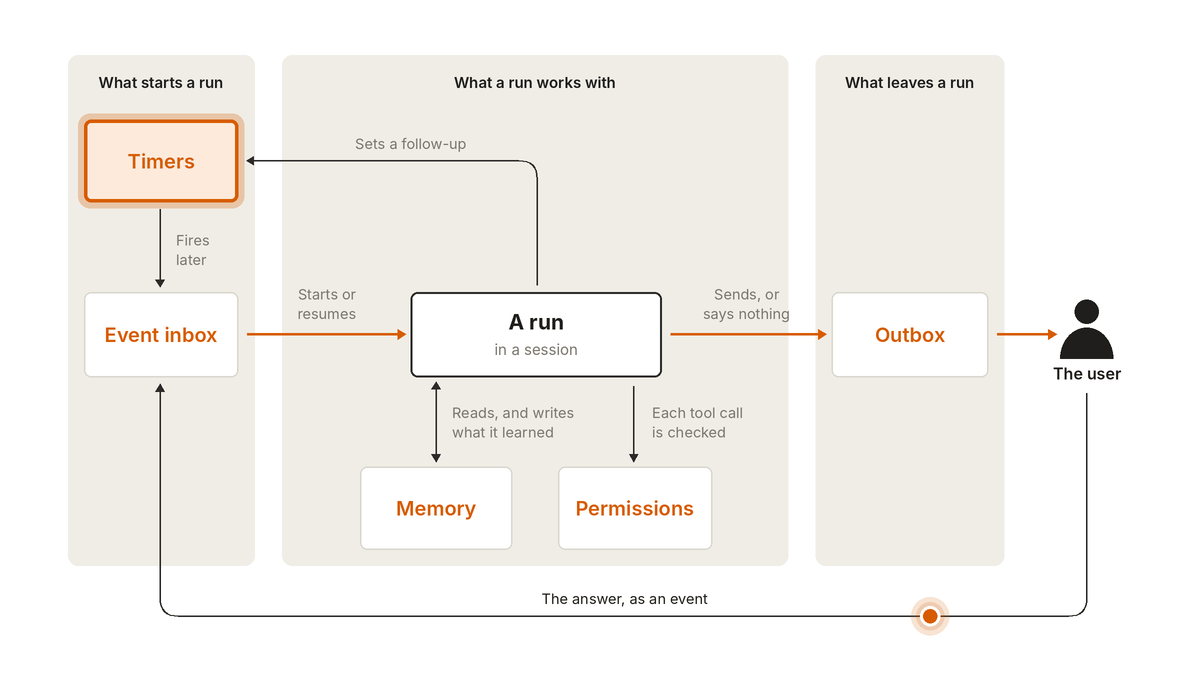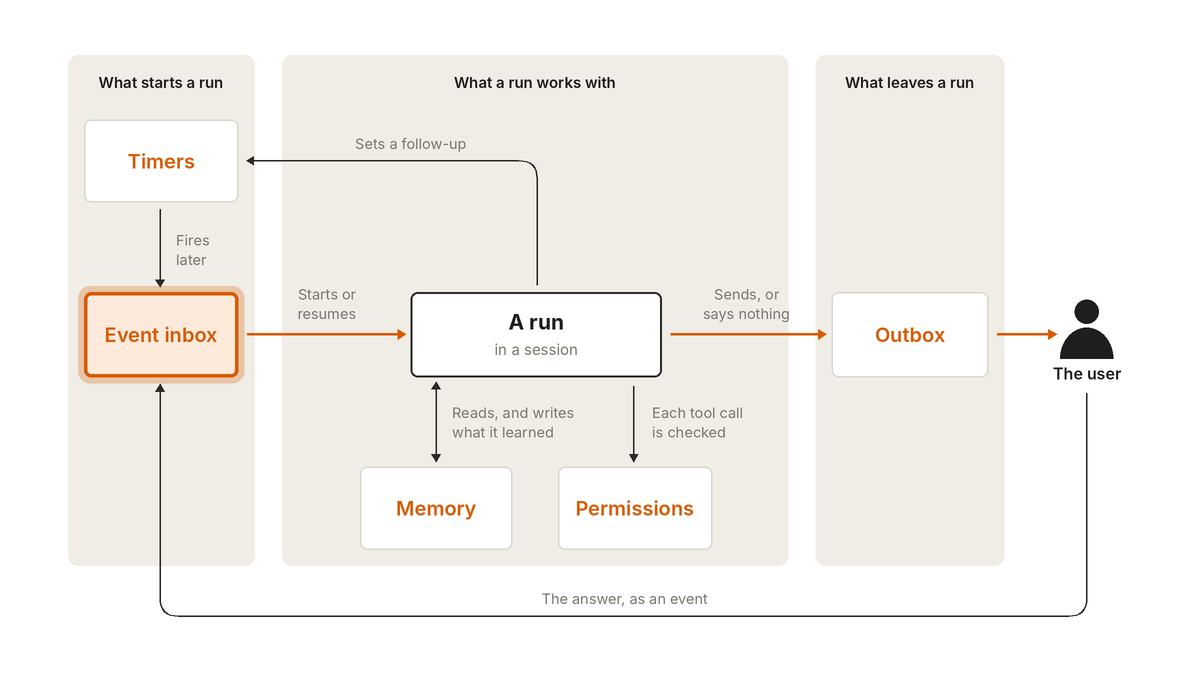
架构图很干净。但评论区已经有人遇上了文档没写的那一段。
网友云之子说,半夜零点那轮醒了,服务拒绝连接,连试三次。存下来的还是四天前的成功记录,错误是空的。早上看板只显示还没确认。
这段比指南里任何一张图都接近日常。五个模块描述的是跑通之后的样子,真正磨人的是没跑通的那一刻:状态有没有落盘、失败有没有留下痕迹、重试会不会重复干活。Kevin Lin 说得直接,状态保存才是关键,中断后能不能接着做、失败消息能不能找到,比表面上一直在线更影响日常体验。
老王实验室补了另一个角度:会睡觉只是省钱,醒来知道这件事还用不用做,才像个助手。半小时前排队的提醒,用户可能自己已经办完了,照旧执行反而添乱。Inbox 除了接任务,最好也能接住取消和改主意。
这一周 GitHub 涨星榜里也有几个项目在处理同一类问题。herdr 把断线重连做成了卖点,长任务真正麻烦的是重新连上之后分不清还在跑还是得重来。claude-mem 把对话记忆带到下一次。排第一的 security-audit-skill 让独立的 agent 交叉核实查找结果,找问题的 agent 和验证问题的 agent 不是同一个。
它们各自补的,是模型之外的那层东西。always-on agent 难的地方,不是让它醒着,是让它醒来之后知道发生了什么,还有什么没发生。
发布时间: 2026-11-15 08:36