AI工作流做路由,124M模型反超9.4B,靠的是不生成文本
decision-cascade 把 AI 工作流里的路由、分类、打分从生成文本再解析,换成输出类型化概率。本地 124M 模型在 AG News 上 0.873,p50 延迟 10ms。开源,但默认决策头是随机初始化的,想用还得先训练或下载权重包。
给 AI 工作流加路由、分类、打分,现在的默认做法是让 LLM 生成一段话,再用正则或 JSON parser 把结果抠出来。多一层解析就多一层脆弱,换个模型、改个提示词,parser 可能就得重写。
decision-cascade 走另一条路:不生成文本,直接输出类型化决策。
输入是一个状态字符串,经过 encoder 拿到特征,再分别喂给几个训练好的决策头,输出三种结果:
- Noul:是/否的概率
- Choice:给定选项上的分布,argmax 就是选择
- Score:给定等级上的加权分数和分布
每个结果带 confidence 和 schema_version,客户端按契约校验,不用解析自然语言。作者 Dan Kornas 在推文里说得很直接:你的 agent 要的是一个决策,不是又一段生成的段落。
本地优先的级联是它的核心设计。低置信度的问题升级到外部 SystemOne 兼容模型,剩下的本地解决。GitHub 上放的两个 demo 把这个机制做得挺直观。
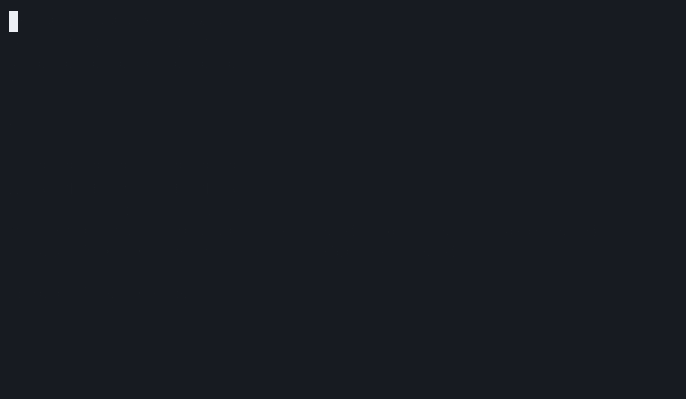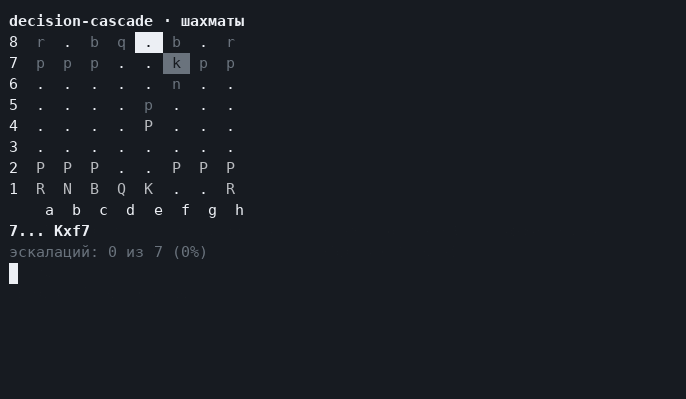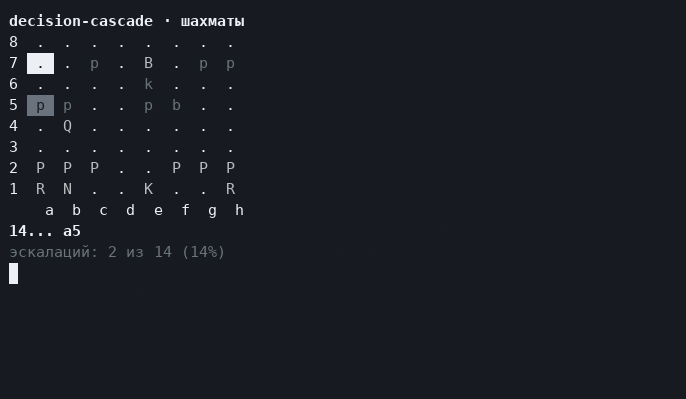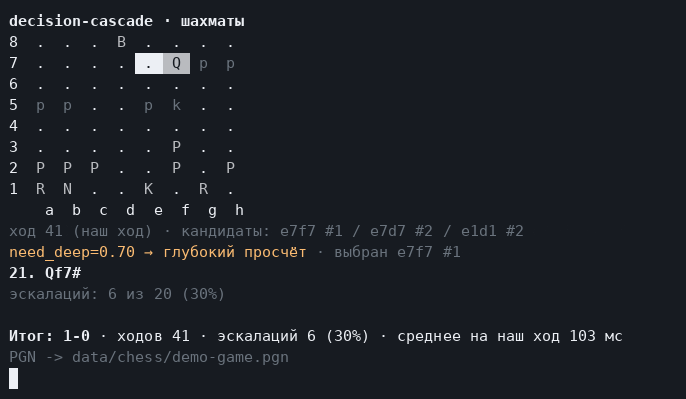
国际象棋对 Stockfish:19% 的升级就能补上到“总是深度搜索”差距的一半,代价是完整计算的 38%。
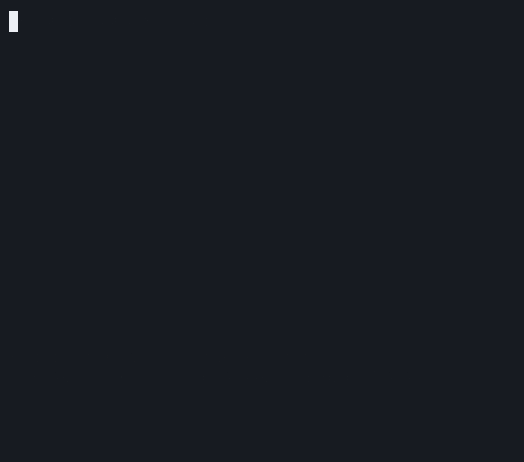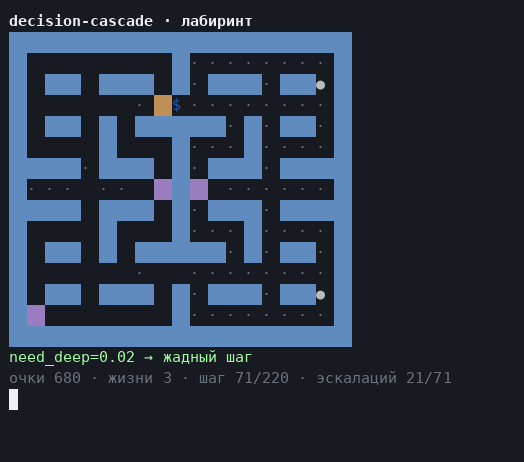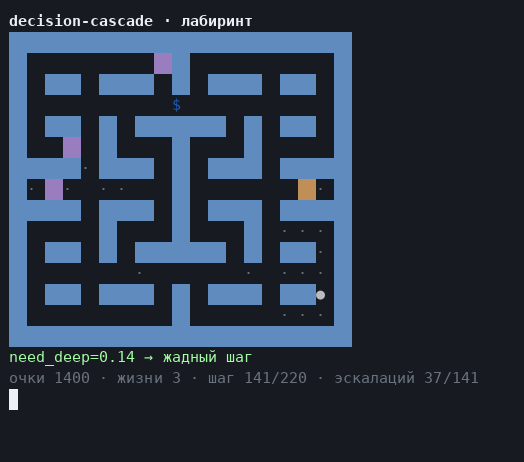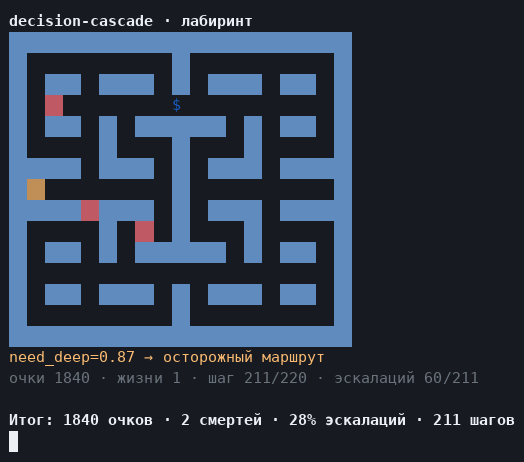
迷宫游戏:谨慎策略拿到 94% 的分数,用了 33% 的升级,是贪心策略的两倍。
公开数据集上的数字值得看一眼。一个 124M 的模型(gpt2 + 决策头)对上 9.4B 的 Clef-Flash 和 421M 的 Laya:
| 数据集 | decision-cascade 124M | Clef-Flash 9.4B | Laya 421M |
|---|---|---|---|
| AG News accuracy | 0.873 | 0.855 | 0.662 |
| AG News p50 | 10ms | 130ms | 16ms |
| RouterBench accuracy | 0.542 | 0.442 | 0.312 |
| RouterBench p50 | 21ms | 170ms | 27ms |
作者自己给了个诚实注解:RouterBench 的标签是反事实的,“always yes”这种平凡策略就有 0.775 准确率,所以看的是参与者之间的相对差距,不是绝对值。
校准方面,温度缩放把 AG News 的 ECE 从 0.144 降到 0.024,RouterBench 从 0.547 降到 0.024,准确率不变。不做校准的话,头输出的 confidence 接近 1.0,级联根本不会触发升级。
一个重要 caveat,作者在推文里专门提了:默认决策头是随机初始化的。仓库里说得更清楚,干净的 clone 之后就是随机头,要做有意义的决策,得自己训练(SFT + RLCD),或者下载 release 里的权重包。v1.5.0 的包里包括 support-gpt2(0.926)、public-gpt2(0.880)、routerbench-gpt2(0.548)。
快速上手两分钟:
pip install decision-cascade
python -m uvicorn api.server.main:app --port 8000
默认起的是 hash 编码器,不需要 GPU,不用下载模型。发一个请求:
{
  "state": "Stripe checkout has been failing for 3 days, we are losing revenue",
  "questions": {
    "urgent": {"type": "noul", "instructions": "Is the customer reporting urgency?"},
    "team": {"type": "choice", "instructions": "Which team should take it?",
             "options": ["billing", "integration", "sales", "support"]},
    "severity": {"type": "score", "instructions": "How upset is the customer?",
                 "levels": ["calm", "mild", "angry", "furious"]}
  }
}
返回类型化决策,带 trained: false 标记,因为默认头没训练。这个标记很关键,作者没有藏。
要拿到有意义的数字,得下载权重包:
gh release download v1.5.0 --pattern '*-weights.tar.gz' --repo slavabars/decision-cascade
然后指定 encoder 和 checkpoint 目录启动。
级联有三种策略:阈值、风险预算、benefit。Benefit 策略会先问“值不值得调外部模型”,如果外部模型在这个问题上不如本地,它就不升级。还有一个 conformal 模式,给的是错误率上界保证,覆盖率会保守一些。
风险预算这个设计值得单独说。confidence = 0.6 不等于“60% 正确”,它单独训练了一个 P(错误) 的估计器,你给的是“能接受多少错误率”,而不是一个抽象阈值。
推文回复里有人提了一个补充:把“弃权(abstain)”也作为一种输出类型。给模糊输入一条走人工复核的路,而不是硬塞进最近的标签。这个建议在工程上很实际,分类系统里最贵的错误往往来自“被迫选一个”。
Apache-2.0,本地跑,数据不出机器。如果你现在的工作流里有一段 prompt 专门用来做分类,后面跟一个 parser,可以把这段拆出来交给决策层。要注意的是,它不是开箱即用的 SaaS,默认头是随机权重,想用先得准备标注数据或者下载权重包。作者自己也是这么说的。
发布时间: 2026-11-17 07:26