Claude 写了九成代码,先让它交证据
Claude Code 团队把验证做成一套系统:端到端、属性、差分测试,加上一条硬规则,被检查的代码不能改检查。网友的补充更扎心:同一轮写出的测试,多半只确认了代理已经相信的东西。
Claude Code 团队大约 90% 的代码由 Claude 写和评审。这个数字来自 Addy Osmani 在 claude.dev 的文章。问题随之而来:谁保证这些代码真的能跑?团队的答案不是“相信模型”,是把验证做成基础设施。
验证循环决定你能同时跑多少个 Claude。没有它,你只能开一两个,因为每个 diff 都得自己看。有了它,几十上百个代理并行才有意义。内部测试里,结构化文件生成任务加一个独立评分器按 rubric 检查,任务成功率最多提高 10 个点,越难的问题收益越大。
过去昂贵的验证,比如测试、基准、规格、真实端到端运行,现在可以让代理快速生成。生成完的测试和基准作为软件反复运行,不再大量消耗 token。更关键的一步是闭环:如果代理反复挂在一项检查上,比如日志里出现用户数据,就加 hook 或在 CLAUDE.md 里写明确规则,让同类问题尽量不再发生。
三种测试,先找最难骗人的
如果只选一种,选端到端。它描述真实用户流程:加购物车、结账、到确认页。端到端难骗,因为整个功能要么能用,要么不能用;完成标准也明确。单元测试更快、更稳定,但可能全部通过,功能还是坏的。代理和测试都不理解完整任务时,这种情况很常见。
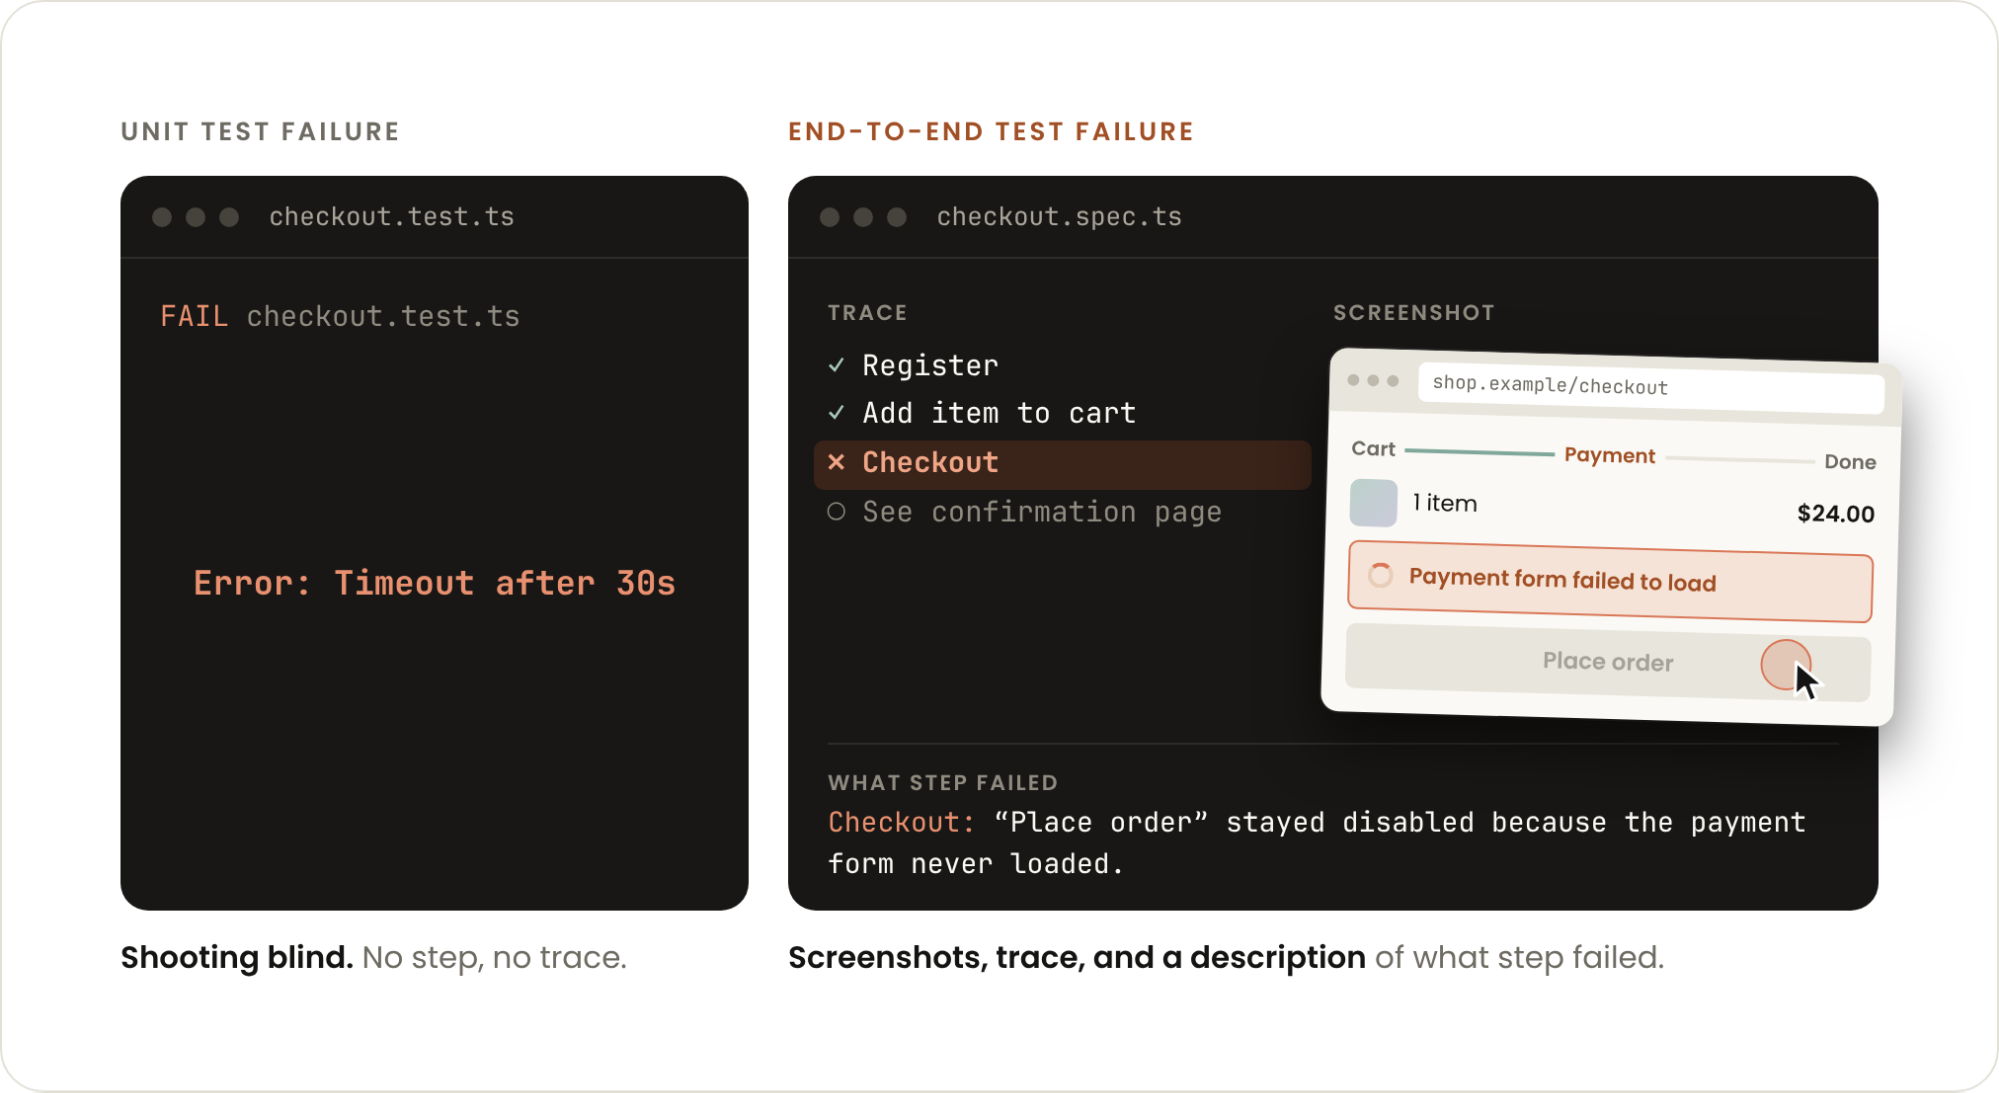
端到端测试可以给代理手和眼睛。用 skill 启动、驱动、检查真实运行的系统,工具可以是 CDP、模拟器或 API harness。功能地图则充当指南和评分 rubric,通常从用户视角列出路径、快捷键、选择器和预期结果。
属性测试盯的是人容易漏、代理也容易错的边界。先写一句你认为不可能失败的陈述,再用测试库生成成千上万个输入去证伪。常见属性有:编码后解码应还原;账户余额不能变成负数;迁移或重试做两次和做一次效果相同;优化后的代码和朴素但正确的代码结果一致。属性测试库的价值在于,它生成的边界不带着写代码代理的偏见。规格漂移、生产行为和文档对不上时,属性测试尤其有用。
差分测试适合大规模迁移。旧系统和新系统吃同样的输入,结果不同就说明有 bug 或破坏性变更。输入可以随机生成,也可以采样生产流量。还要归一化空白这类无关因素,并维护一份批准的差异列表,说明新环境本来就该不同的地方。
团队怎么防止验证变成自欺
Claude Code 团队把运行变更看得比测试更重。iOS 改动要在模拟器里跑,Web 改动用 Chrome 扩展,移动端用 iOS 或 Android MCP,桌面用 computer use,后端就在本地跑服务。他们把启动和运行方式写成 verify skill,放在仓库的 .claude/skills/ 目录,尽量靠近相关代码。提交前,Claude 会用它做冒烟测试。这个 skill 本身也要迭代和压力测试,得足够快、足够稳。
失败后的处理很清楚。Claude 跑检查并尝试修复。如果一项检查三轮后还挂着,Claude 停下来,交给人类。代码所有者写自己的检查,并调到能标出所有者会标的问题。检查拉人进来时,要说明原因,别让评审者从 diff 里猜。
他们还维护一份 39 项的可靠性清单,每项带一个能从 diff 读出的触发条件、一项检查和背后的故障或 PR。比如 --resume 加载旧 transcript。会话存储或消息类型变化时,就要问新字段能否安全加载,因为旧 transcript 没有它。Claude 读 diff,只检查触发条件匹配的项,通常 3 到 10 项。没人需要背下所有历史故障。
评审不靠堆人。加一个更贵的第二评审者,往往不如调好第一评审者。他们用 REVIEW.md 告诉评审者这段代码该注意什么。每轮评审和验证都接着上一轮的上下文和失败,不从零重查,更便宜,也能找到更多。
有一条硬规则:变更不能修改评判它的检查。Code Review 从 base 或默认分支读 REVIEW.md,绝不从 PR 的改动里读。规则放在变更改不到的分支上。评审锁 commit,评审进行时有人推送,结果就作废。便宜的检查先跑。代理在本地没测就推送,会浪费共享评审和 CI 时间。团队要求 Claude 开 PR 前跑测试、构建和 linter,可以用 hook 或 /goal 强制执行。
新检查先上观察模式。每个 commit 打上验证方式的戳,连 none 也打,方便查询没验证的提交。commit gate 有 off、observe、enforce 三档。观察模式只记录本来会被拦下的提交,用来复查误报。enforce 模式才真的拦。commit message 可以解释为什么没验证。一个会话里被拦两次后,下一次放行,避免 Claude 卡死。
他们还会评审评审者。追踪合并后被回滚的变更、维护者合并前拒绝的变更,以及大小匹配且保持干净的变更。评估按历史故障和回滚重建仓库状态,给一句话答案,只有正确描述 bug 的发现才得分。合并且稳定的变更作为控制组,防止过度标记。原始发现、验证后、最终评审的召回率分开看,避免系统丢掉已经找到的 bug。重要性也要分层:必须修、应该修、小问题。Code Review 会标 Important、Nit、Pre-existing。pre-existing 表示评审者不该让作者背旧 bug。召回率调到再往上就是过拟合评估,而不是真的抓 bug,就停。
漏掉的案例要变成规则。一种方法是从人工评审评论和 PR 回滚里提取模式。问题至少出现在两个 PR,且能从 diff 识别,才算候选规则。三个代理试着证伪,再由人在 PR 里评审批准。另一种方法是拿已知故障关联的 PR 回放三个 bug finder。至少两个找到,才算可检测。小 diff 上漏掉,就值得写进 REVIEW.md。flaky 测试同样处理。Claude 不能跳过、加 sleep 或重试到通过。找不到根因,就删掉测试并写下原因。规则也要清理。测试套件、验证步骤和 .md 文件只会膨胀,得定期修剪。
网友补了更扎心的一刀
有网友说,问题在于检查是谁写的。代理在同一轮里写代码又写测试,多半只确认了它已经相信的东西。另一个网友说,最信任的测试是代理不允许编辑的测试,否则它会让红色变绿的办法就是删掉断言。

有人描述自己的验证循环:Claude 说完成了,他问一句“你确定吗”,Claude 找到三个 bug。这个流程听起来像段子,但它说明验证不能只靠代理自报完成。还有网友说,单元测试曾经全部通过,因为测试和代理的 bug 达成一致;直到代理像普通用户一样使用应用,礼貌的谎言才停止。
失败三轮后交给人的东西也很关键。三个失败的 diff 是一团乱麻。一张说明,写清哪项检查失败、已经试过什么、为什么还卡着,人才接得住。
关于规则不能被改,有网友说这是最重要的一点。否则验证循环会变成代理优化的对象。规则放在受保护分支,用 CI 强制执行,在 Claude Code 之外也能做。

也有人提醒另一面:有网友说他们周末删掉了 75% 的测试。测试套件不是越多越好,坏测试会训练代理重跑,而不是修代码。慢测试会让代理减少批量检查,问题更难定位。
验证层要像别的系统一样对待。检查权必须独立。用真正在意的 bug 给检查打分。漏了就写规则。规则要修剪。做完这些,工作从读每个 diff 变成定义什么叫完成,以及看证据。你现在的验证循环里,哪一步是 Claude 能改的?这个问题比“它能不能写代码”更实际。
发布时间: 2026-11-17 10:28