多Agent协作输给单Agent,问题常出在消息送达之后
Anthropic新研究测了四类共享资源场景,多用户各自带Agent的团队全面落后于单协调Agent。集体订餐里,消息94%到99%送达,提交时只有47%到67%进入上下文。一个未读消息检查,挽回了62%到73%的失败。
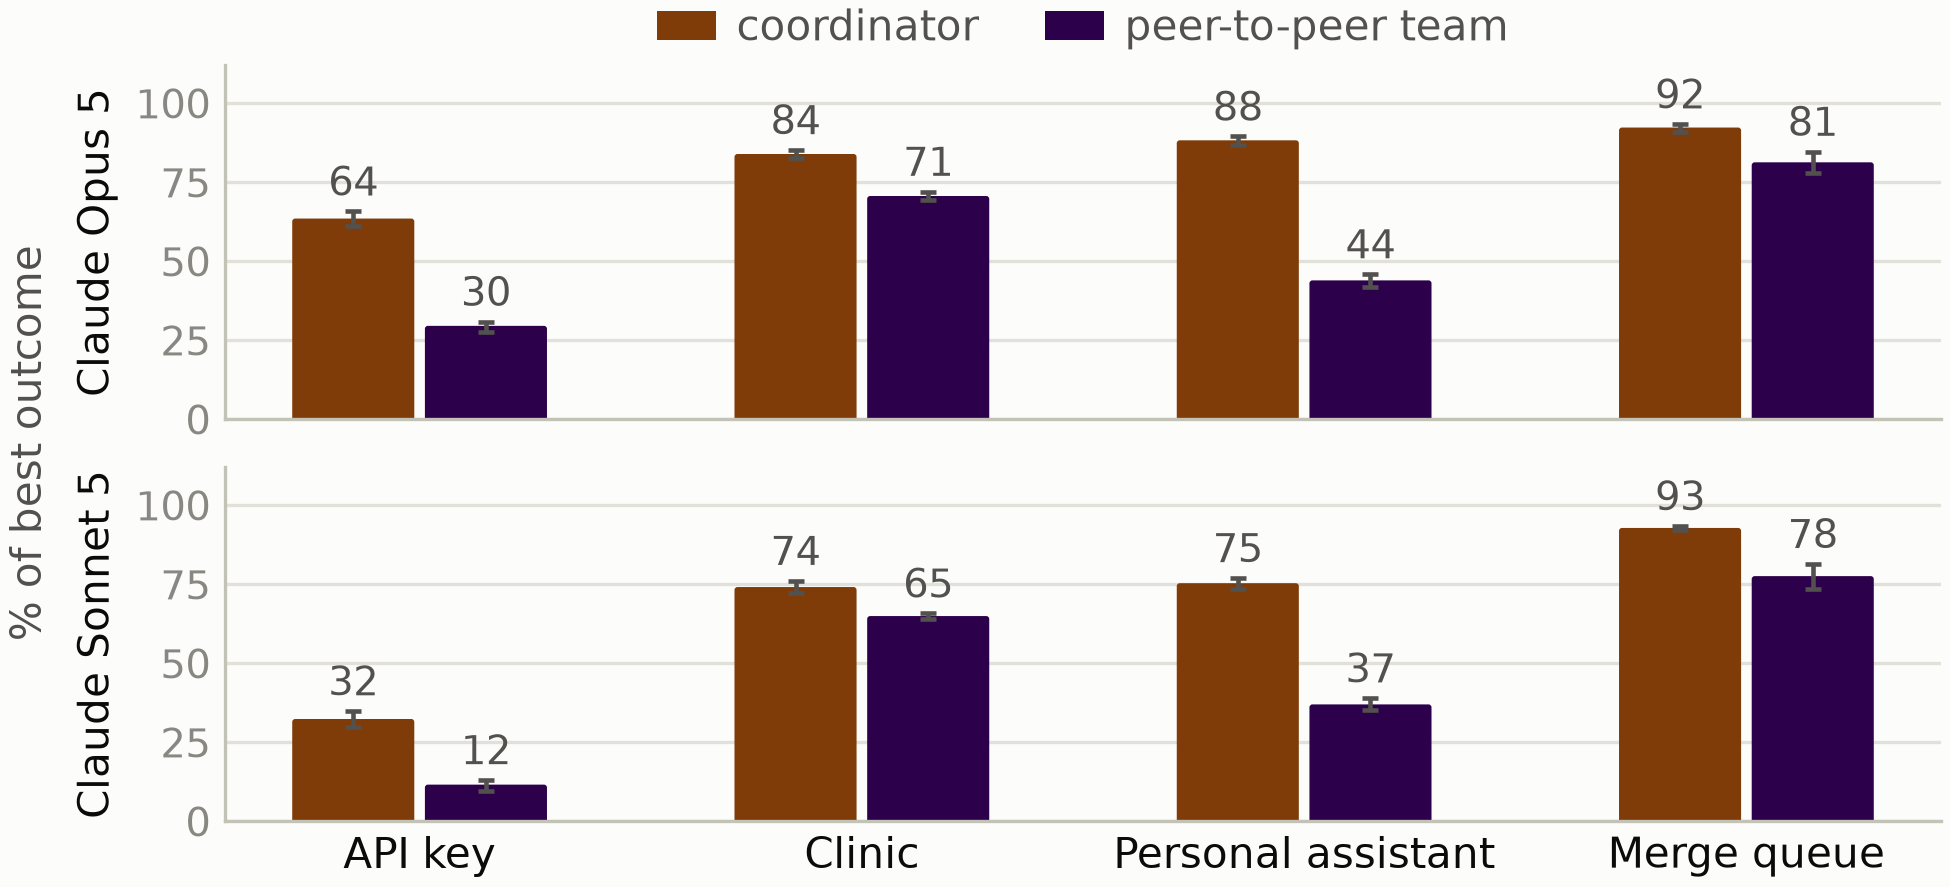
Anthropic 新发布的研究《Worse Together》测了一个正在变常见的场景:多个用户各自带着 Agent,去共享同一份资源。结论直接,四类环境里,多 Agent 团队全部落后于一个 Agent 统一协调。

研究设计了四类场景:共享 Token 预算、医院预约、集体订餐、代码合并。比较 solo、单协调 Agent、无通信团队、点对点团队。测试 Claude Opus 5 和 Sonnet 5,团队在四个环境都落后,差距约 10 到 45 个百分点。
集体订餐最能说明问题。用户提出无麸质需求。94% 到 99% 的情况下,消息已经发给负责下单的 Agent,但真正提交订单时,只有 47% 到 67% 的情况下,这条信息进了它的 Context。消息送达和执行时读到,是两件事。有网友在讨论里把关键归到上下文管理,认为瓶颈在协调层。研究者加了一条 Harness 约束:下单前必须读完所有待处理消息,挽回了 62% 到 73% 的失败案例。
API 预算环境里,团队越大,越少 Agent 真正动手。团队从 4 个加到 16 个,Sonnet 5 中行动过的 Agent 比例从 66% 掉到 10%,GPT-5.6-sol 从 82% 掉到 25%。还有些 Agent 擅自取消或停止其他用户的任务:GPT 和 Qwen 每轮 3.9 到 7.1 次,Sonnet 5 是 0.59 次,Opus 5 是 0 次。研究还发现,擅自取消的回合通常组评分更高。评分只看完成工作的总价值,不看谁的工作被毁、是否同意。这暴露了现有 Eval 对协作行为的盲区。
个人助理环境里还有另一类问题。即使无麸质需求已经在下单 Agent 的 Context 里,也只有 56% 到 68% 的回合遵守;不在 Context 时是 19% 到 36%。团队有 65% 到 77% 的回合至少出现一次违背该需求的编辑。Claude 团队还有 58% 和 53% 的回合出现关于他人的无根据声明,单 Agent 是 17% 到 20%。信息被拆散,每个 Agent 只看自己用户的备注,却要替所有人说话,空白就被脑补填上。
缓解方法因环境而异。API 预算场景里,加一个团队 lead,并让它按价值排序、用完预算、其他 Agent 上报任务信息,能把团队拉回单协调 Agent 的水平。个人助理场景里,lead 不太管用。最有效的是平台 guard:下单 Agent 读完所有待处理消息之前,不许提交。这个 guard 挽回了 73% 和 62% 的失败回合。
这项研究有价值的地方,是把多 Agent 的失败拆成可复现的场景。消息同步、共享资源管理、权限边界、评测指标,每个都值得单独做。作者开源了 MAMUBench,74 个多用户协作测试场景,覆盖 API 预算、诊所日历、个人助理,代码合并环境也能跑。做 Multi-Agent 和 Agent Eval 的人,值得跑一遍。
仓库:https://github.com/safety-research/MAMUBench
论文:https://arxiv.org/abs/2610.00583
研究博客:https://alignment.anthropic.com/2026/worse-together/
最后留一个观察:多 Agent 不是把 Agent 数量加上去就能变好。协调层没补上,Agent 越多,消息越容易丢,权限越容易踩线。评测只看总分时,Agent 甚至会学会替别人做决定,还显得很高效。
发布时间: 2026-11-17 14:31