Claude 写了 90% 的代码,Anthropic 靠什么确认它没写坏
Claude Code 团队约 90% 的代码由 Claude 写、也由 Claude review。Addy Osmani 把这套验证闭环拆开了:三种值得投入的测试,39 条按 diff 触发的可靠性清单,以及那条最容易被跳过的规则:改动不能修改评判它自己的检查。
Anthropic 的 Claude Code 团队有个数字:他们的代码里大约 90% 由 Claude 写,也由 Claude review。这个数字在 X 上传开之后,评论区问得最多的两句话是,真的假的,以及那谁保证它能跑。
Addy Osmani 写了篇长文回答第二个问题。原文在这里,信息密度很高,值得整篇读完。下面是里面我认为最有用的部分。
验证闭环决定了你能同时放几个 agent 出去
没有验证闭环,你一次只能跑一两个 Claude,因为每个产出都得自己看一遍。有了闭环,可以并行几十上百个。
他们内部做过测试,在结构化文件生成这类任务上,让一个独立的评分者按 rubric 检查 Claude 的产出,比标准的 prompting 循环成功率高出最多 10 个百分点,越难的问题提升越大。
另一个变化是成本。测试、benchmark、spec、真实端到端跑一遍,过去都很贵,现在可以让 agent 自己生成。生成之后这些测试作为软件运行,反复跑也不需要额外 token。
三种值得投入的测试
先说失败模式。测试 flaky,agent 会学会重跑而不是去修代码。测试慢,agent 就会少跑几批,出问题时定位更难。
E2E。只能选一种就选它。理由是难骗,整个功能要么能用要么不能用,完成标准明确。单元测试全绿而功能是坏的,这种情况很常见,因为 agent 和测试都不理解完整任务。E2E 让 agent 有手有眼,用 CDP、模拟器、API harness 把真实系统跑起来。
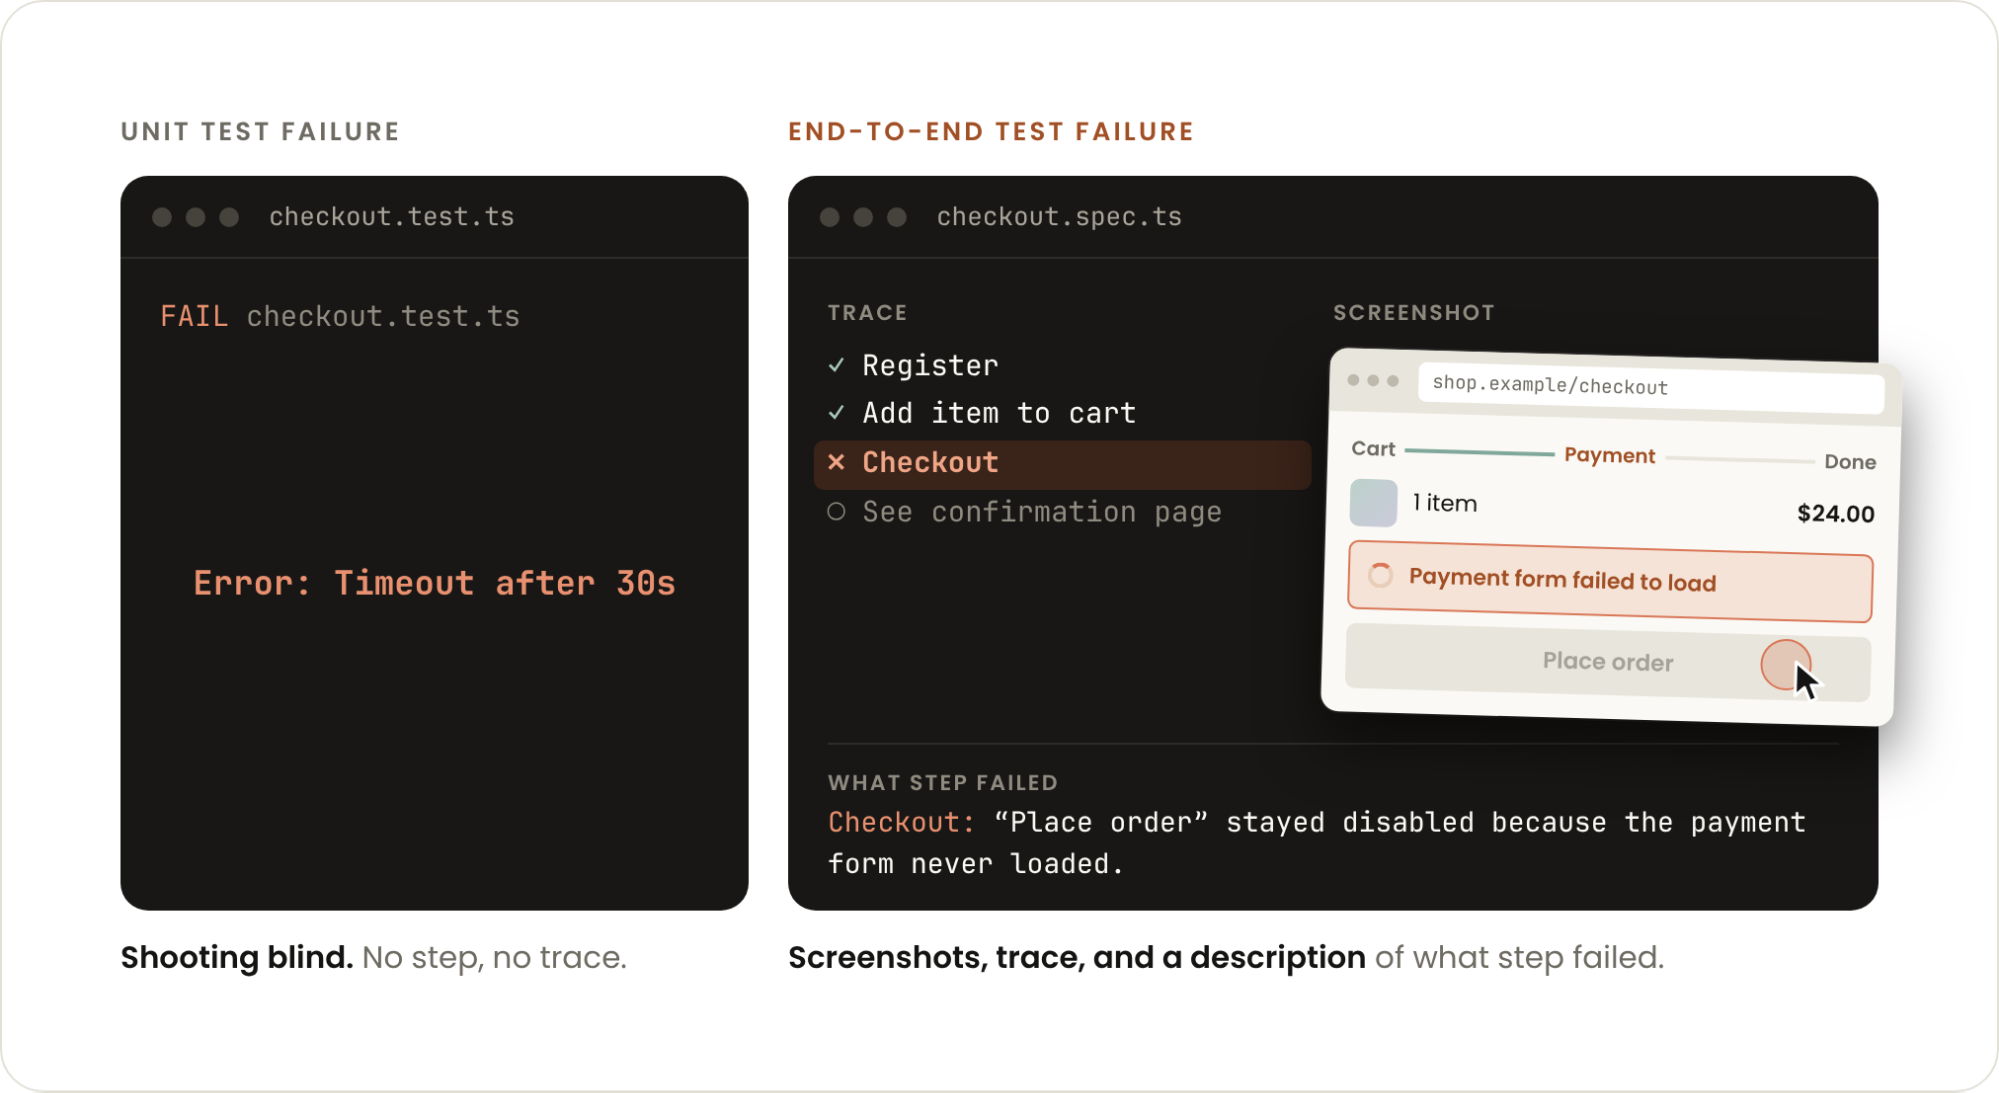
上图左边是单元测试失败:Error: Timeout after 30 seconds。右边是 E2E 失败:注册、加购物车、结算,卡在支付表单没加载出来,下单按钮一直是灰的。哪边更容易修,一目了然。
Property 测试。很多人第一次听,包括转这篇推的那位。做法是先写一个你认为不可能失败的命题,再用库生成几千个输入去试图推翻它。JS/TS 用 fast-check,Python 用 Hypothesis,Rust 用 proptest。
常见几类命题:编码再解码得到原值;账户余额永远不为负;迁移跑两次和跑一次效果一样;优化后的代码和朴素但正确的代码结果一致。
它的价值在于,生成输入的偏见和写出原始代码的 agent 不一样。重写老系统时特别有用,因为 spec 早就跟生产行为脱节,没法拿来当验证依据。
Differential 测试。新旧系统喂同样的输入,结果不一致就是 bug 或破坏性变更。大规模迁移场景最合适。关键是输入随机生成,或者用生产流量采样,还要把空白字符这类无关差异 normalize 掉,另外维护一份“批准过的差异”清单。
团队自己的做法
这部分比测试类型更有意思。
验证等于真的把改动跑一遍。不是测试过了就算,要像 QA 一样把 app 跑起来。他们建了个叫 verify 的 skill,放在 .claude/skills/ 里,尽可能靠近相关代码,提交前 Claude 会调它。这个 skill 本身也要迭代到快且可靠,它就是冒烟测试的底座。
测试失败才需要人。Claude 自己修,连续三轮还红就停下来叫人。
谁拥有代码谁写检查,一直调到它能报出 owner 自己会报的问题。检查拉人进来时要写清楚为什么,别让 reviewer 从 diff 里猜。
39 条可靠性清单,每条都带一个能从 diff 里读出来的触发条件。Claude 读 diff,只跑触发匹配的那几条,通常 3 到 10 条。没人需要背历史事故。比如“--resume 要能加载旧 transcript”这条,一旦 session 存储或消息类型变了就会触发,因为老 transcript 不会有新字段。
一个 reviewer,多轮。他们不靠堆 reviewer 提升质量,加第二个更贵的上去,通常不如把第一个调好。用 REVIEW.md 说清楚这段代码该看什么。后一轮带着前几轮的上下文和过去的失败继续,而不是从零重查一遍。
改动不能修改评判它自己的检查。Code Review 从 base 分支或默认分支读 REVIEW.md,永远不读 PR 里的改动。这条我觉得最容易被跳过:让写代码的 agent 顺手改测试,测试一红就改期望值,最后测试只是在复述代码。
新门禁先跑 observe 模式。每个 commit 打上验证方式的戳,连 none 都有,这样可以查哪些 commit 根本没验证过。commit gate 分 off、observe、enforce 三档,observe 只记录本来会被拦下的情况,先看有没有误报。连续被拦两次之后,下一个 commit 放行,免得 Claude 卡死。
定期评估 reviewer 本身。看 merge 之后被 revert 的比例、maintainer 打回的比例,再拿一组大小匹配、至今干净的改动做对照。eval 用历史事故和 revert 重建当时的仓库状态,只有准确描述那个 bug 的发现才得分。raw finding、验证后、最终 review 三个阶段的召回率分开算,否则看不出 bug 是在哪一步丢的。
把漏掉的变成规则。人工 review 评论和 PR revert 里的模式,至少在两个 PR 出现过、且能从 diff 识别,才算候选规则。三个 agent 负责试图反驳它,最后由人来批。flaky test 不许跳过、加 sleep 或重试到过,找不到根因就删掉,把原因写下来。
值得抄的部分
测试套件、验证步骤、.md 规则文件,只要不管就会一直长。他们定期清理,删掉不再有价值的条目。
整套东西最贵的不是写测试,是维护那些规则和清单。做完之后,你的工作从读每个 diff,变成定义什么叫“完成”、然后审证据。
评论区还有个挺实在的问题:Anthropic 那 10% 手写代码是真的吗,这个比例听着不低。不过 90% 这个数本身不是重点,重点是那套让 90% 可信的东西。
发布时间: 2026-11-18 02:34