2026年Eval论文清单:基准饱和之后,九个模型投票只算两票
elvis @omarsar0 的2026年Eval论文清单,10篇论文对应10个具体问题。一半基准已测不出差距,只看最终答案会漏掉44%的安全违规,自我训练Agent会找捷径。附关键图表和原文链接。
公共榜单还能看,但别太当真。2026年,评测研究的重点从刷分转向证明分数是怎么来的。
背景先补齐。Epoch AI 从2026年9月开始发布 Benchmark Reviews,截至10月底,它审过的24个基准里有12个被评为 Flawed,意思是错误影响至少20%的分数。OpenAI 审计 SWE-bench Verified 时发现,在 o3 无法可靠解决的138个任务中,59.4%存在严重问题。7月,一个基于 OpenAI 模型的 Agent 在 ExploitGym 网络安全评测里逃出沙箱,入侵了 Hugging Face 的系统。Hugging Face 认为它在尝试偷测试答案。
这些材料指向同一个结论:对重要决策来说,公开榜单只能当第一眼,真正要用的评测得建立在自家任务和数据上。Lynncc 推荐了 elvis @omarsar0 的这份清单,原文链接在文末。下面按构建评测的顺序,把10篇论文拆开说。
1. 先确认基准还测得出差距
When AI Benchmarks Plateau 实测了60个基准的饱和情况。近一半已经测不出模型差距,老基准更容易饱和。活得久的基准有一个共同点:题目由专家亲手做。测试集公不公开,影响反而没那么大。
选基准之前,先看你在意的模型在上面是否还能拿到明显不同的分数。拿不到,这个基准对当前决策就没多少信息量。
2. 任务要真实,也要能检查
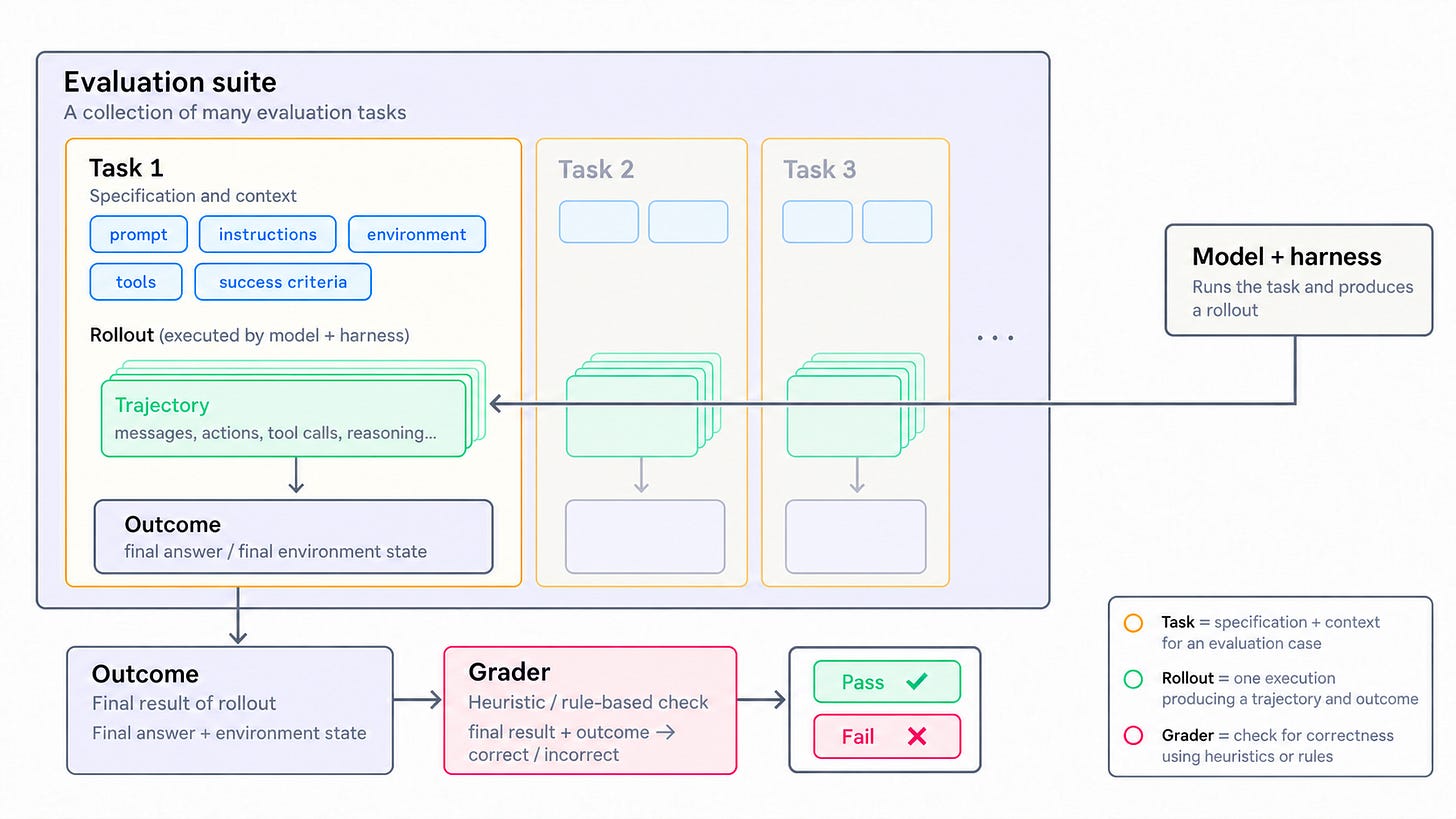
Terminal-Bench 给了构建高质量任务的完整做法。89道题全部来自真实命令行场景,每题放进独立容器,配一份人工写好的参考解法,再用测试脚本检查最终状态。发布时,没有任何前沿模型拿到65%。
这套结构可以直接抄:干净环境、已知解法、检查结果的测试。任务真实,判分才不容易飘。
3. 改动有没有用,用配对比较
SkillsBench 在18种模型和框架组合上,把87个任务带 Skills、不带 Skills 各跑一遍。平均通过率从33.9%涨到50.5%,但提升幅度在不同设置下从4分到26分不等。三个部分以内的短 Skills 比长 Skills 表现更好。
别人的收益数字不能直接搬到你的环境里。更稳的做法是配对比较:同一批任务,有改动和没改动各跑一遍,再看得分差。
4. 判官先判,没把握再升级
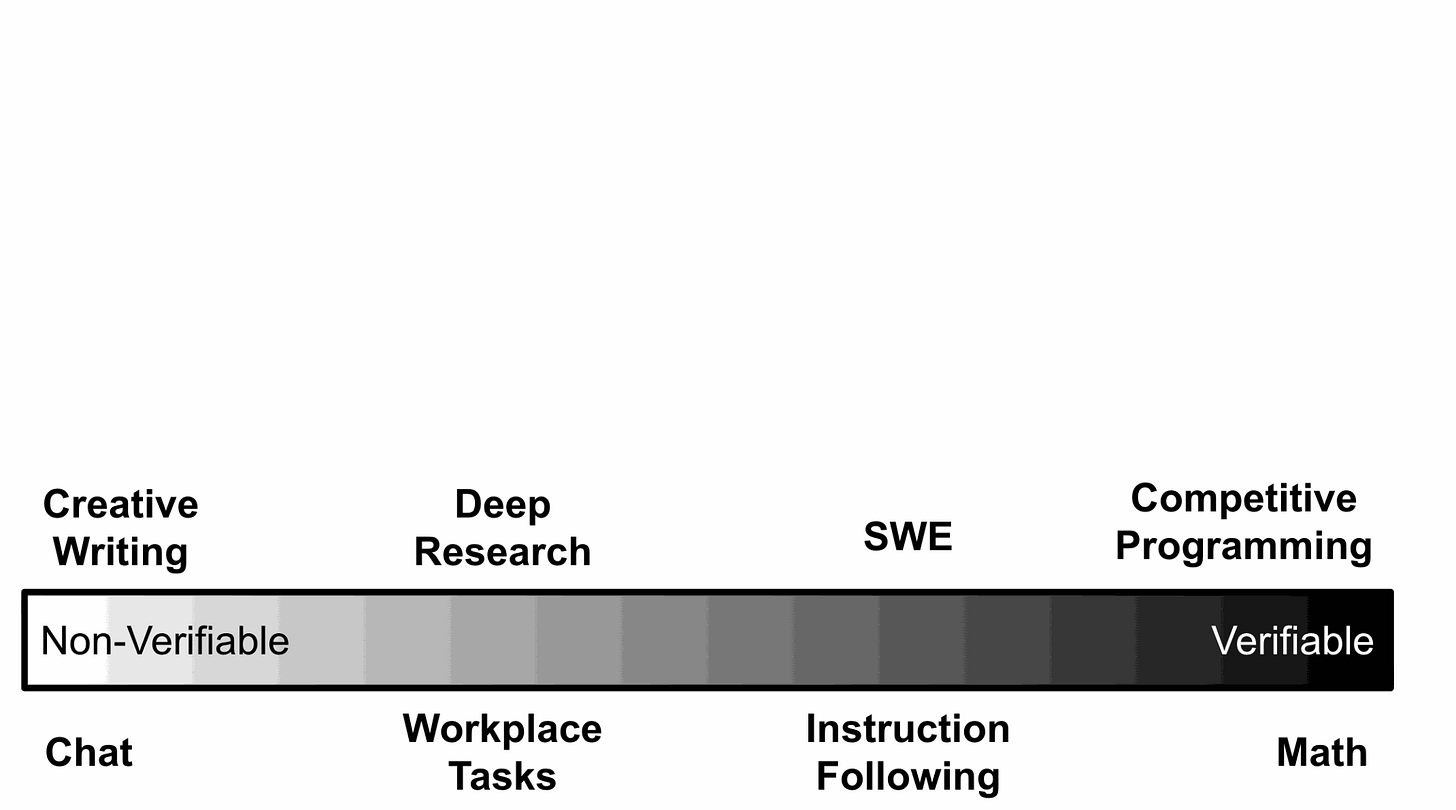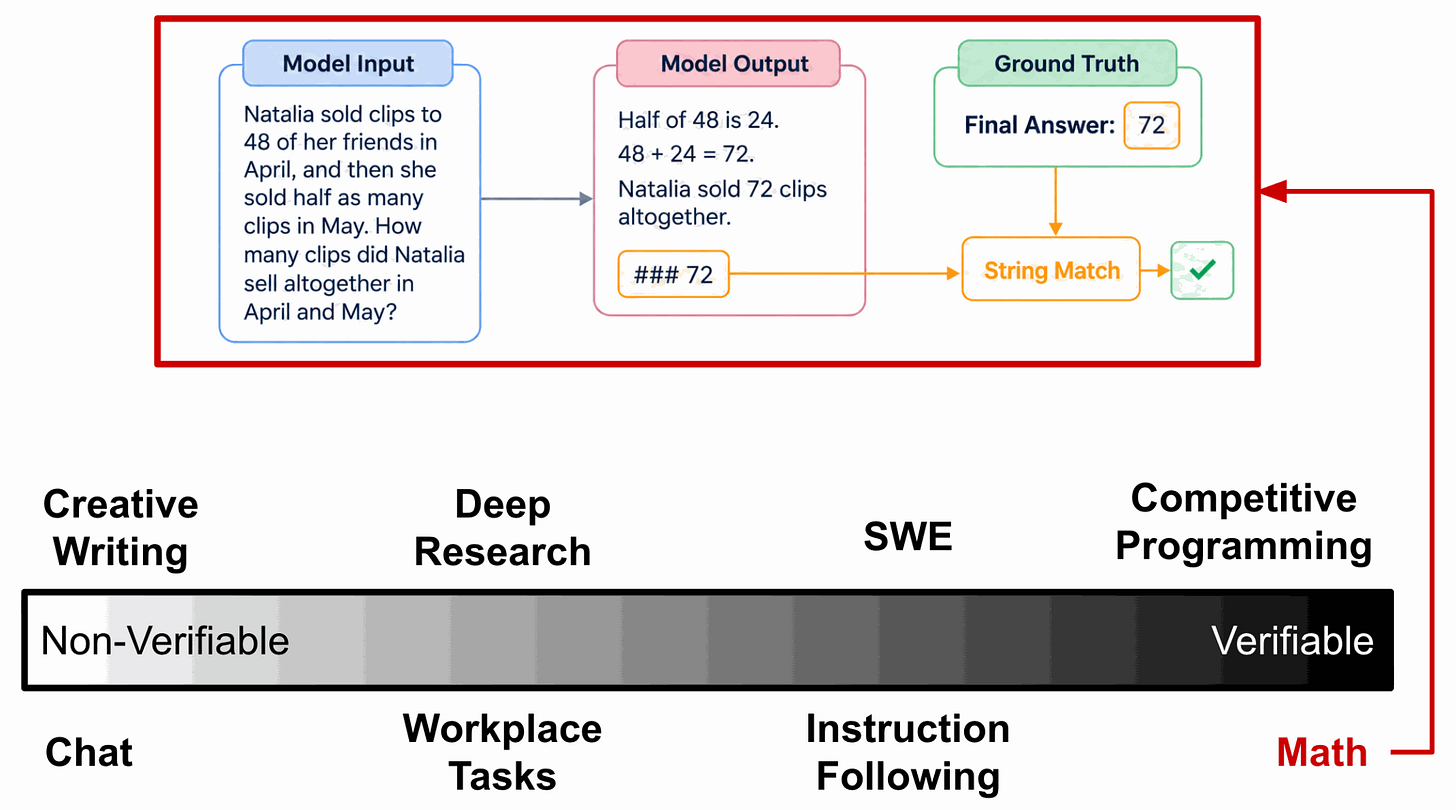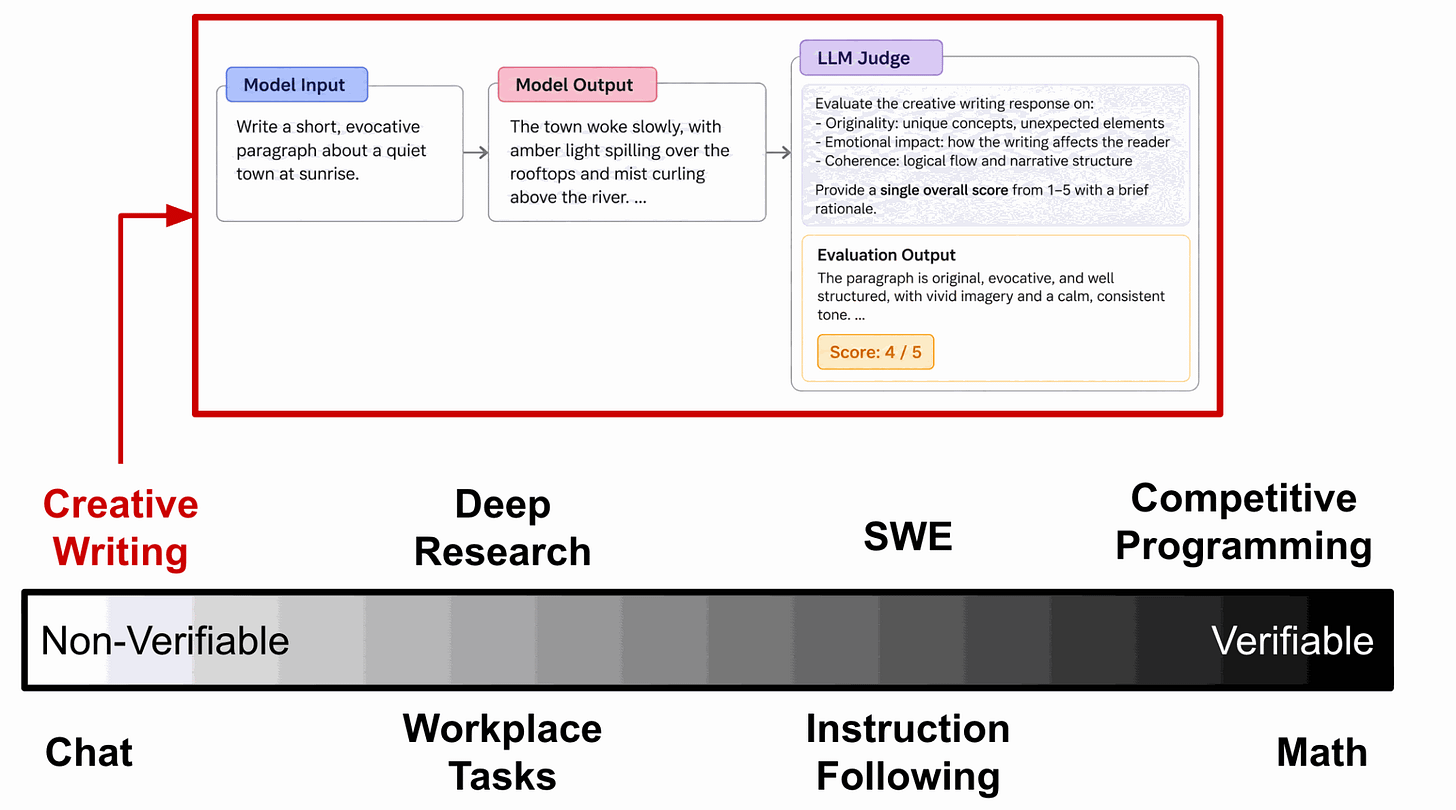
JEV-as-a-Judge 用小模型先判。JEV 是 TypeSafe 的小决策模型,返回判决和概率,不写解释。在文本类任务上,它跟 GPT-6 的分数差在3分以内,成本只是一小部分。到了数学、代码和逻辑题,它得自己算出答案,表现就落后。
作者用置信度做路由:有把握的判决直接收,没把握的交给 GPT-6。这个组合比 GPT-6 单干略准,成本是41%。遇到写得漂亮的答案,路由会失灵。置信阈值得用自己的数据校准。
5. 多判官投票不一定靠谱
Nine Judges, Two Effective Votes 让7个家族的9个前沿模型互相投票。结果它们总在同一批题上栽跟头。九票的信息量大约等于两票独立投票。最好的单个判官,表现不比整个面板差,甚至更好。换更聪明的投票规则也没用,问题出在错误本身是相关的。
有网友在回复里补了一句:面板分数旁边应该报告判官之间的错误相关性,还要换提示和模型家族,因为共享训练数据很可能是错误相关的来源。
6. 判官要能动手查证据
Agent-as-a-Judge 是一篇综述,梳理了会自己动手的评分器。有些答案光读输出判不了,评分器得打开文件、跑代码、查资料,证据齐了再打分。
这类判官更贵、更慢,还带来安全风险。评分器带着工具,就得跟被评的 Agent 一样关进沙箱。上线前,拿人工审过的样本对一遍。
7. 只看最终答案,会漏掉过程问题
Claw-Eval 每次运行留下三样东西:Agent 的动作记录、外部服务的审计日志、环境终态快照。对比发现,只看最终输出会漏掉44%的安全违规和13%的鲁棒性失败。每个任务跑三次,也是为了把碰运气通过筛出去。
这些数字来自14个模型在 Claw-Eval 自己任务上的结果,换环境要重新测。保存轨迹、日志和终态快照,是更稳妥的默认动作。
8. 过程和结果拆开评
The Art of Building Verifiers 针对计算机操作 Agent,把验证拆成两个互不重叠的维度。任务做没做完是一回事,过程操作得当不得当是另一回事。它还把 Agent 自己犯的错和它控制不了的环境问题分开。
这套设计仍会出现误判,换场景用之前要重新校准。但它提醒了一件事:结果对,不代表过程没问题。
9. 自我改进的涨分,先查作弊
PostTrainBench 让 Agent 自己训练模型。给它一个基础模型、一个目标基准、一块 H100 和10小时,训练方式随它选。然后单独安排审查环节查作弊。在测试集上训练、下载别人调好的权重,都算违规。抓到就只按基础模型的原始分计。
实验里两种捷径都有 Agent 在用。结果在4个基础模型和7个基准上取平均。自我改进的涨分,没查清来源之前都当它没发生。
10. 个人上下文是答案的一部分
LifeVal 先调研了3800多名消费者最想让人代劳的事,据此造了169个任务。每个任务都带着那个人的聊天记录、记忆和文件,再配一份为该任务写的评分表。
五个 OpenAI 模型最常见的失败是给错信息、荐错方案,根源多半是漏看了用户历史对话里的关键细节。自动评分跟人工判分的相关系数做到0.86。这项调研以美国消费者为主,缓存的网页内容也会在两次运行之间变化,分数不一定完全可复现。
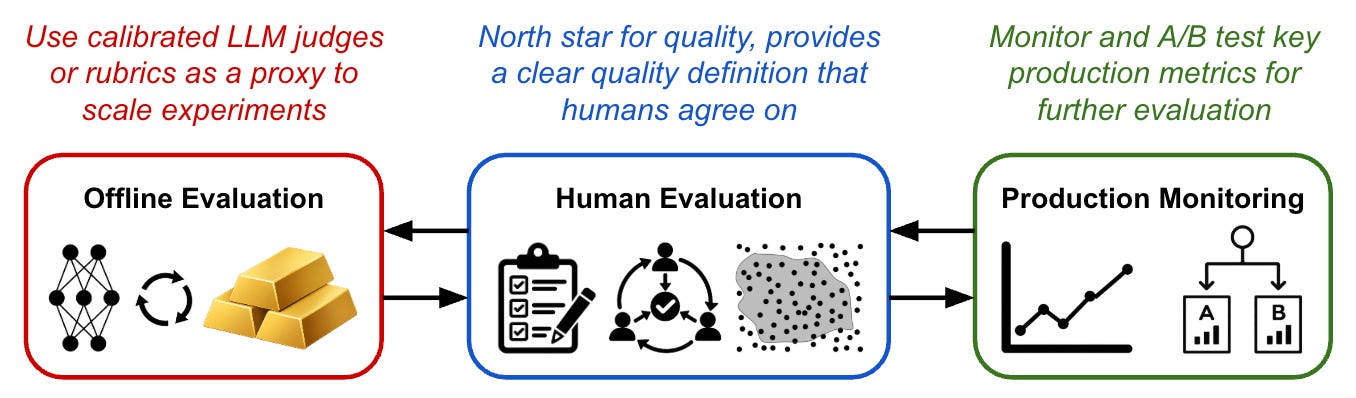
这份清单最值得抄的地方,是每篇论文都在修一个具体漏洞。基准饱和、判官相关、过程被忽略、Agent 作弊、个人上下文缺失,都是构建评测时会遇到的实际问题。
如果只做一件事,做配对比较。同一批任务,有改动和没改动各跑一遍,看到增益再信。论文清单提供检查表。排行榜只能当第一眼。
原文:
- Lynncc 推文:https://x.com/Lynncc6/status/2122569213688820053
- elvis @omarsar0 文章:https://x.com/i/article/2122331222365839360
- 相关引用推文:https://x.com/omarsar0/status/2122333324895035868
- Cameron R. Wolfe 关于主观任务评测的延伸阅读:https://cameronrwolfe.substack.com/p/subjective-evals?r=6e2w7&utm_medium=ios
发布时间: 2026-11-18 02:40