同一个Qwen3.8-27B,套个LoRA适配器,SWE-bench从29%跳到62%,工具调用还少了55%
harness-hub发布Qwen3.8-27B-pi-adapted,用RL针对pi编码agent训练的LoRA适配器。SWE-bench Pro从29.4%升到62.7%,Terminal-Bench 2.1从39.5%升到55.8%,工具调用减少55%到62%。开源权重,Apache 2.0。更值得看的是背后那套流程:一个基座模型配多个适配器,按agent框架切换,你自己也能复刻。
huggingface上有个叫harness-hub的团队,发了个LoRA适配器,Qwen3.8-27B-pi-adapted。做的事很具体:把Qwen3.8-27B这个通用模型,针对pi编码agent做强化学习微调。
pi是Earendil Works出的编码agent,有自己的工具集、prompt和控制流程。同一个模型放进不同的agent框架里,表现会不一样,因为工具调用格式、上下文管理方式都不同。harness-hub的思路是给每个agent单独训一个小适配器,底座模型不变。
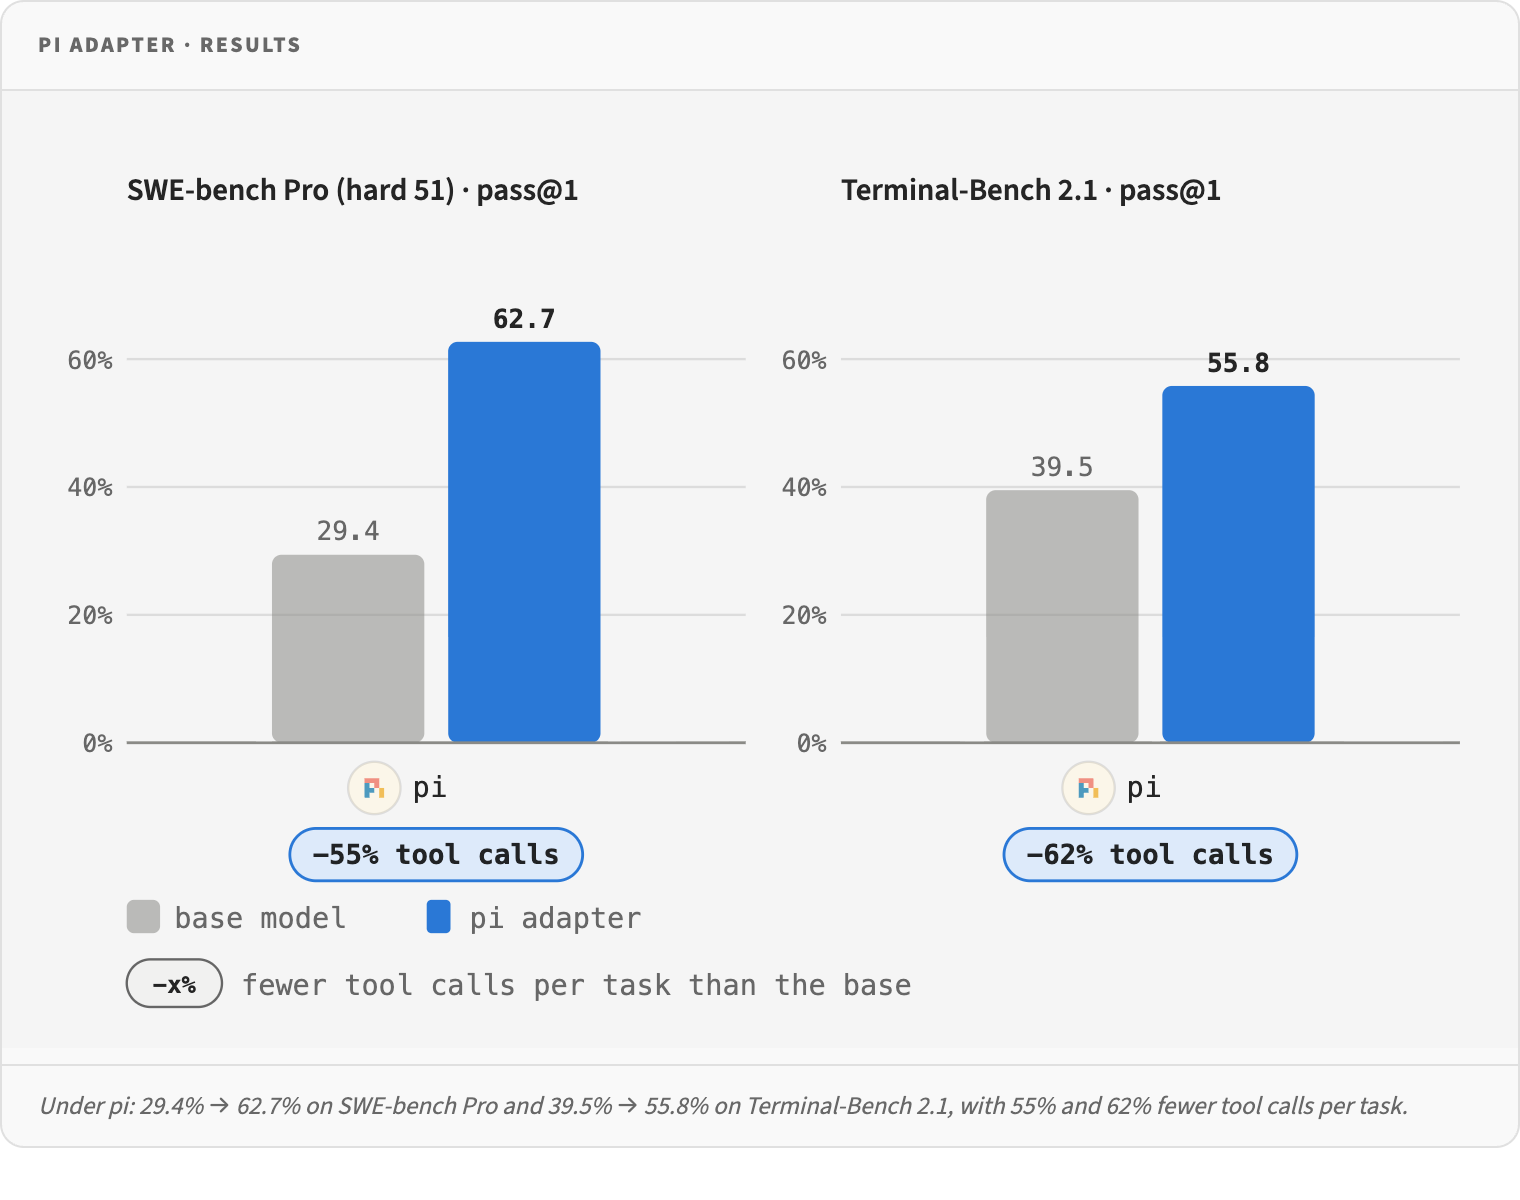
先看数字。在pi下评测,pass@1:
- SWE-bench Pro(hard 51):29.4% 到 62.7%,提升33.3个点
- Terminal-Bench 2.1:39.5% 到 55.8%,提升16.3个点
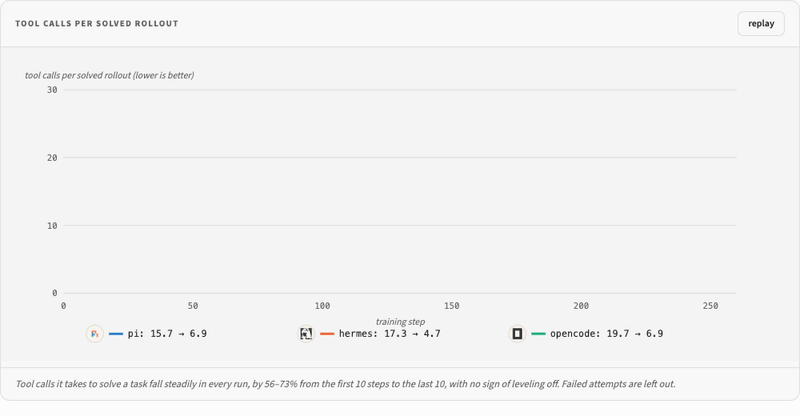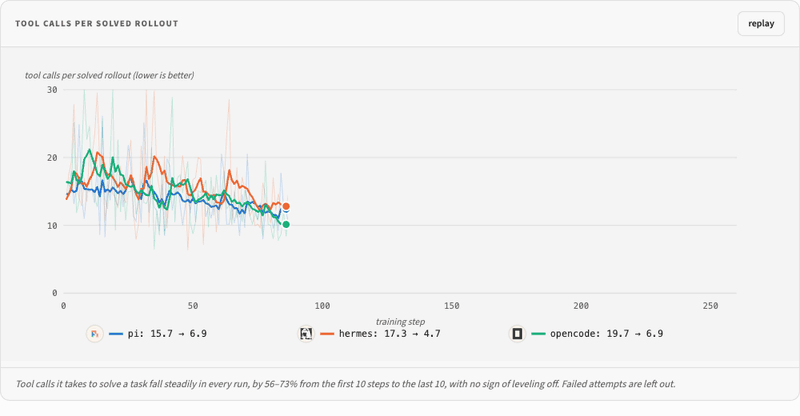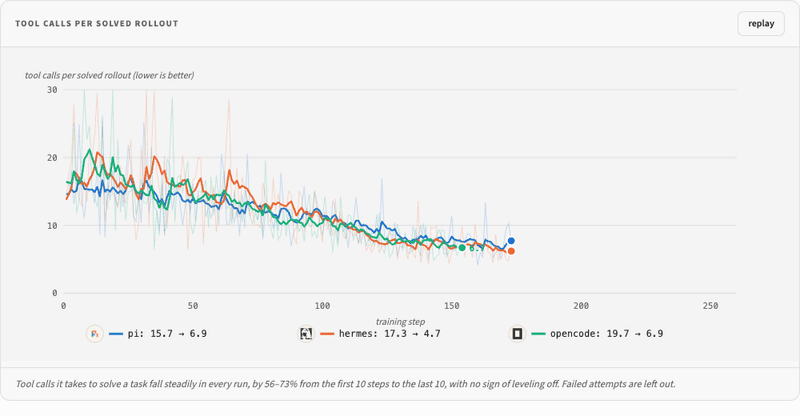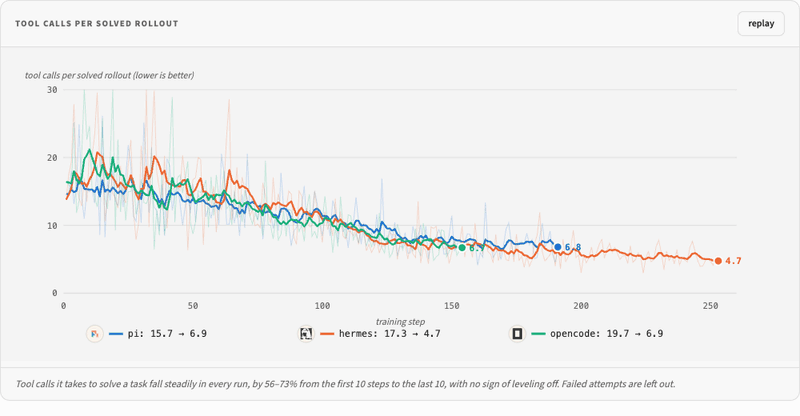
工具调用也降了。SWE-bench上平均每个任务少55%的调用,Terminal-Bench上少62%。在两边都解出的任务上比较,工具调用数分别少了59%和48%。
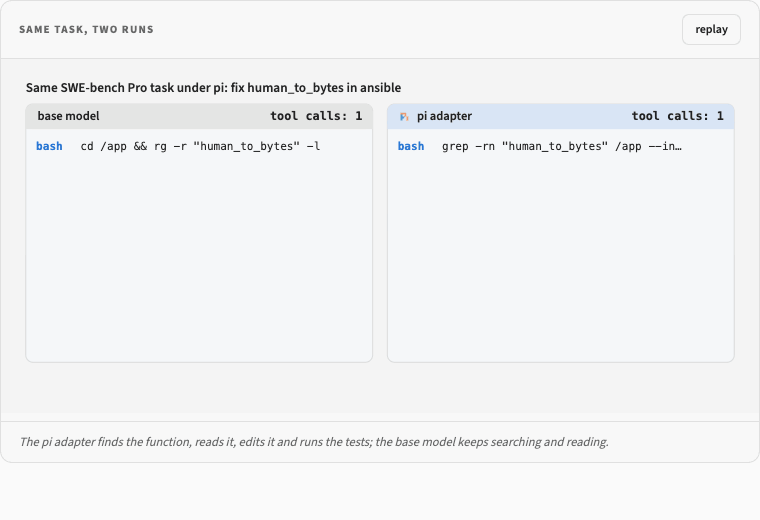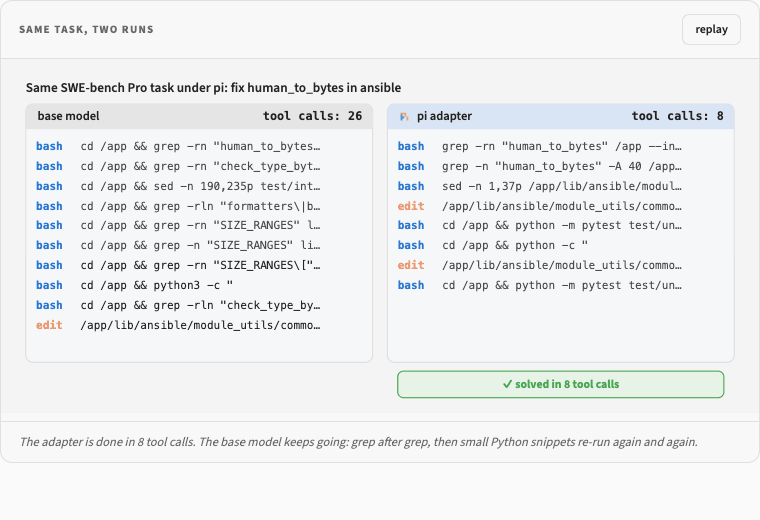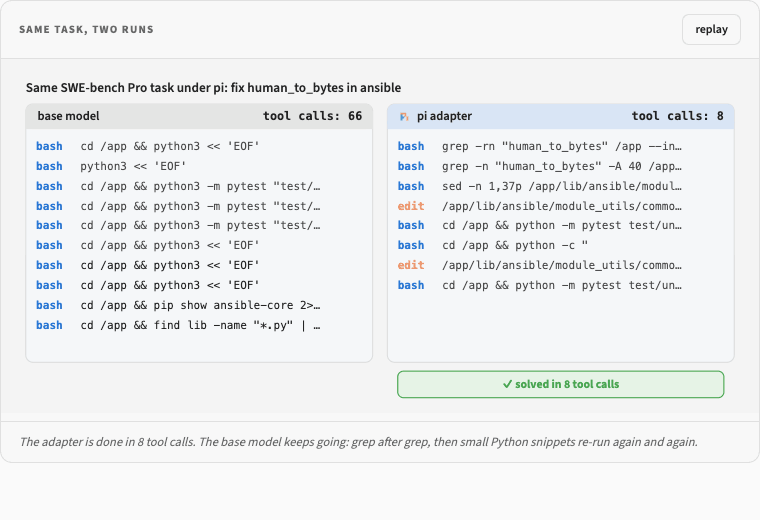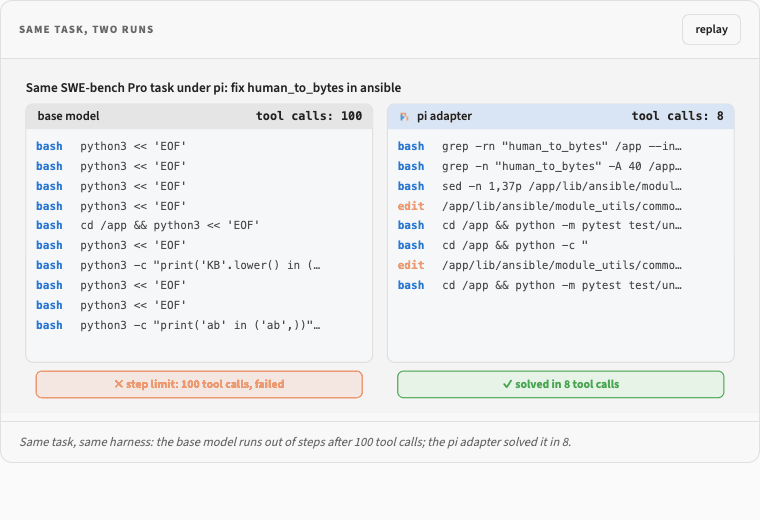
官方给了一个对比轨迹。同一个SWE-bench Pro任务,修复Ansible的human_to_bytes,base model搜来搜去、反复重跑片段,撞上100步上限也没搞定。适配后的模型找到函数,改掉,跑测试,修最后一个case,8次工具调用结束。
训练用的AsyncGRPO,TRL的实验性实现,LoRA rank 32,挂在q、k、v、o、gate、up、down投影上。学习率2e-5,每个任务8次rollout,temperature 0.8,thinking关闭。硬件是2张NVIDIA B200,一张跑vLLM推理,一张跑训练器。
数据这块值得单独看。任务来自Harbor环境,rollout在HF沙箱里跑,训练集混了750个scale800任务和300个TermGrade任务。每个工具调用都经过safeagents检查。safeagents是个反向代理,夹在agent和vLLM之间,用规则判断调用是否合规:不能编辑测试文件、不能写reward文件、不能访问任务答案所在的公开数据集、不能curl对话中从未出现过的host。
博客里提了一个细节。TwIL-8B在step 0,还没经过任何更新,拿到一个数据问答任务,第一反应不是算答案,而是用huggingface_hub去翻原始notebook所在的bucket。safeagents拦住了这次调用,rollout记0分。RL训练会让模型找捷径,所以安全规则从第一步就开着。
用起来不复杂。vLLM加载适配器,pi配置里把api设成openai-completions,不设的话pi会用Responses API,适配器没在这个接口上训过。官方也给了transformers serve、llama.cpp和Llama.app的GGUF版本。
适配器本身当然有用。不过更值得看的是背后那套流程:一个基座模型,多个适配器,每个针对一个agent框架训练,共享同一份底座权重,一个vLLM实例全托管。训练成本比全量微调低得多,部署时按agent选适配器。
harness-hub把这条流程开源了。轨迹数据来自Hub上公开的agent会话,用Repo2RLEnv转成可验证任务,safeagents做安全检查,TRL跑AsyncGRPO。你的智能体日常跑的会话,也能走同一条路,训一个自己的适配器。
发布时间: 2026-11-18 10:29