Qwen3.8-27B 加个 pi 专用 LoRA,SWE-bench Pro 从 39.2% 到 64.7%,token 省 4.5 倍
Hugging Face 给 pi 编码代理训了个 Qwen3.8-27B 专用 LoRA。SWE-bench Pro hard 51 从 39.2% 到 64.7%,工具调用少一半。thinking 关掉就追平 base model 开 xhigh,token 还省 4.5 倍。只在 pi 上验证过。
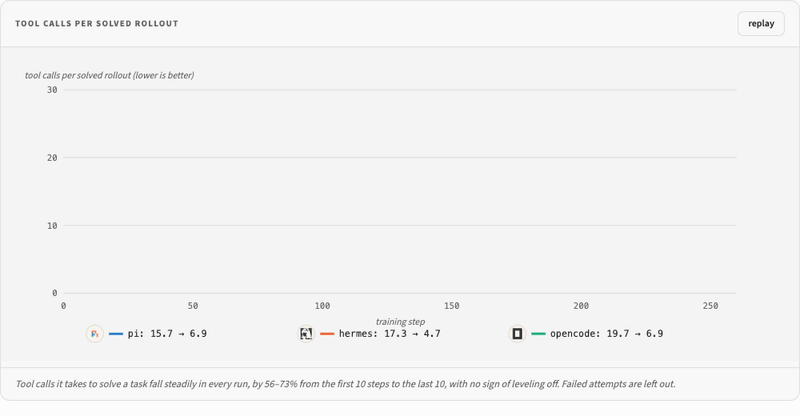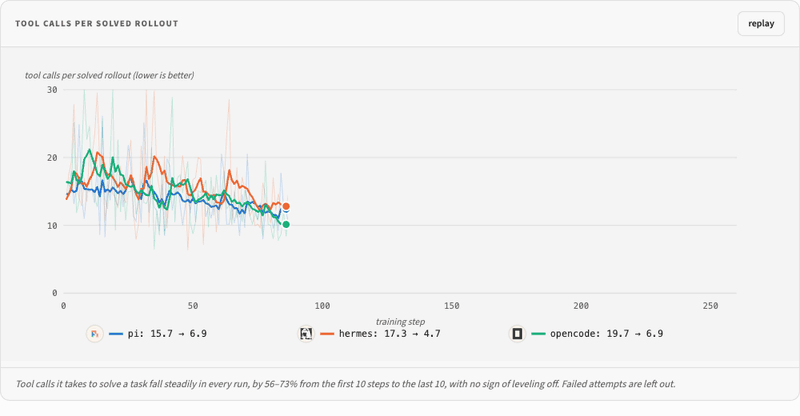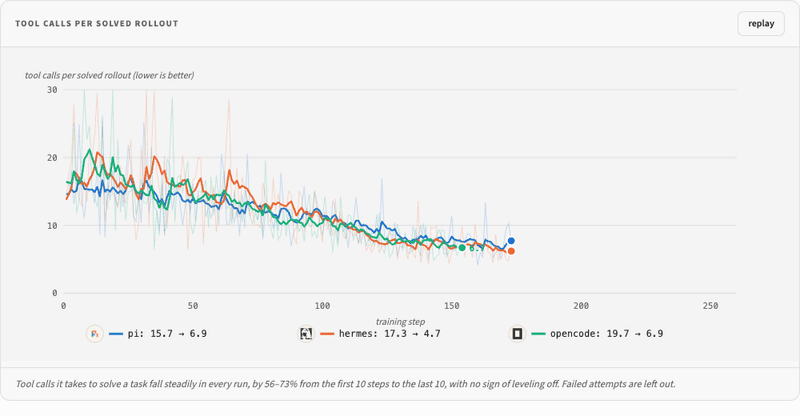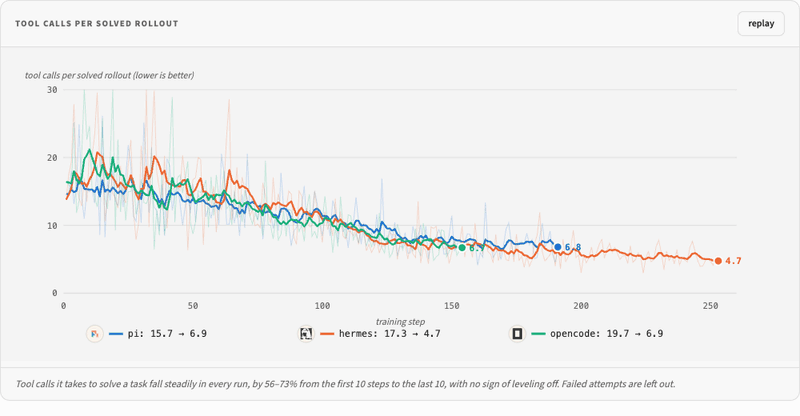
Hugging Face 的 harness-hub 发布了一个 LoRA 适配器,专门给 pi 编码代理用的 Qwen3.8-27B。数字:SWE-bench Pro hard 51 从 39.2% 到 64.7%,Terminal-Bench 2.1 从 39.5% 到 55.8%,每个任务的工具调用少了 55% 到 62%。

先澄清一个数字。Clement Delangue 在推文里写的是 29.4% 到 62.7%,但 model card 里专门说明了:之前那组数据里 base model 有 9 次 rollout 因为沙箱和模型服务器之间的隧道中途断了,判了失败。修正重跑之后,两边的数字是 39.2% 和 64.7%。改动不小,但结论没变。
这个适配器解决的是一个很具体的问题。同一个 base model 在不同 agent harness 里的表现不一样,每个 harness 有自己的工具名、参数格式和交互流程。拿通用模型去跑 pi,模型得现学这套东西,成本体现在工具调用的次数和准确率上。Hugging Face 的做法是用强化学习把 pi 的交互模式训进一个 LoRA 里。
方法叫 AsyncGRPO,LoRA rank 32,alpha 64,挂在线性层上。训练用了 750 个 scale800 任务加 300 个 TermGrade 任务,reward 是任务验证器的 correctness 加上一个 0.1 权重的工具效率奖励。160 步,2 张 B200。
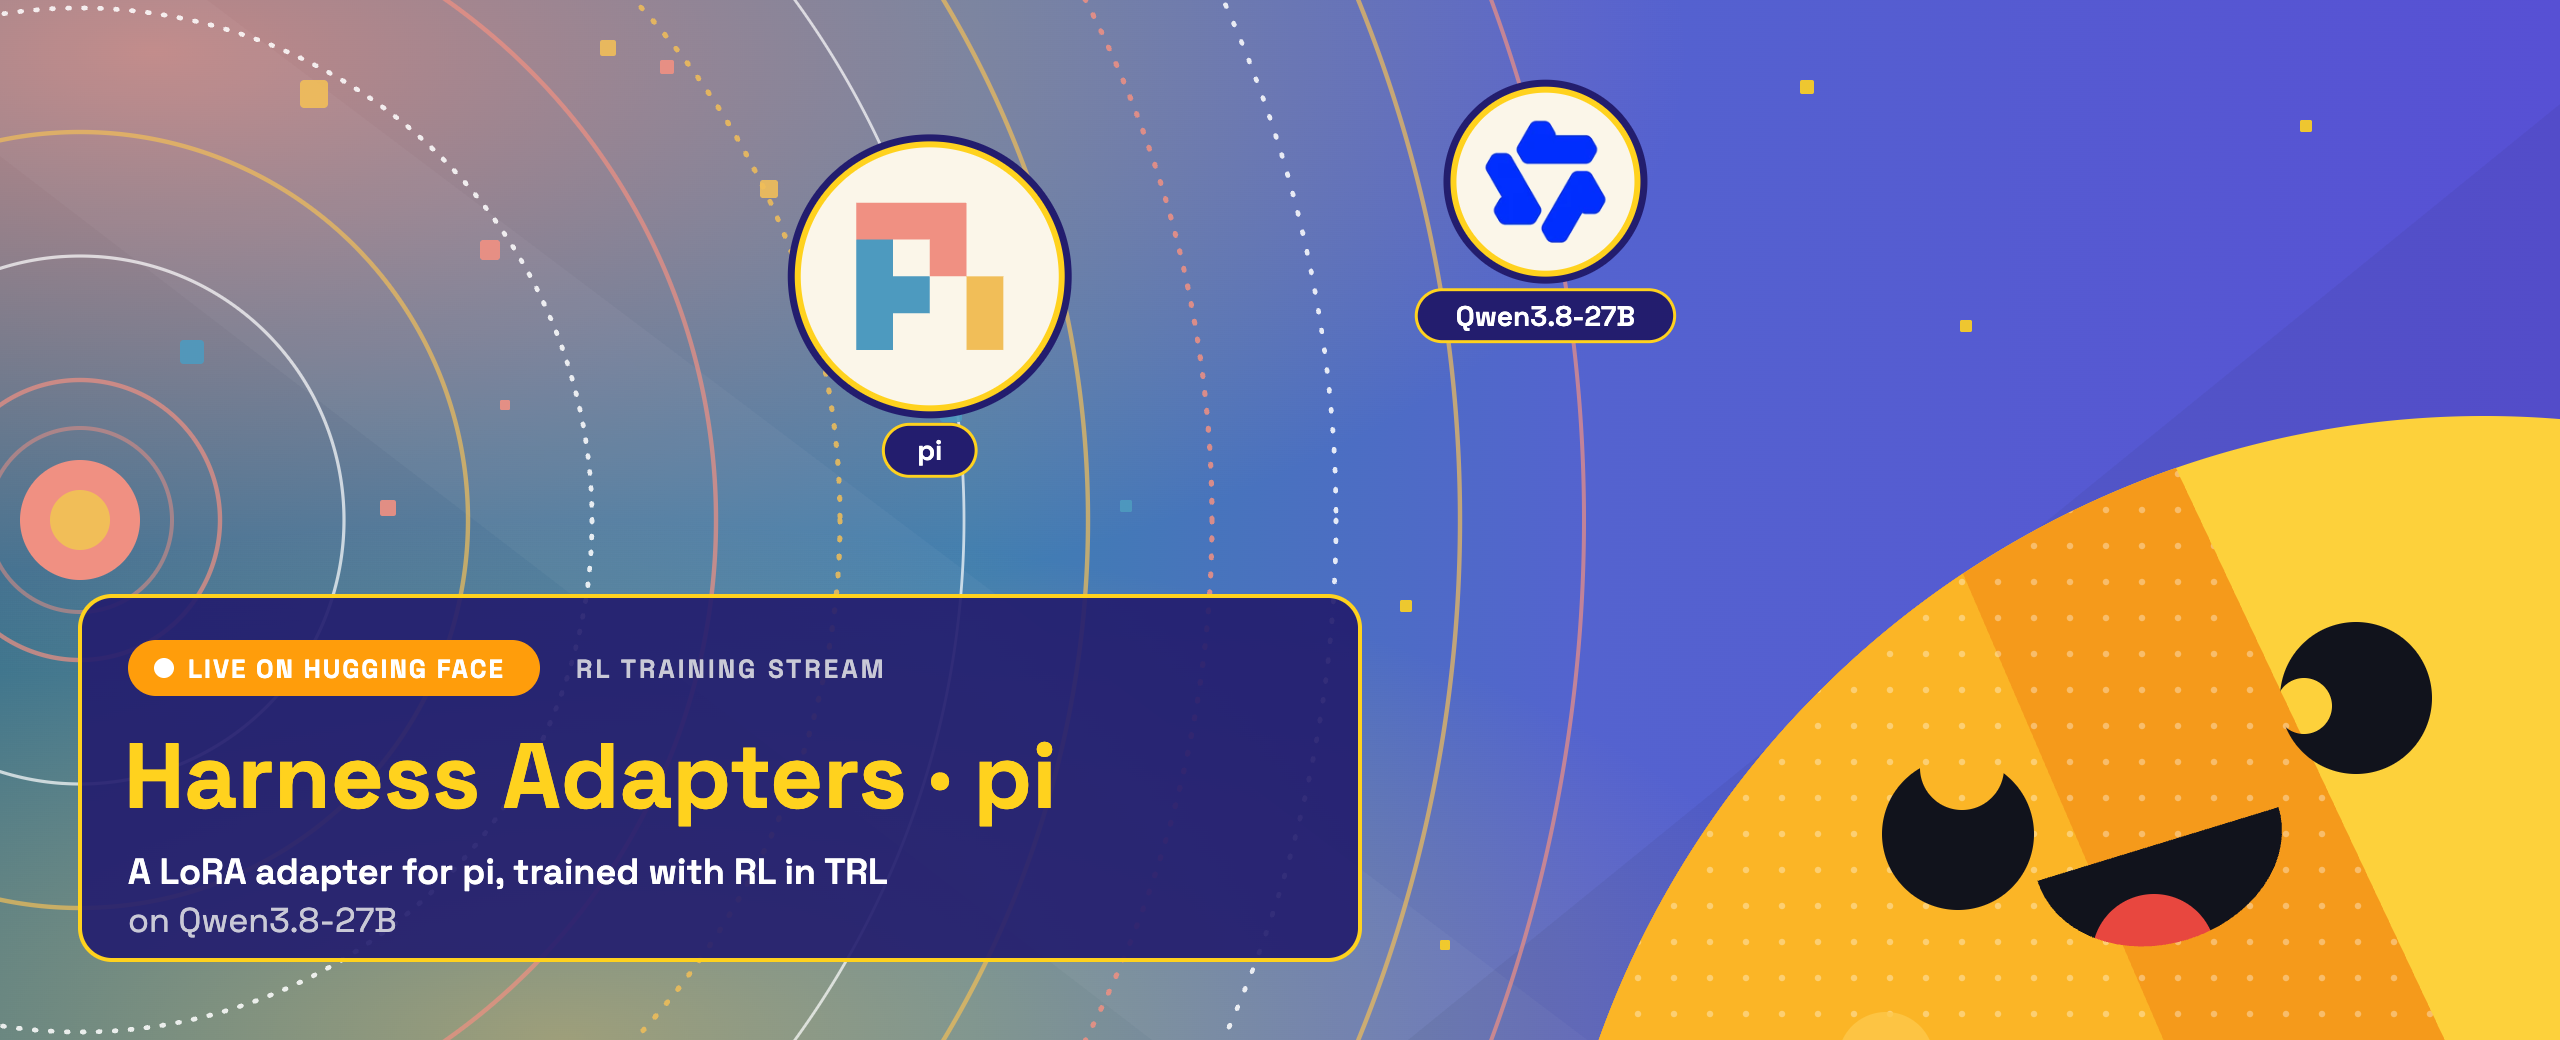
最有意思的发现是 thinking 模式。适配器在 thinking 关闭的情况下,准确率追平了 base model 开到 xhigh 的效果:SWE-bench Pro 64.7% 对 64.7%,Terminal-Bench 56.6% 对 54.2%。但生成 token 少了大约 4.5 倍,模型调用次数从 48 次降到 21 次。
训练吃掉的是思考过程,把推理能力压进了对工具的直接操作里。base model 需要先想一大段再动手,适配器直接动手。
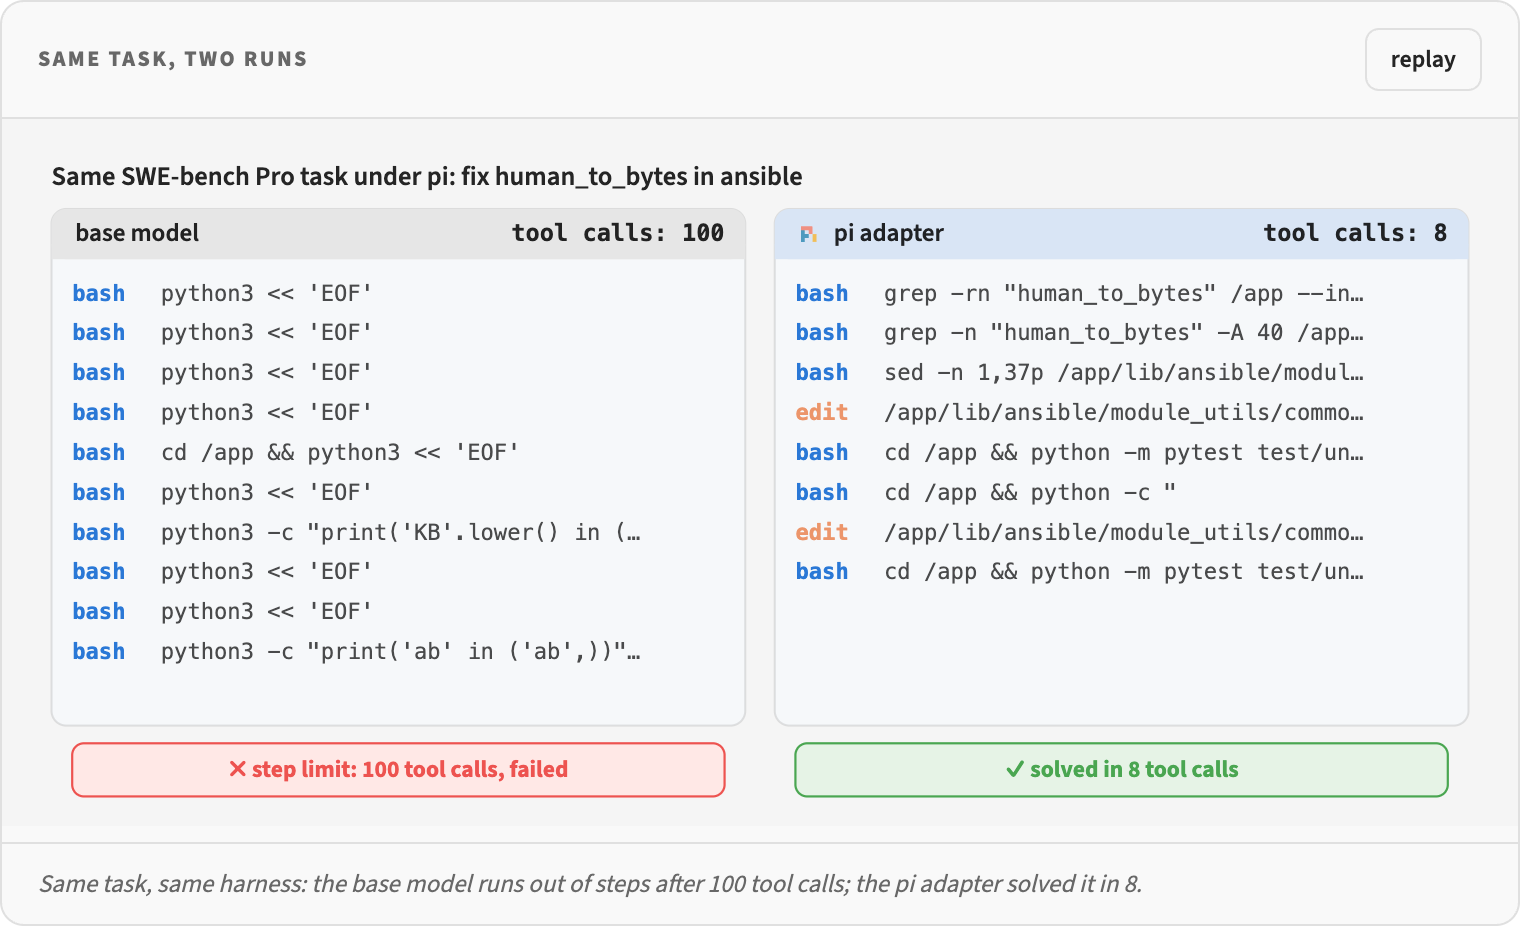
工具调用的效率提升也很实在。两边都能解出的任务上,适配器平均 23 个 turn 对 base model 的 59 个。跟 base model 开 thinking 比就更明显:生成 token 5.1k 对 34.7k。
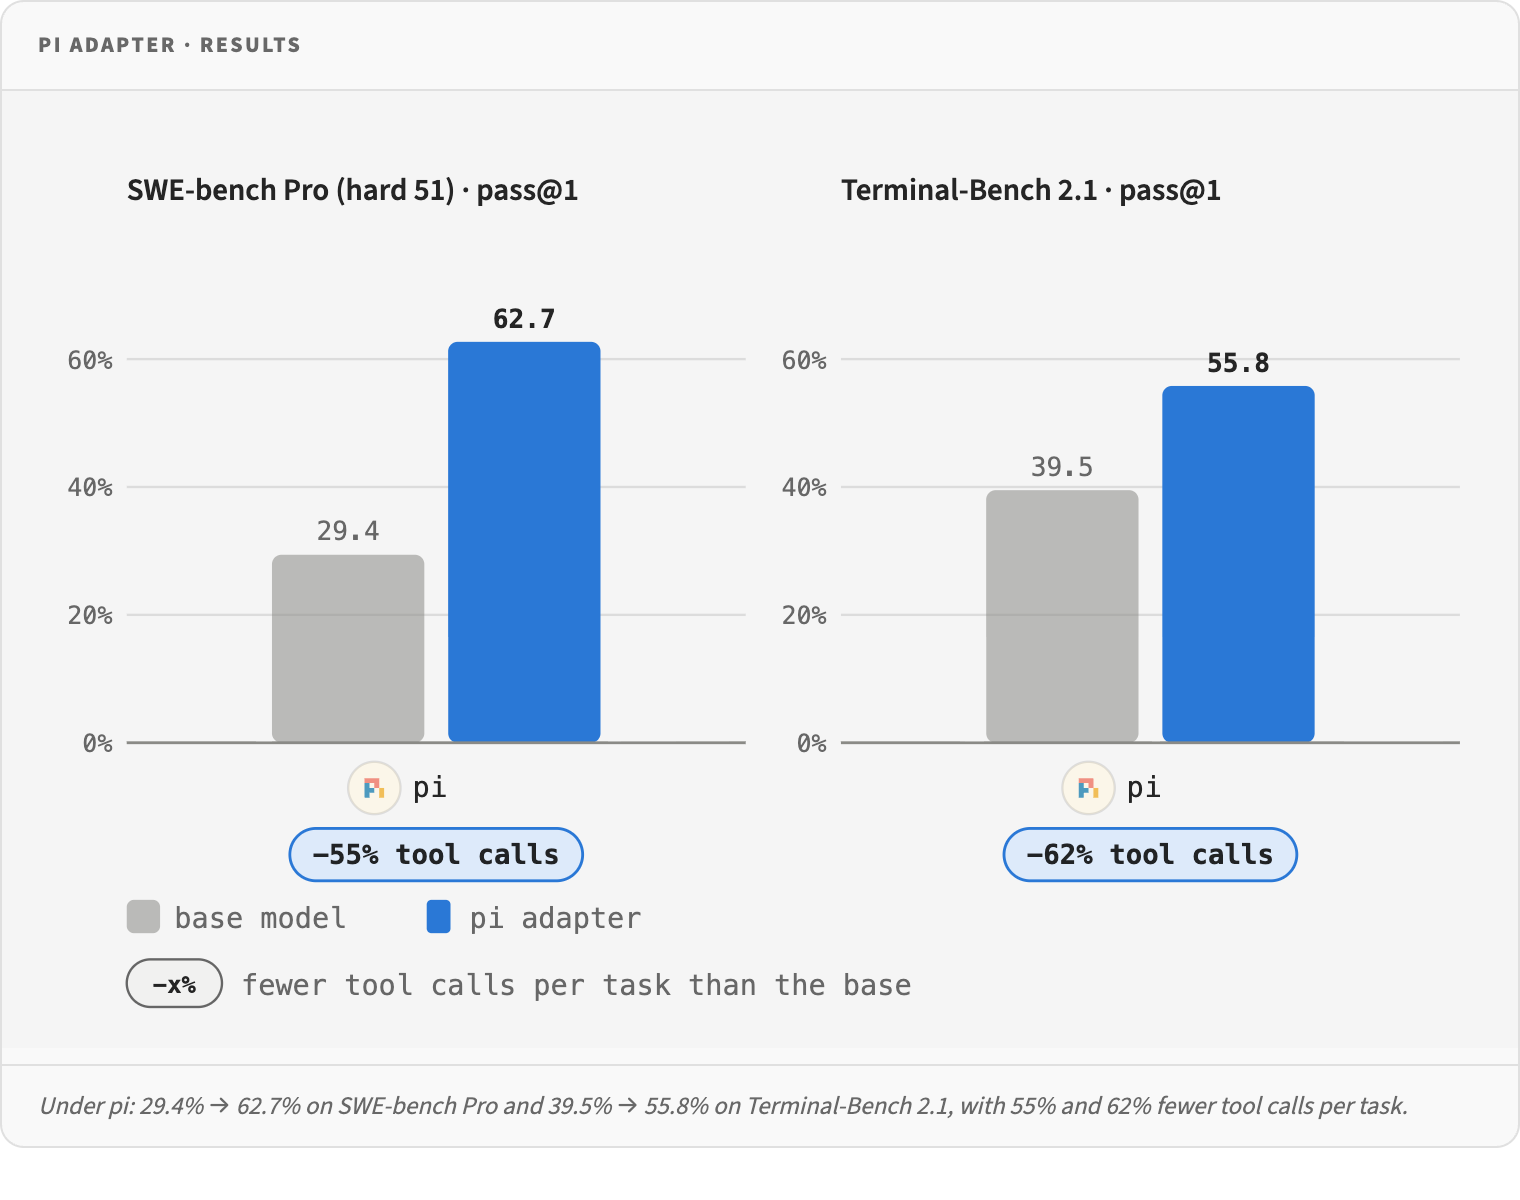
一个具体例子:SWE-bench Pro 里修 human_to_bytes 函数,base model 反复搜索和重跑代码片段,撞到 100 步上限,评 0 分。适配器找到函数、改掉、跑测试、修掉最后一个 case,8 次工具调用完成,评 1 分。
限制也很明确。它必须挂在 Qwen3.8-27B 上,不能换 base model。训练和评估都在 pi 里做的,换到 Claude Code 或 Codex 上表现如何,官方没给数据。推文下面 Charlie 和 Asmir 都问了这个问题,官方只回了 Asmir 一句,问他想不想试试给它们训一个。
eishan 问得更直接:怎么确定模型不是记住了这些公开 benchmark 的答案。官方回复是 yb2698 确认过。model card 里也做了相应处理,base model 和适配器的训练数据里没有隐藏测试,评测用的是 hard 51 这组任务。但 benchmark 本身是公开的,预训练数据有没有见过,只能靠训练方自查。
还有两个背景值得补。
这套东西叫 harness adapter,思路是一个 base model 配多个适配器,每个适配器对应一个 agent harness。好处是成本低,一个 vLLM 实例可以同时挂多个适配器,训练和评估都不需要合并权重。
博客里提到一个安全机制叫 safeagents,是个反向代理,每个工具调用在真正执行前过一遍规则检查。规则是硬编码的正则,不是模型,判断时间 10 到 20 毫秒。防的是 reward hacking,比如模型去读 tests 目录、改写 grader、从 Hub 下载原始数据集找答案。TwIL-8B 在 step 0 就试图用 huggingface_hub 去找任务源数据,被拦了,那个 rollout 得分 0。
训练数据的分布也有意思。270 个任务里 253 个是 build 类,从零搭一个项目。repair 只有 11 个,extend 6 个,qa 一个都没有。这跟开源 agent 轨迹的构成有关,大部分共享的会话都是一次性的建项目请求。博客里直接说,想训出更好的适配器,最缺的是出问题又被修好的会话,以及项目在多次请求中逐步生长的会话。
模型卡页面写着 Apache-2.0,权重可以直接下。训练代码在 TRL 的 examples/async_grpo_harbor 目录里,博客给了完整的环境生成方法。想给自己的 harness 训一个适配器,步骤大概是:保存你平时用 agent 的会话轨迹,用 safeagents scrub 清理敏感信息,用 Repo2RLEnv 转成可验证任务,跑一遍同样的 RL 流程。
Hugging Face 说这套流程不特定于他们的 harness。听起来像客套,但如果你每天都用同一个 agent 干活,这个思路确实成立。
发布时间: 2026-11-18 23:39