智能体记不住重点,不是记忆库太小
Meta、Google和几篇新论文都在转向同一个方向:让模型自己设计记忆习惯,再把这种判断蒸馏进权重。但成本、遗忘和跨模型迁移仍是硬骨头。
一个智能体在同一项目里修一周bug,下一轮还是会踩同一个坑。给它一个笔记目录,它会记流水账,关键决策反而没留下。问题出在判断什么值得记,存储不是重点。
上周Meta和Google几乎同时发了关于自我改进记忆的研究。方向一致:记忆设计不该由人写死,让模型自己试,再把试出来的习惯训练进权重。
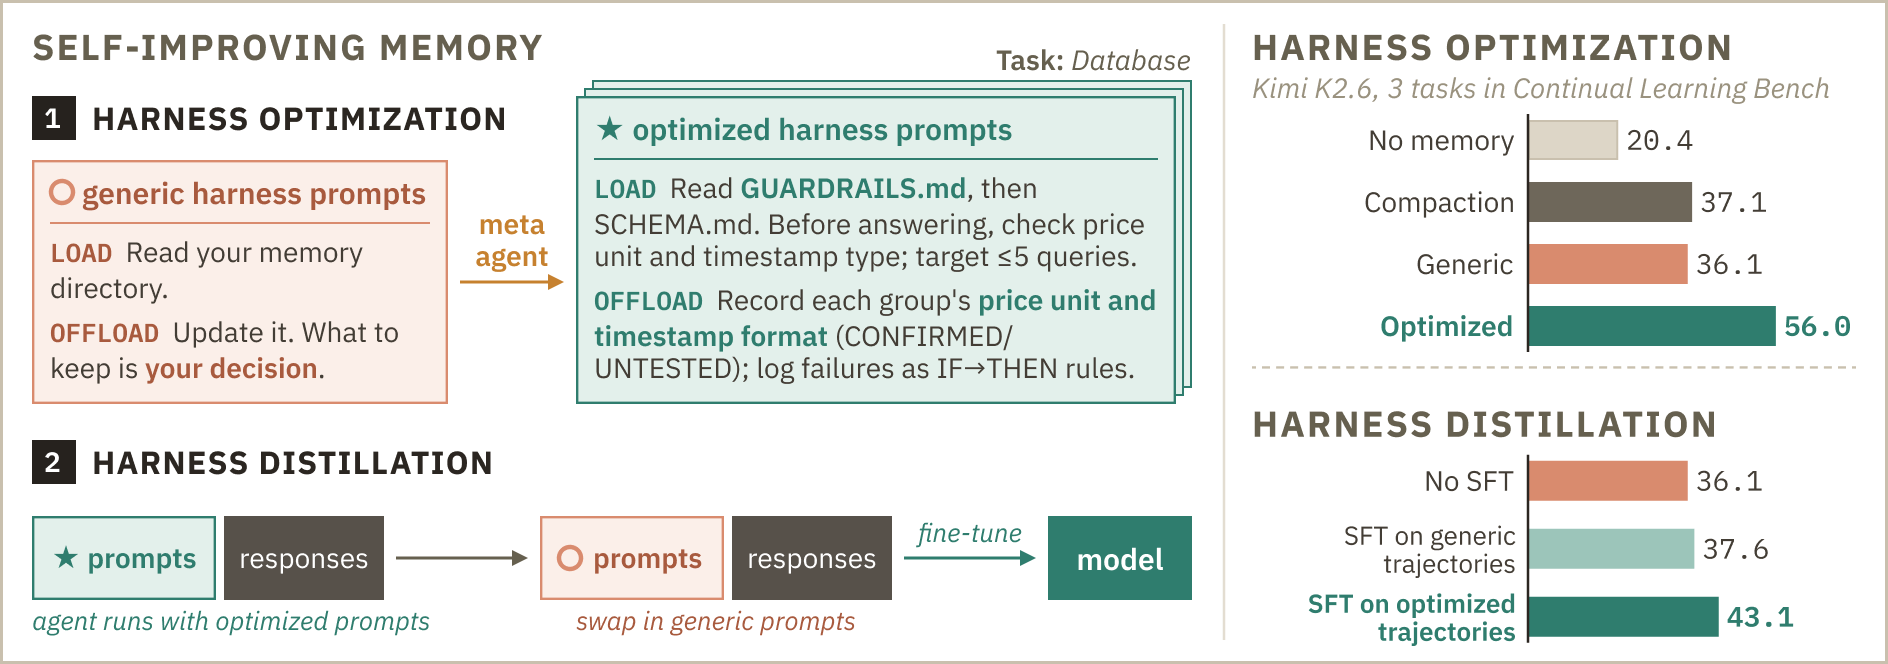
Meta的Self-Improving Memory分两步。先让一个meta agent看任务agent的轨迹,重写LOAD和OFFLOAD提示,搜索出更好的记忆策略。再把优化后的提示替换回通用提示,用这些轨迹做LoRA微调。模型是Kimi-K2.6。Continual Learning Bench三个任务上,优化提示平均56.0,最好的人工提示44.6。蒸馏后,模型只用通用提示能到43.1,比在通用轨迹上微调的37.6高5.5分。来源:Meta Research blog,作者Tong Chen等。

RIME换了一条路。它用RL训练一个模型同时做两件事:当actor用现有记忆解题,当writer复盘并更新笔记。writer的奖励来自后续任务表现是否提升,actor的奖励来自任务完成和发现新信息。4B参数的模型在实验中达到接近GPT-5.4和Claude Opus 4.7的分数。有研究者指出,训练一个4B模型匹配前沿分数是头条,真正的考验是记忆判断能否迁移到没训练过的任务。

Google的SIM不训练任务模型,训练harness优化器。它把过去的编辑按harness问题分组,记录理由、预测结果、实际结果和评估上下文。proposer和selector都读这份记忆。在四个领域、十个coding独立运行里,SIM让9/10的继续优化得分提升,平均+2.36分,p=0.003。但一个反例很刺眼:在Opus上演化出的harness,换到Gemini上初始得分68.41,低于原始seed harness的73.89。有评论提醒,只有coding结果被复现,其他领域每个条件只跑了一次。

SoMem让agent用普通链接文档组织记忆。agent自己决定摘要什么、建什么主题、何时修订,每个摘要都链回原始交互作为证据。运行时验证更新,并生成时间、关系、最近视图。在LoCoMo、BEAM-100K、LongMemEval-S上分别比最强基线高2.66、3.10、2.00个百分点。代价不低:有网友贴出成本,全量LoCoMo上SoMem总花费229.73美元,Mem0是6.75美元,其中118.85美元是一次性构建,之后每问约0.07美元、20秒。适合查询频繁的记忆。

Route to Remember处理另一类记忆:用户事实。它用on-policy self-distillation把用户记忆训练进权重,学生模型回答时不读检索上下文。八个HaluMem-Long用户上,OPSD达到59.9% QA准确率,MemOS式检索47.8%,提取上下文51.9%,原始对话51.3%。普通SFT只有36.9%。权重记忆的毛病是旧事实会忘,也分不清某个事实从来没记录过。verify-then-regenerate路由器查文本存储,再加6.2分。

Continual-ARC的结论更直接。Daniel Lenton团队测试OpenClaw、Hermes Agent和Prime Agent,发现在新基准上它们没能记住有价值的信息,也没能泛化到新任务。训练一个9B模型的权重,两项都做到了。
这些工作指向同一件事:记忆系统的竞争力在“写什么、何时写、何时删”的判断。存储容量和检索速度不是核心。有网友说,自己的agent用链接markdown笔记,设置一个周六就能跑,但问题在上新页面很快,回头修旧页面几乎不做。另一个评论更具体:过期不是整理能解决的,需要一条新笔记覆盖旧笔记,在读取时杀掉旧笔记。只追加加搜索,系统会越用越乱。
评估也是短板。Google的SIM只在coding上有多seed复现,其他领域样本少。Meta的蒸馏提升是描述性的,base model单独评估。RIME的4B模型分数接近前沿,但跨任务迁移还没被充分测试。Route to Remember的权重记忆在事实更新时是否需要重新蒸馏,素材里没有答案。
一个可操作的建议:如果你在搭agent,先别急着上向量库。把每次对harness或提示的修改、修改理由、预测结果、实际结果记在一起。让agent在下一轮读这份记录。这个做法成本低,能暴露“改了但没用”的编辑。等记录多到需要检索,再考虑链接文档或向量存储。记忆的价值不在存了多少,在下次任务开始时,它能不能让你少走一步。
发布时间: 2026-11-19 00:37