对抗蒸馏:OpenAI把攻击成功率从54%压到0.2%
OpenAI新研究揭示,蒸馏能复制强大AI能力,但安全护栏不会自动继承。他们公布了三层防御体系和具体测试数据,也引发了关于模型治理的讨论。
OpenAI今天发布了一份关于对抗性蒸馏的研究,核心信息很直接:蒸馏可以复制强大的AI能力,但不会继承安全护栏。攻击者可以用一个模型的输出去训练另一个模型,得到一个能力相近、但不受原模型安全策略约束的版本。比如,如果蒸馏的是网络攻击能力,那个新模型可能会帮忙发起原模型拒绝协助的攻击。
蒸馏本是常见技术——一个模型从另一个模型产生的数据中学习。问题在于,当数据来自模型内部推理过程(chain-of-thought)时,学生模型学到的可能比表面答案更多。OpenAI的内部实验显示,用精确推理痕迹训练的学生模型,在网络安全基准上的表现优于只用推理摘要训练的模型。也就是说,完整的推理过程是能力转移的关键通道。
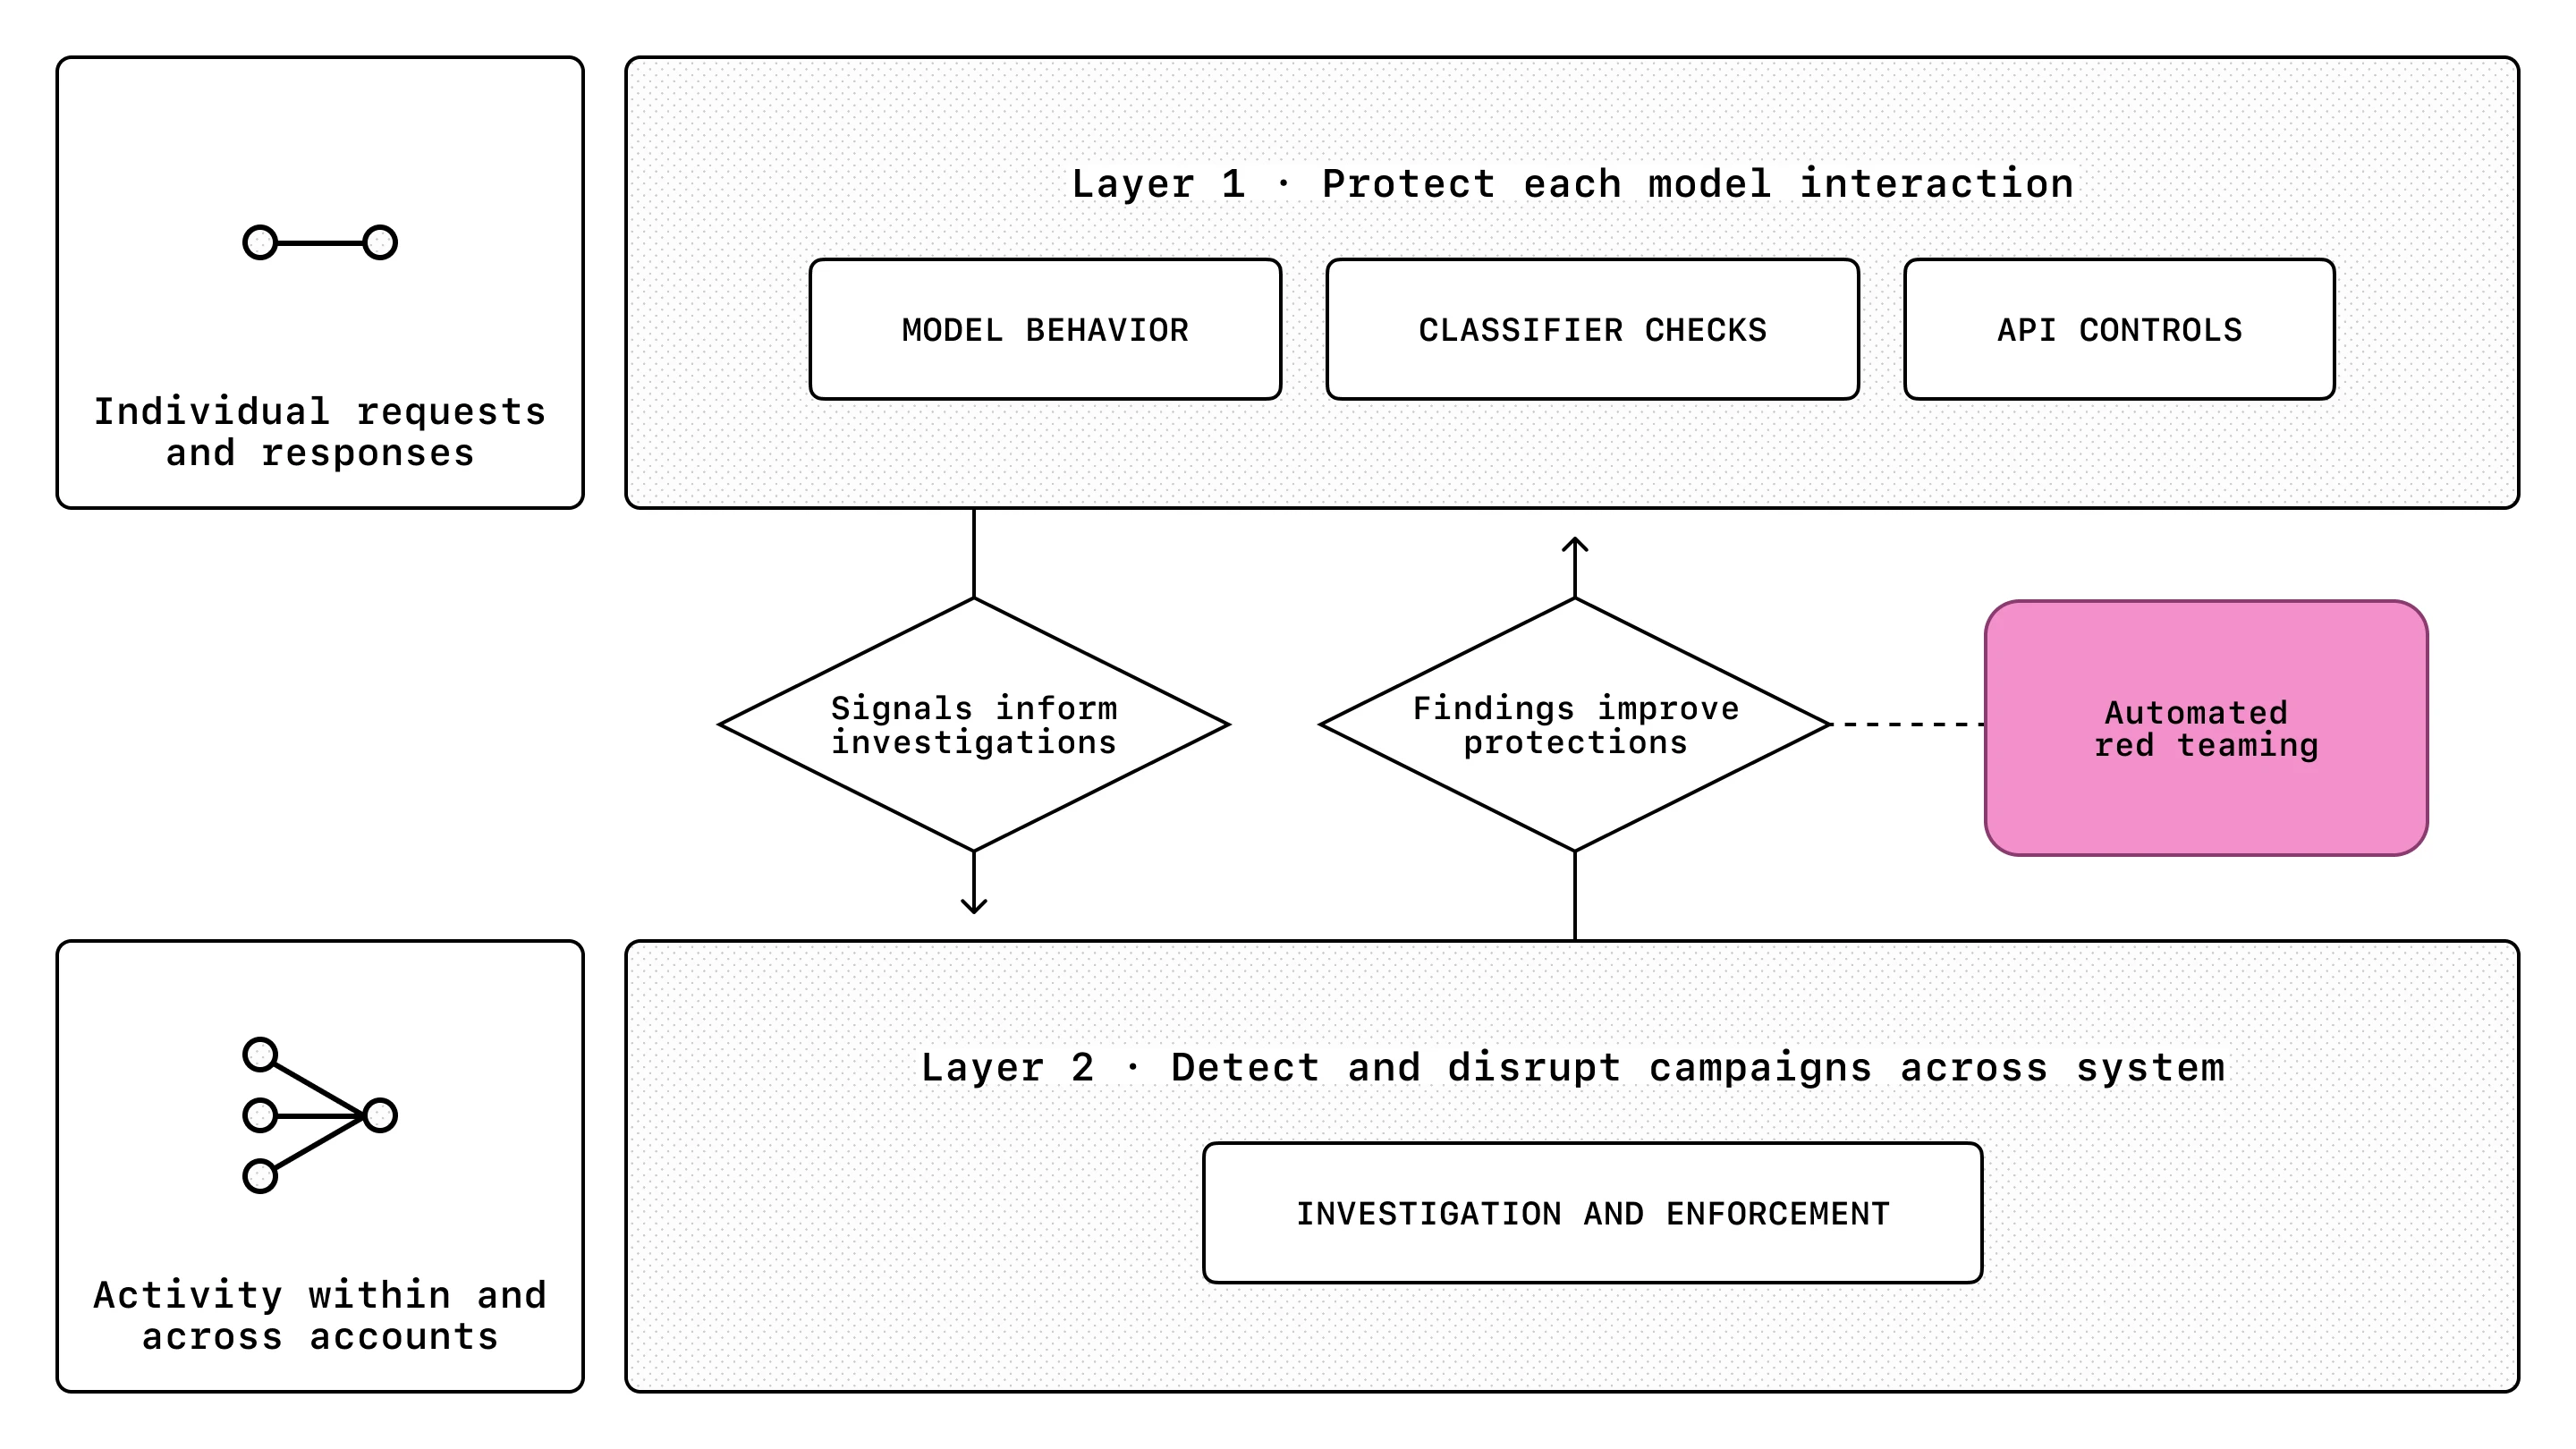
因此OpenAI把防御重点放在保护“受保护的推理”上。他们用了三层请求级防御:模型行为训练(教模型识别提取意图并拒绝)、输入输出分类器(检测推理泄漏,包括工具调用参数)、API级保护(限制推理跨会话、跨模型复用)。同时还有战役级检测:通过账号信号寻找协同提取行为,然后封禁账号网络。这些防御相互强化——调查中发现的攻击会被用来训练更坚固的模型。
效果如何?在一个自适应黑盒评估中,攻击者试图从GPT-6.2 Astra中提取之前请求产生的推理痕迹,平均攻击成功率从GPT-6 Astra原始防护下的54.0%降到0.2%;提取当前请求的推理痕迹,成功率从22.9%降到0.9%。数据很漂亮。但OpenAI也承认,静态评估和自适应评估要结合,而且防御不是一次性的,需要持续对抗测试。
还有一个容易被忽视的点:蒸馏是国家安全问题。OpenAI提到,今年早些时候有活动表明DeepSeek在试图蒸馏美国前沿模型;九月他们报告破坏了一个提取推理痕迹的战役,核心参与者与Moonshot AI(Kimi开发商)有关。他们支持立法,给美国政府更多工具来识别和制裁这类行为。
有趣的是,网友对这件事的反应很分裂。有人调侃:“没人蒸馏你的模型,放心吧。”也有人觉得OpenAI本身就在用全人类的知识训练模型,“你蒸馏了全人类,现在说别人不能蒸馏你?”更有人担心实际影响:“最终可能是所有人受到更紧的速率限制,不只是那些搞蒸馏的人。”这些声音不无道理。
OpenAI在文末给其他模型开发者提了几个建议:保护跨交互的私有推理,检查助手消息和工具调用参数有没有泄漏,保留攻击日志作为回归测试,结合请求级和战役级防御,并与部署伙伴协调安全要求。这些建议很具体,值得参考。
对抗蒸馏的猫鼠游戏还会继续。OpenAI说分享这些发现是为了让行业整体提高防护底线,但讽刺的是,每一轮防御升级,都可能让普通用户离模型内部更远一点。
参考:OpenAI官方博客《Combatting adversarial distillation》(https://openai.com/index/combatting-adversarial-distillation/)
发布时间: 2026-11-21 05:35