一次前向传播,0个输出token:这个31B决策模型登顶Decision Index
Karpo Decision 31B,基于Gemma 4的开源决策模型,在Decision Index上排名第一。它不生成文本,而是直接返回每个选项的概率,单GPU中位延迟94毫秒。
Karpo Decision 31B发布了。31B参数,基于Gemma 4,开箱即用。它在Decision Index上拿了73.9分,排名第一,比第二名Jev(60.2分)高出一截。速度快一倍,价格便宜20%。
这个模型做的事和普通LLM不一样。给它一段状态(网页、文档、对话)和几个选择题,它直接返回每个选项的概率。不生成token,不解码文本,一次前向传播出结果。
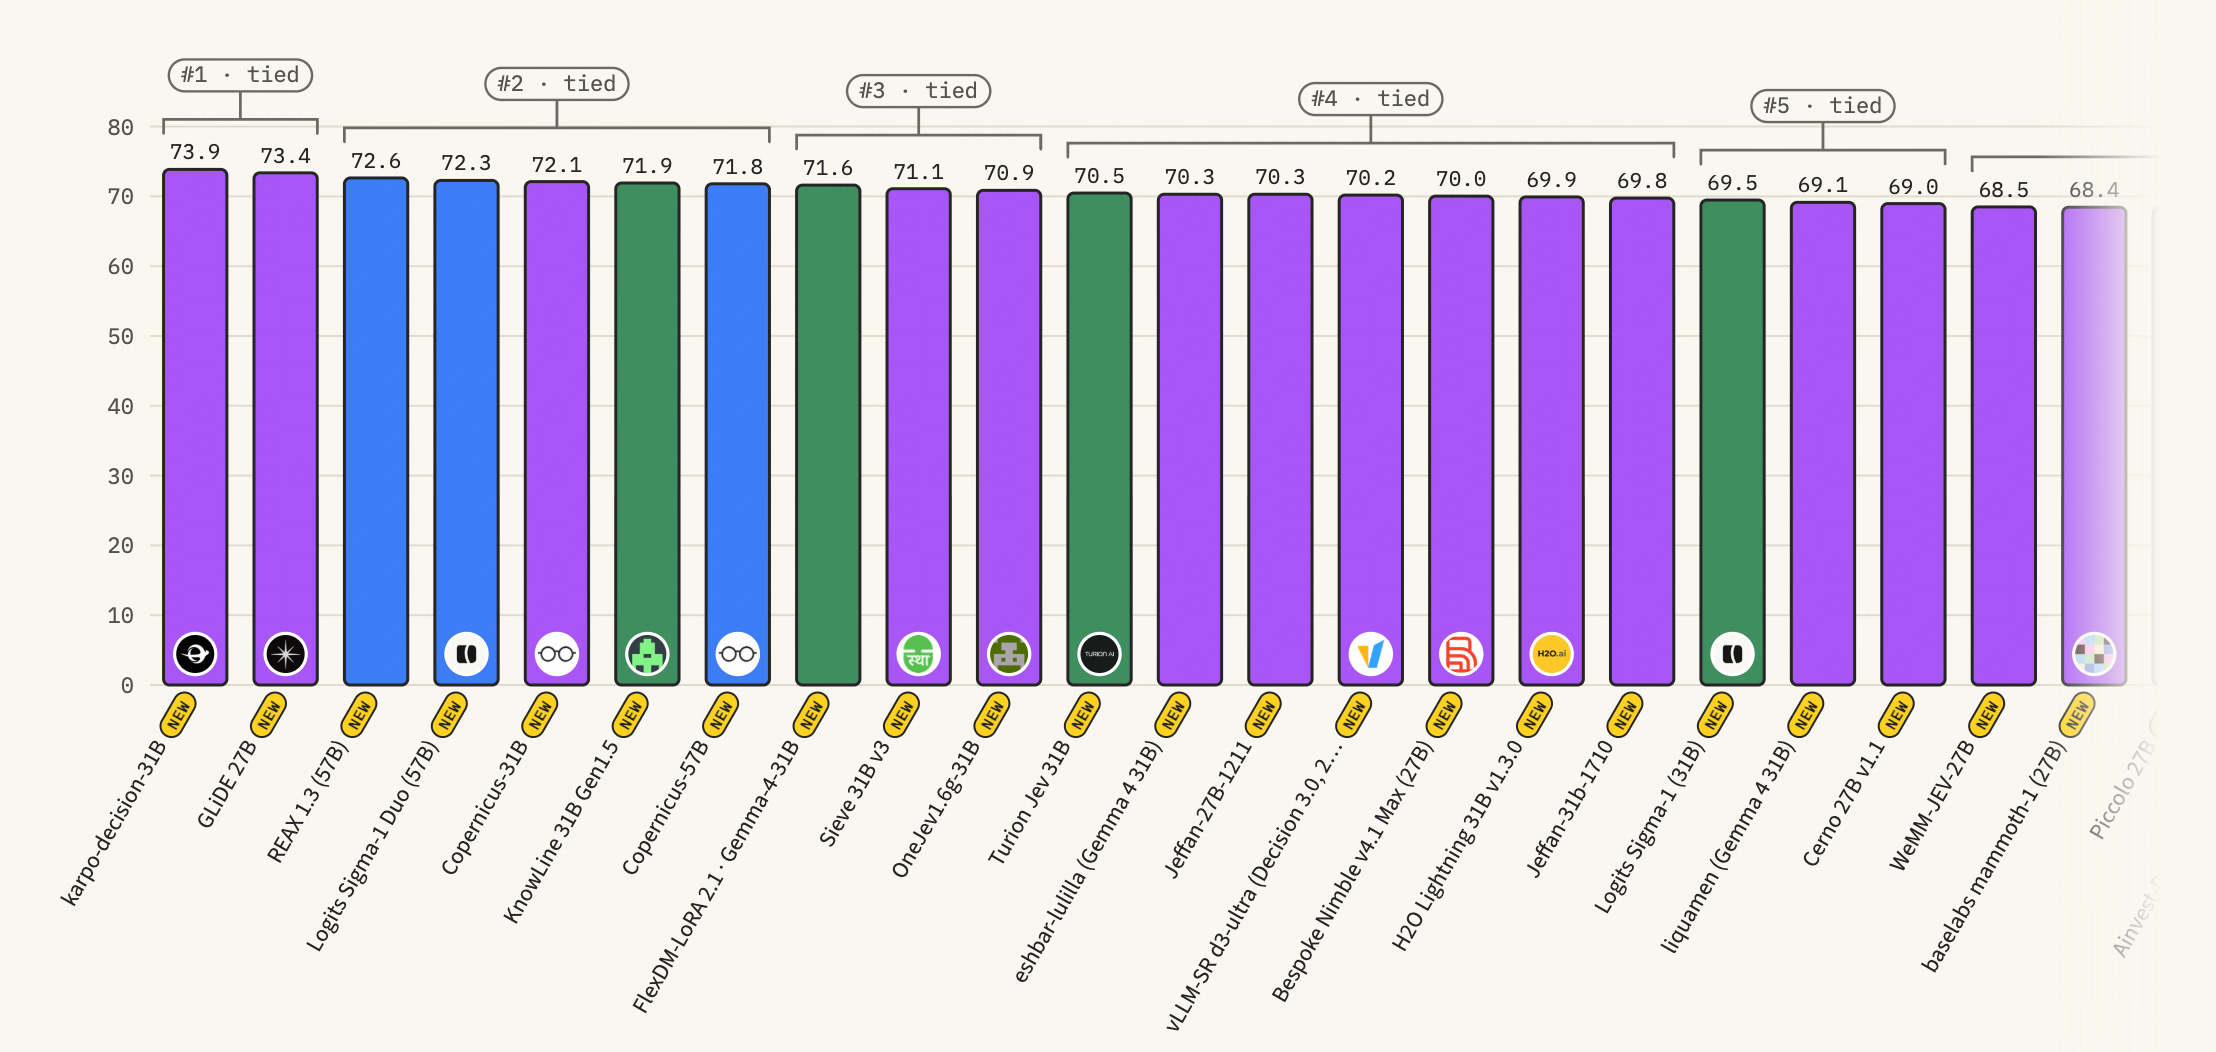
看图,Decision Index 0.4.1榜单,2026年11月12日,karpo-decision-31B以73.9分排第一。
决策模型是什么
传统LLM是生成式:你问它问题,它一个字一个字往外蹦,你再从文本里解析答案。决策模型不这么做。每个选项被编成代码,模型在指定位置读取一个线性头的分数,softmax后直接给出概率。
好处是:
- 答案永远是合法选项之一,不会出现格式错误
- 每个答案都带置信度,可以设阈值自动处理
- 快,因为没有自回归解码
比如问“这个订单能不能退货?”,模型返回P(能)=0.82,P(不能)=0.18。你可以让0.8以上的自动通过,剩下的转人工。
性能数据
Karpo决策31B在多个基准上表现:
| 指标 | 数值 |
|---|---|
| Decision Index Full | 73.9(#1) |
| JevBench Capability | 87.2(#3) |
| 中位延迟(单GPU) | 94ms |
| 校准误差 | 4.8点 |
它支持三类问题:判断题(noul)、选择题(choice,最多255个选项)、评分题(score)。输入支持文本和图片,上下文32k tokens。
视频演示:
模型家族
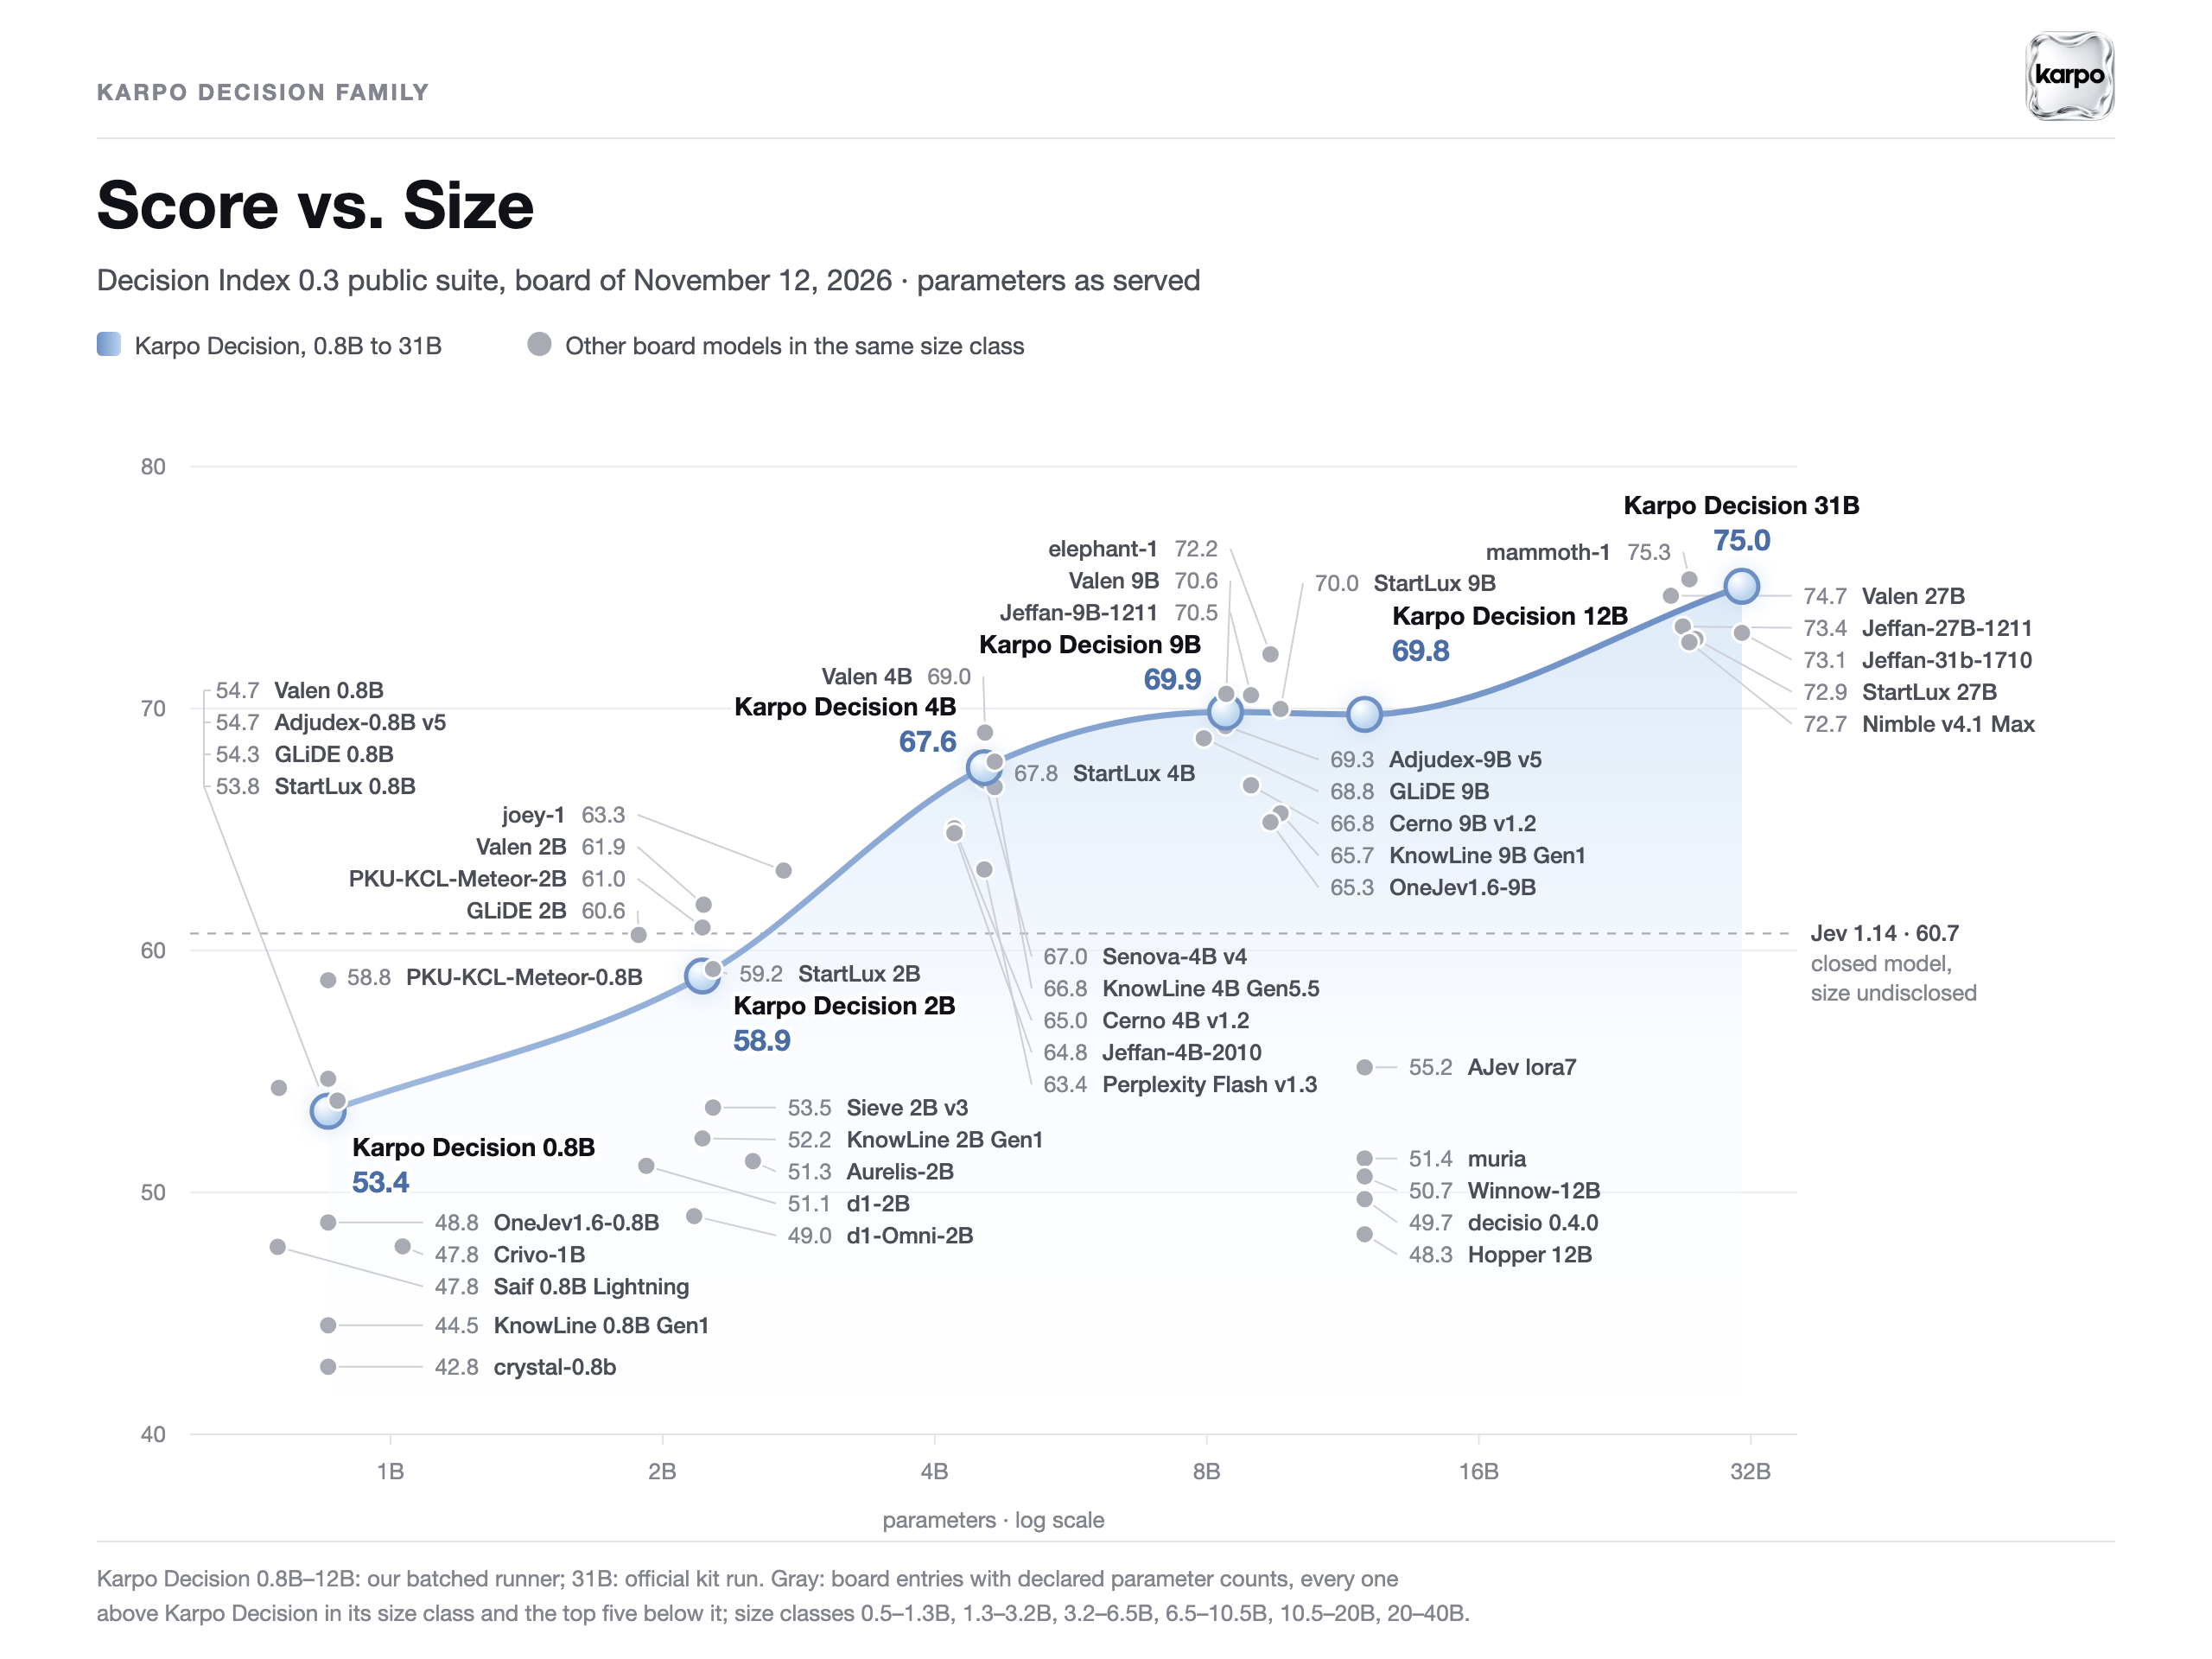
除了31B,还有0.8B、2B、4B、9B、12B五个尺寸,全部开源。小模型适合资源受限的场景,31B适合高精度场景。
怎么用
安装很简单:
pip install "karpo-decision @ git+https://github.com/machinepulse-ai/karpo-decision"
加载模型:
from huggingface_hub import snapshot_download
from karpo_decision.decider import Decider

path = snapshot_download("MachinePulseAI/karpo-decision-31B")
decider = Decider.from_pretrained(path, device="cuda")

response = decider.decide({
    "state": "Order 1182: the customer asks to return a blender bought 45 days ago. Policy: returns within 30 days.",
    "questions": {
        "eligible": {"type": "noul", "instructions": "Is the return eligible under the policy?"},
        "action": {"type": "choice", "instructions": "What should the agent do?",
                   "criteria": {"refund": "Issue a full refund", "decline": "Politely decline the return",
                                "escalate": "Escalate to a supervisor"}},
    },
})
print(response["answers"])
权重在Hugging Face上,Apache 2.0许可,自己托管。单张RTX PRO 6000就能跑,峰值内存60GB左右。
适合干什么
官方建议的场景:搜索、推荐、工具选择、模型路由、浏览器操作。这些事本质都是“从一堆选项里挑一个”,决策模型直接给概率,比让LLM写一段JSON快得多。
有网友评论说,模型路由是第一个该试的场景:“一次前向传播给出每个选项的概率,路由的成本比被路由的调用本身还低。”还有人说,以前很多用LLM+结构化输出做的简单分类,都可以迁移到这个模型上。
也有质疑:榜单是模型作者自己跑的,需要第三方复现。这很正常,观望一下。
训练细节也值得一提。他们用了RSI(递归自我改进)循环,每轮训练多个候选,评分后融合权重,只在加权分更高时替换模型。最终发布的版本是5个checkpoint的平均,公共分数没变,但隐藏域准确率高了1.6个点。
一句话
如果你在构建AI agent,需要快速、可靠、带置信度的判断,这个模型值得试试。
链接:
参考:Santiago推文、LeahW推文、Karpo官方博客。
发布时间: 2026-11-21 04:47