RAG 不需要向量数据库了?PageIndex 用树索引在 FinanceBench 上跑到 98.7%
不切块、不 embedding、不向量检索。PageIndex 把文档建成树索引,让 LLM 自己翻页找答案。FinanceBench 98.7% 的成绩之外,适用边界和成本也被讨论。
一条推文说,整个 RAG 行业要完蛋了。
推文来自 @byteonai,主角是 PageIndex,一个由 VectifyAI 开源的检索方案。它号称不需要向量数据库、不 embedding、不 chunking、不做相似度搜索。做法是把文档建成树索引,让 LLM 像人翻书一样在树上找答案。在金融文档问答 benchmark FinanceBench 上,它跑到 98.7% 准确率,超过所有向量 RAG。项目 100% 开源。

RAG 原本是怎么做的
RAG 解决一个问题:让大模型回答它没训练过的内容。传统流程是把文档切成小段,用 embedding 转成向量,存进向量数据库,提问时做相似度检索,再把最相关的几段拼进 prompt。
这套流程的问题在于:相似不等于相关。一段话语义接近,不一定是问题真正需要的证据。PageIndex 换了个思路。
PageIndex 做了什么
PageIndex 把文档结构本身变成索引,不切块。流程分两步:
- 根据文档版式生成树状结构,这一步不依赖 LLM。
- LLM 在树上做推理式检索,像人看目录、翻到对应章节。
官方给了一张流程图:
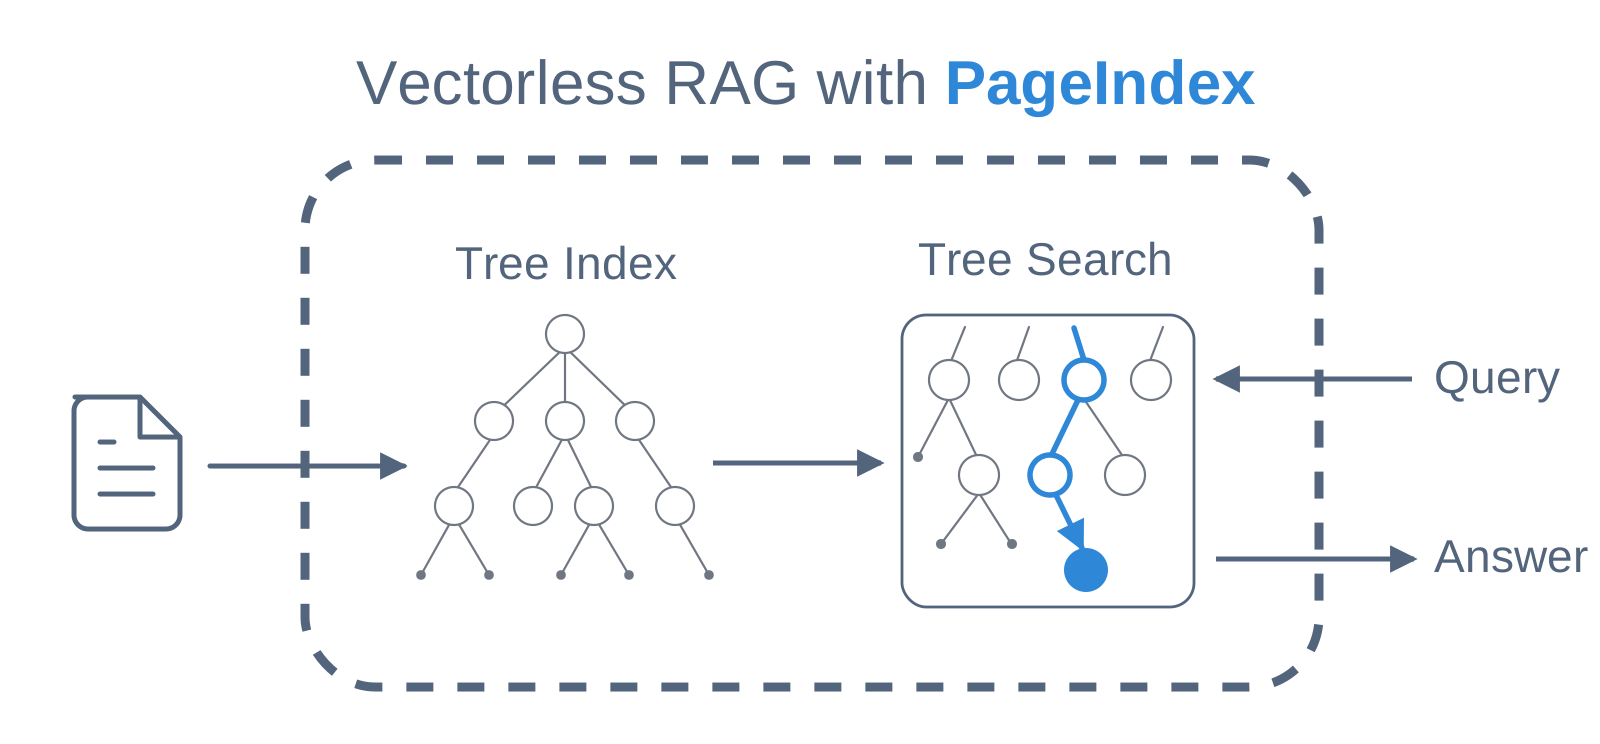
树的节点类似目录:标题、页码范围、摘要。检索时 LLM 判断该往哪个分支走,而不是拿文本做向量距离。灵感来自 AlphaGo。索引和文档都留在本地目录 .pageindex,不需要单独的向量库。
数据:准确率和成本
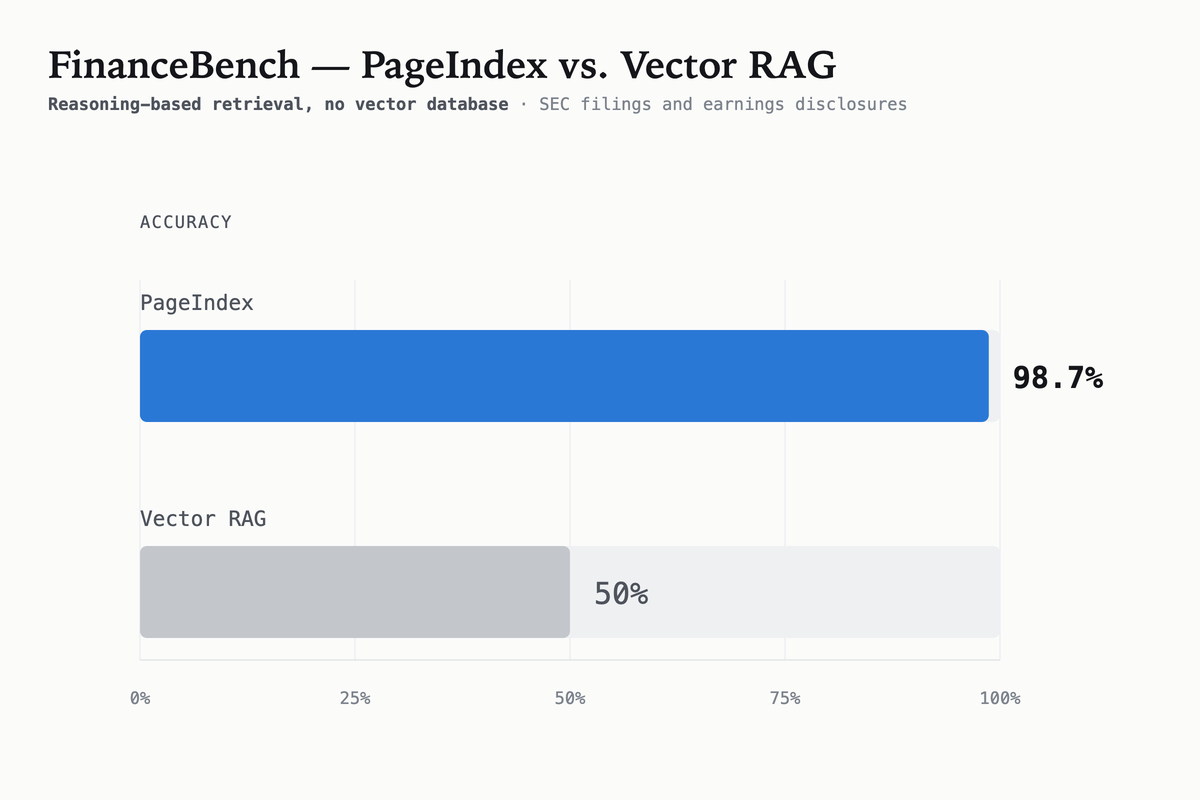
PageIndex 在 FinanceBench 上 98.7%,官方对比里向量 RAG 大概 50%。差距很大,但注意 FinanceBench 是财务文档问答,结构清晰,恰好是树索引擅长的领域。
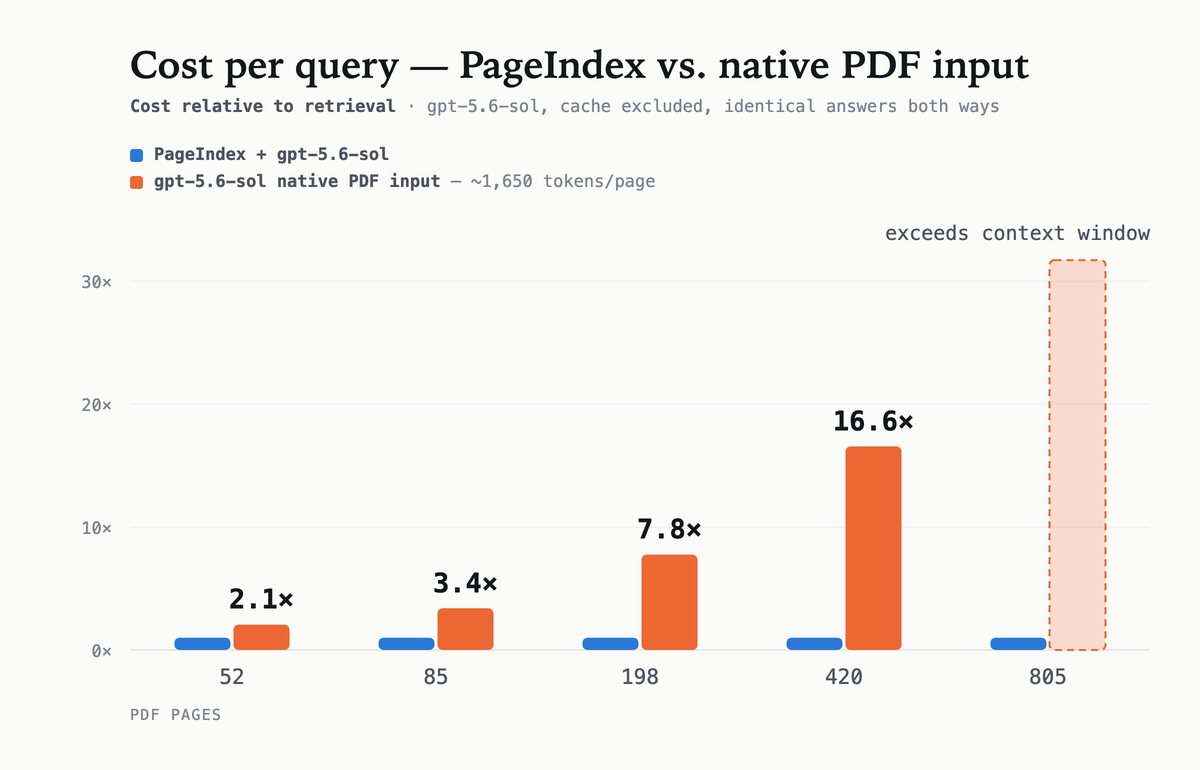
成本方面,本地建索引约 0.001 美元/页,1000 页的文档花一美元左右、几分钟。查询成本不随文档长度增长,因为 LLM 只读它推理路径上的节点。对比直接把 PDF 塞给模型,52 页贵 2.1 倍,420 页贵 16.6 倍,805 页直接超出上下文窗口。
代码很简单:
from pageindex import PageIndexClient

client = PageIndexClient(
    index='gpt-6-luna',  # 建索引的模型
    chat='gpt-6.2-sol',  # 检索的模型
)
doc_id = client.submit_document('report.pdf')['doc_id']
answer = client.chat('What was the 2023 operating margin?', doc_id=doc_id)
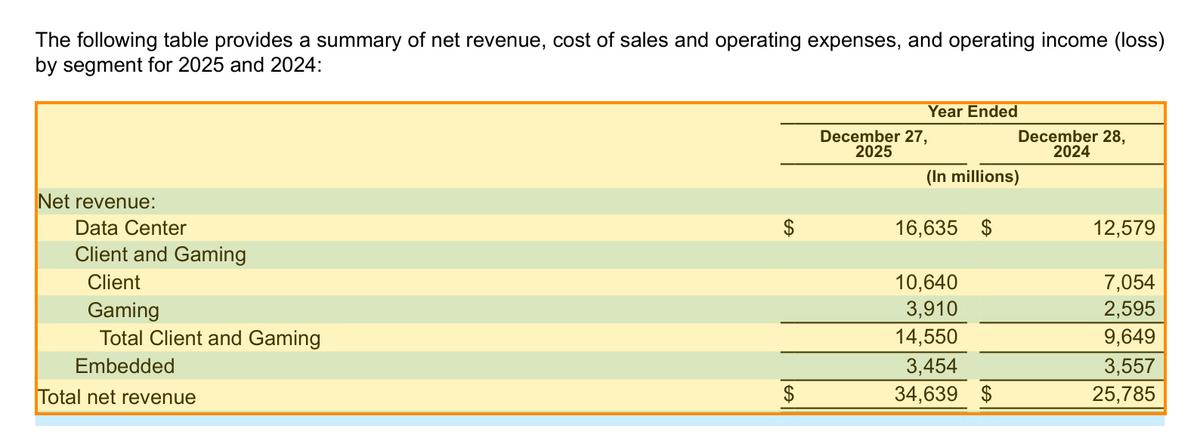
本地模式支持文本型 PDF。扫描版和图片类文档要用 PageIndex Cloud。Cloud 版带框引用,答案能标注到具体页面和证据区域。比如在 AMD 2025 年 10-K 上问总净营收,它会回答 346.39 亿美元,并指向第 71 页的表格框。
社区怎么看
推文底下有叫好的,也有泼冷水的。
有网友说,PageIndex 并没有把 RAG 干掉,retrieval 只是从向量搜索换成了走树,本质上还是 RAG。它适合年报、政策文件这类长且有清晰目录的文档;但如果是几千份没结构、没目录的工单、聊天记录、wiki,树很难建起来。而且每次查询要多次 LLM 调用,延迟和成本会随树深度上升。
有网友提到,PageIndex 的扫描件处理能力没有开源。另一网友实测后说,扫描版 PDF 遇到复杂表格和脚注会难受,他靠自适应 chunk(约 200 到 1000 token)和实测检索效果才稳住。
还有网友觉得,用更便宜的国产模型搭知识树,性价比可能更好。也有人说,这种思路不算新,只是最近被重新包装了。还有人调侃,RAG 每个月都要被 cooked 一次。
一个被点赞的观察是:这项目命名很朴素,没叫 HyperC 或 NovaFlux,值得加分。
结论
PageIndex 是一个值得测的开源项目,尤其适合长文档、强结构的场景。但“整个 RAG 行业被 cooked”是标题党。它没有终结向量检索。它只是给检索多了一个可解释、可追踪的选项。在没有清晰结构的文档集上,传统向量 RAG 依然是务实的选择。
发布时间: 2026-11-21 17:58