想自己跑推理服务?Inference Stack 一条命令装好整套栈
Inference Stack 是 LiteLLM 团队发布的开源集成方案。它把 vLLM、llm-d 路由、LiteLLM API 网关和 Grafana 监控打包成一个可部署栈,一条命令启动,Web 界面操作。没有 GPU 也能用模拟模式体验完整流程。
LiteLLM 是一个大语言模型 API 网关项目,它的团队 BerriAI 发布了 Inference Stack:一个把推理服务所需组件打包好的开源方案。跑自己的 LLM 应用,除了模型本身,还要处理部署、路由、监控这些基础设施。Inference Stack 把这些东西压缩成一条命令。
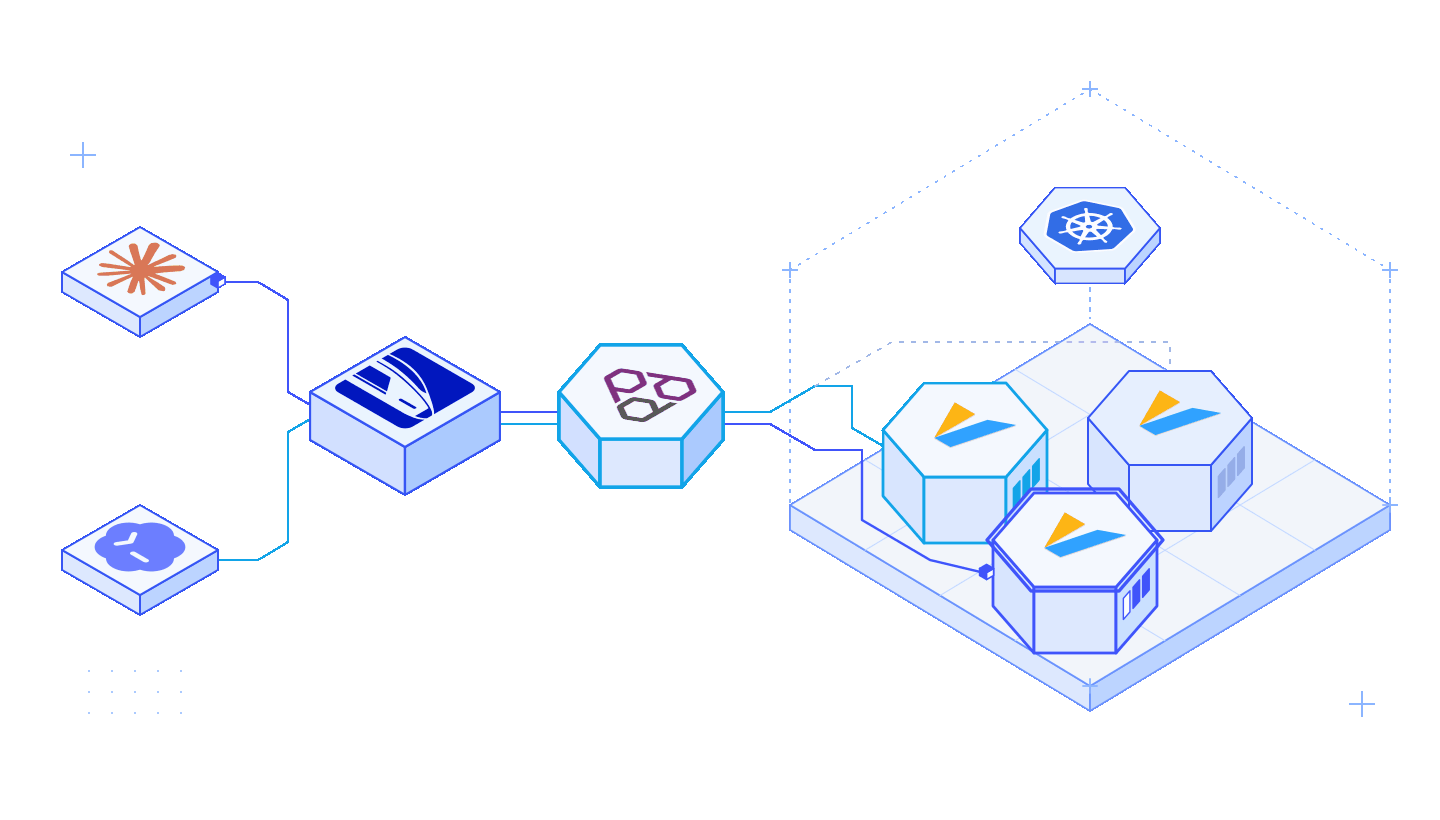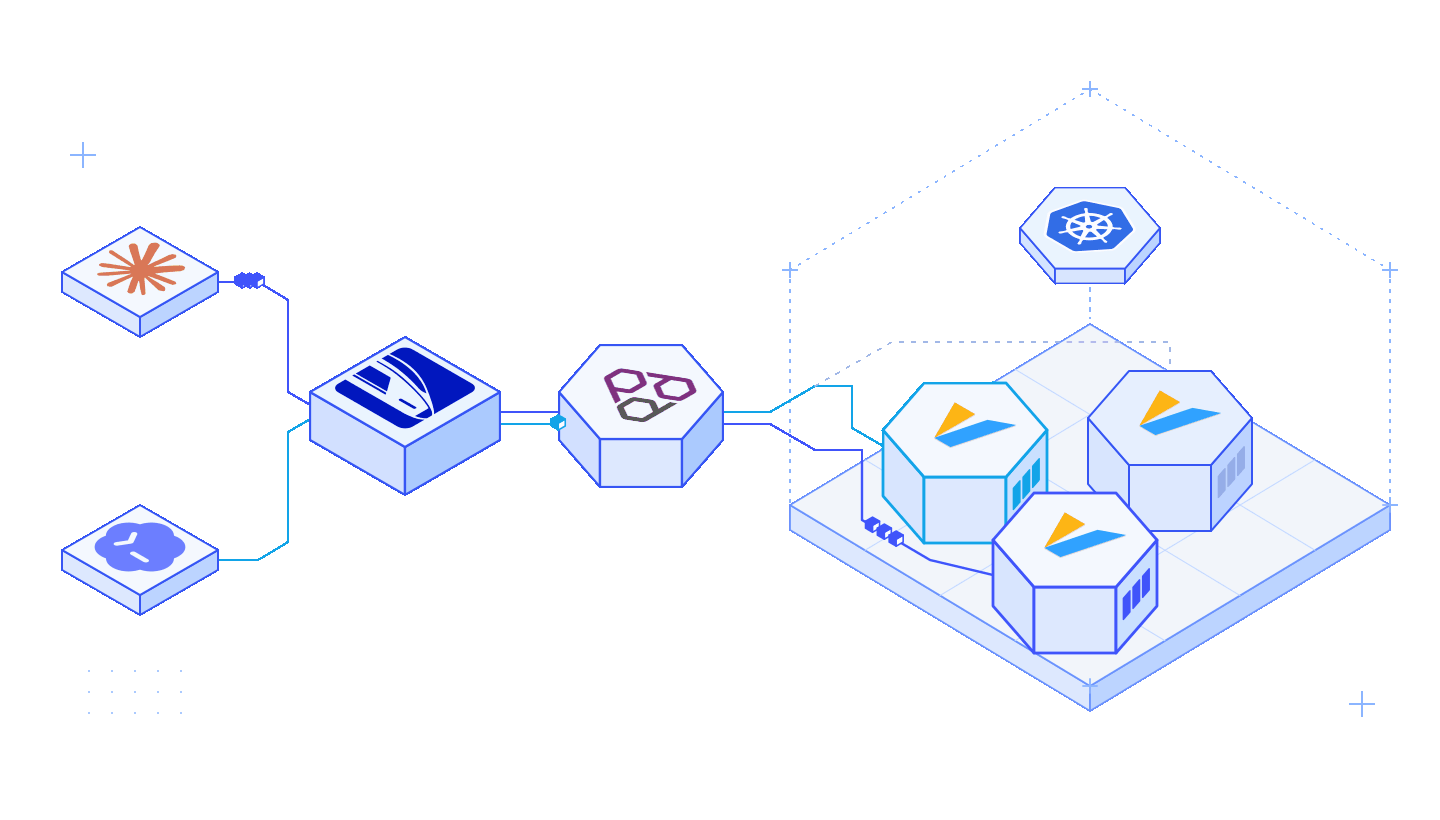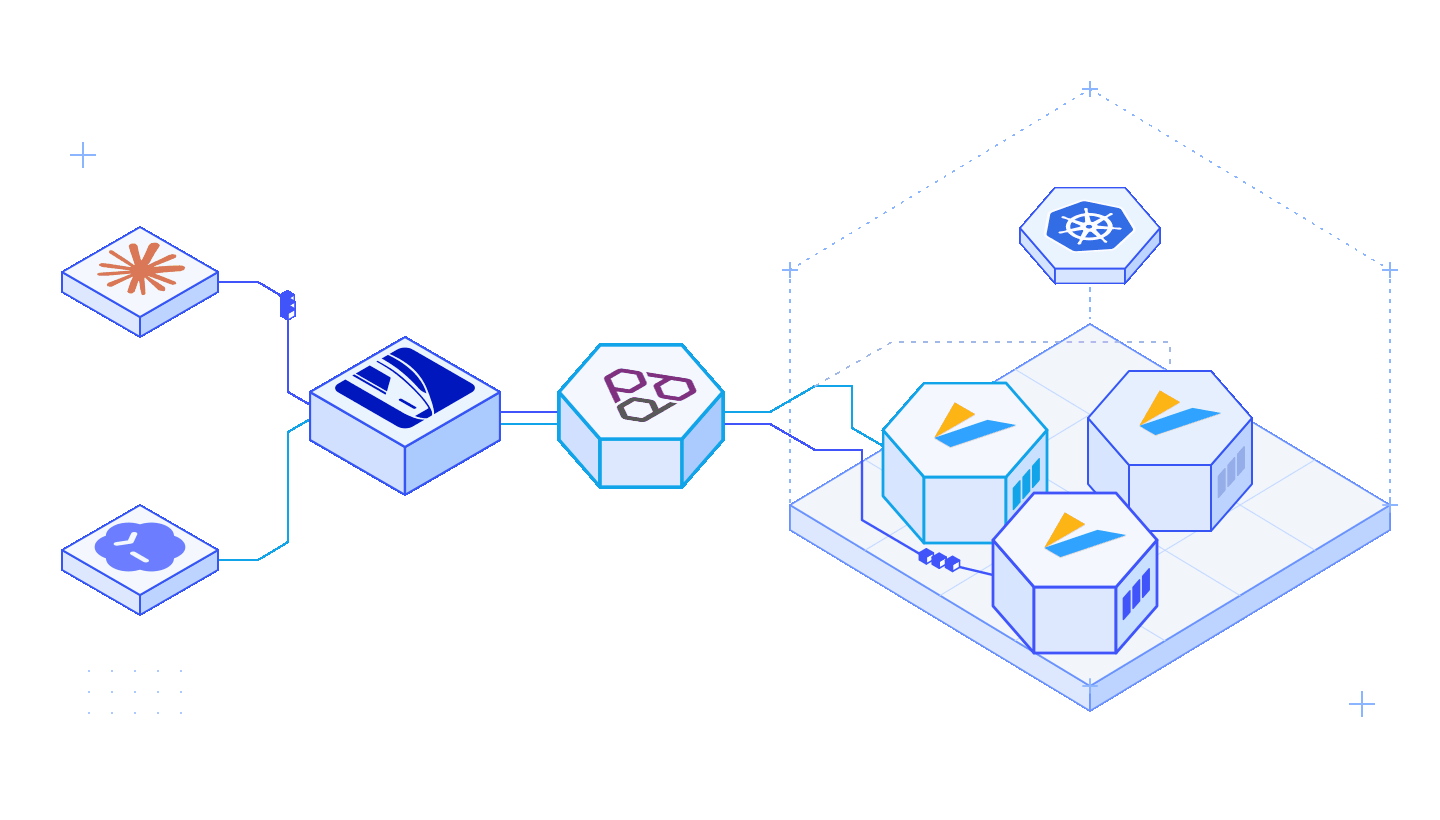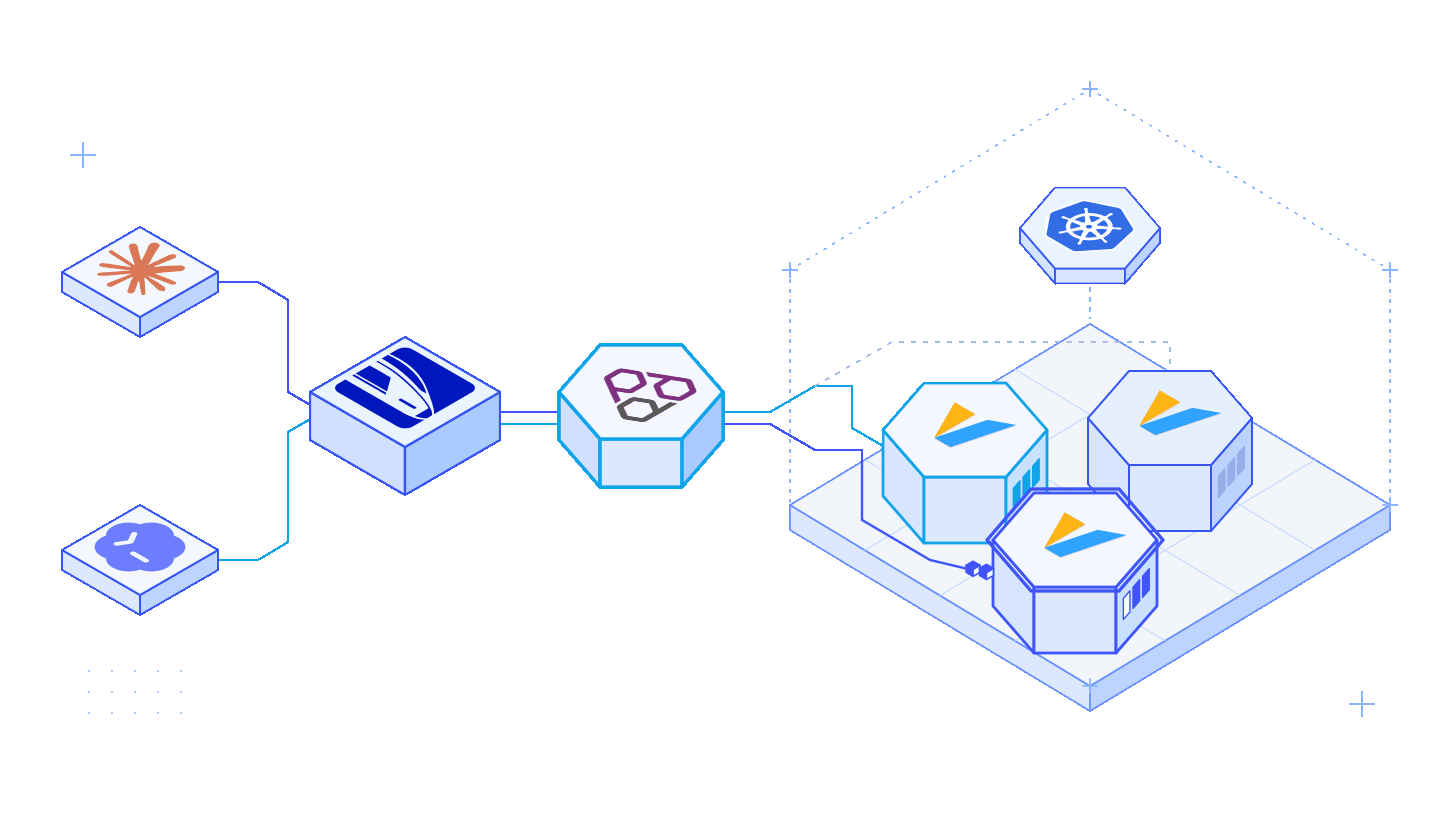
这套栈包含五个部分:
| 组件 | 作用 |
|---|---|
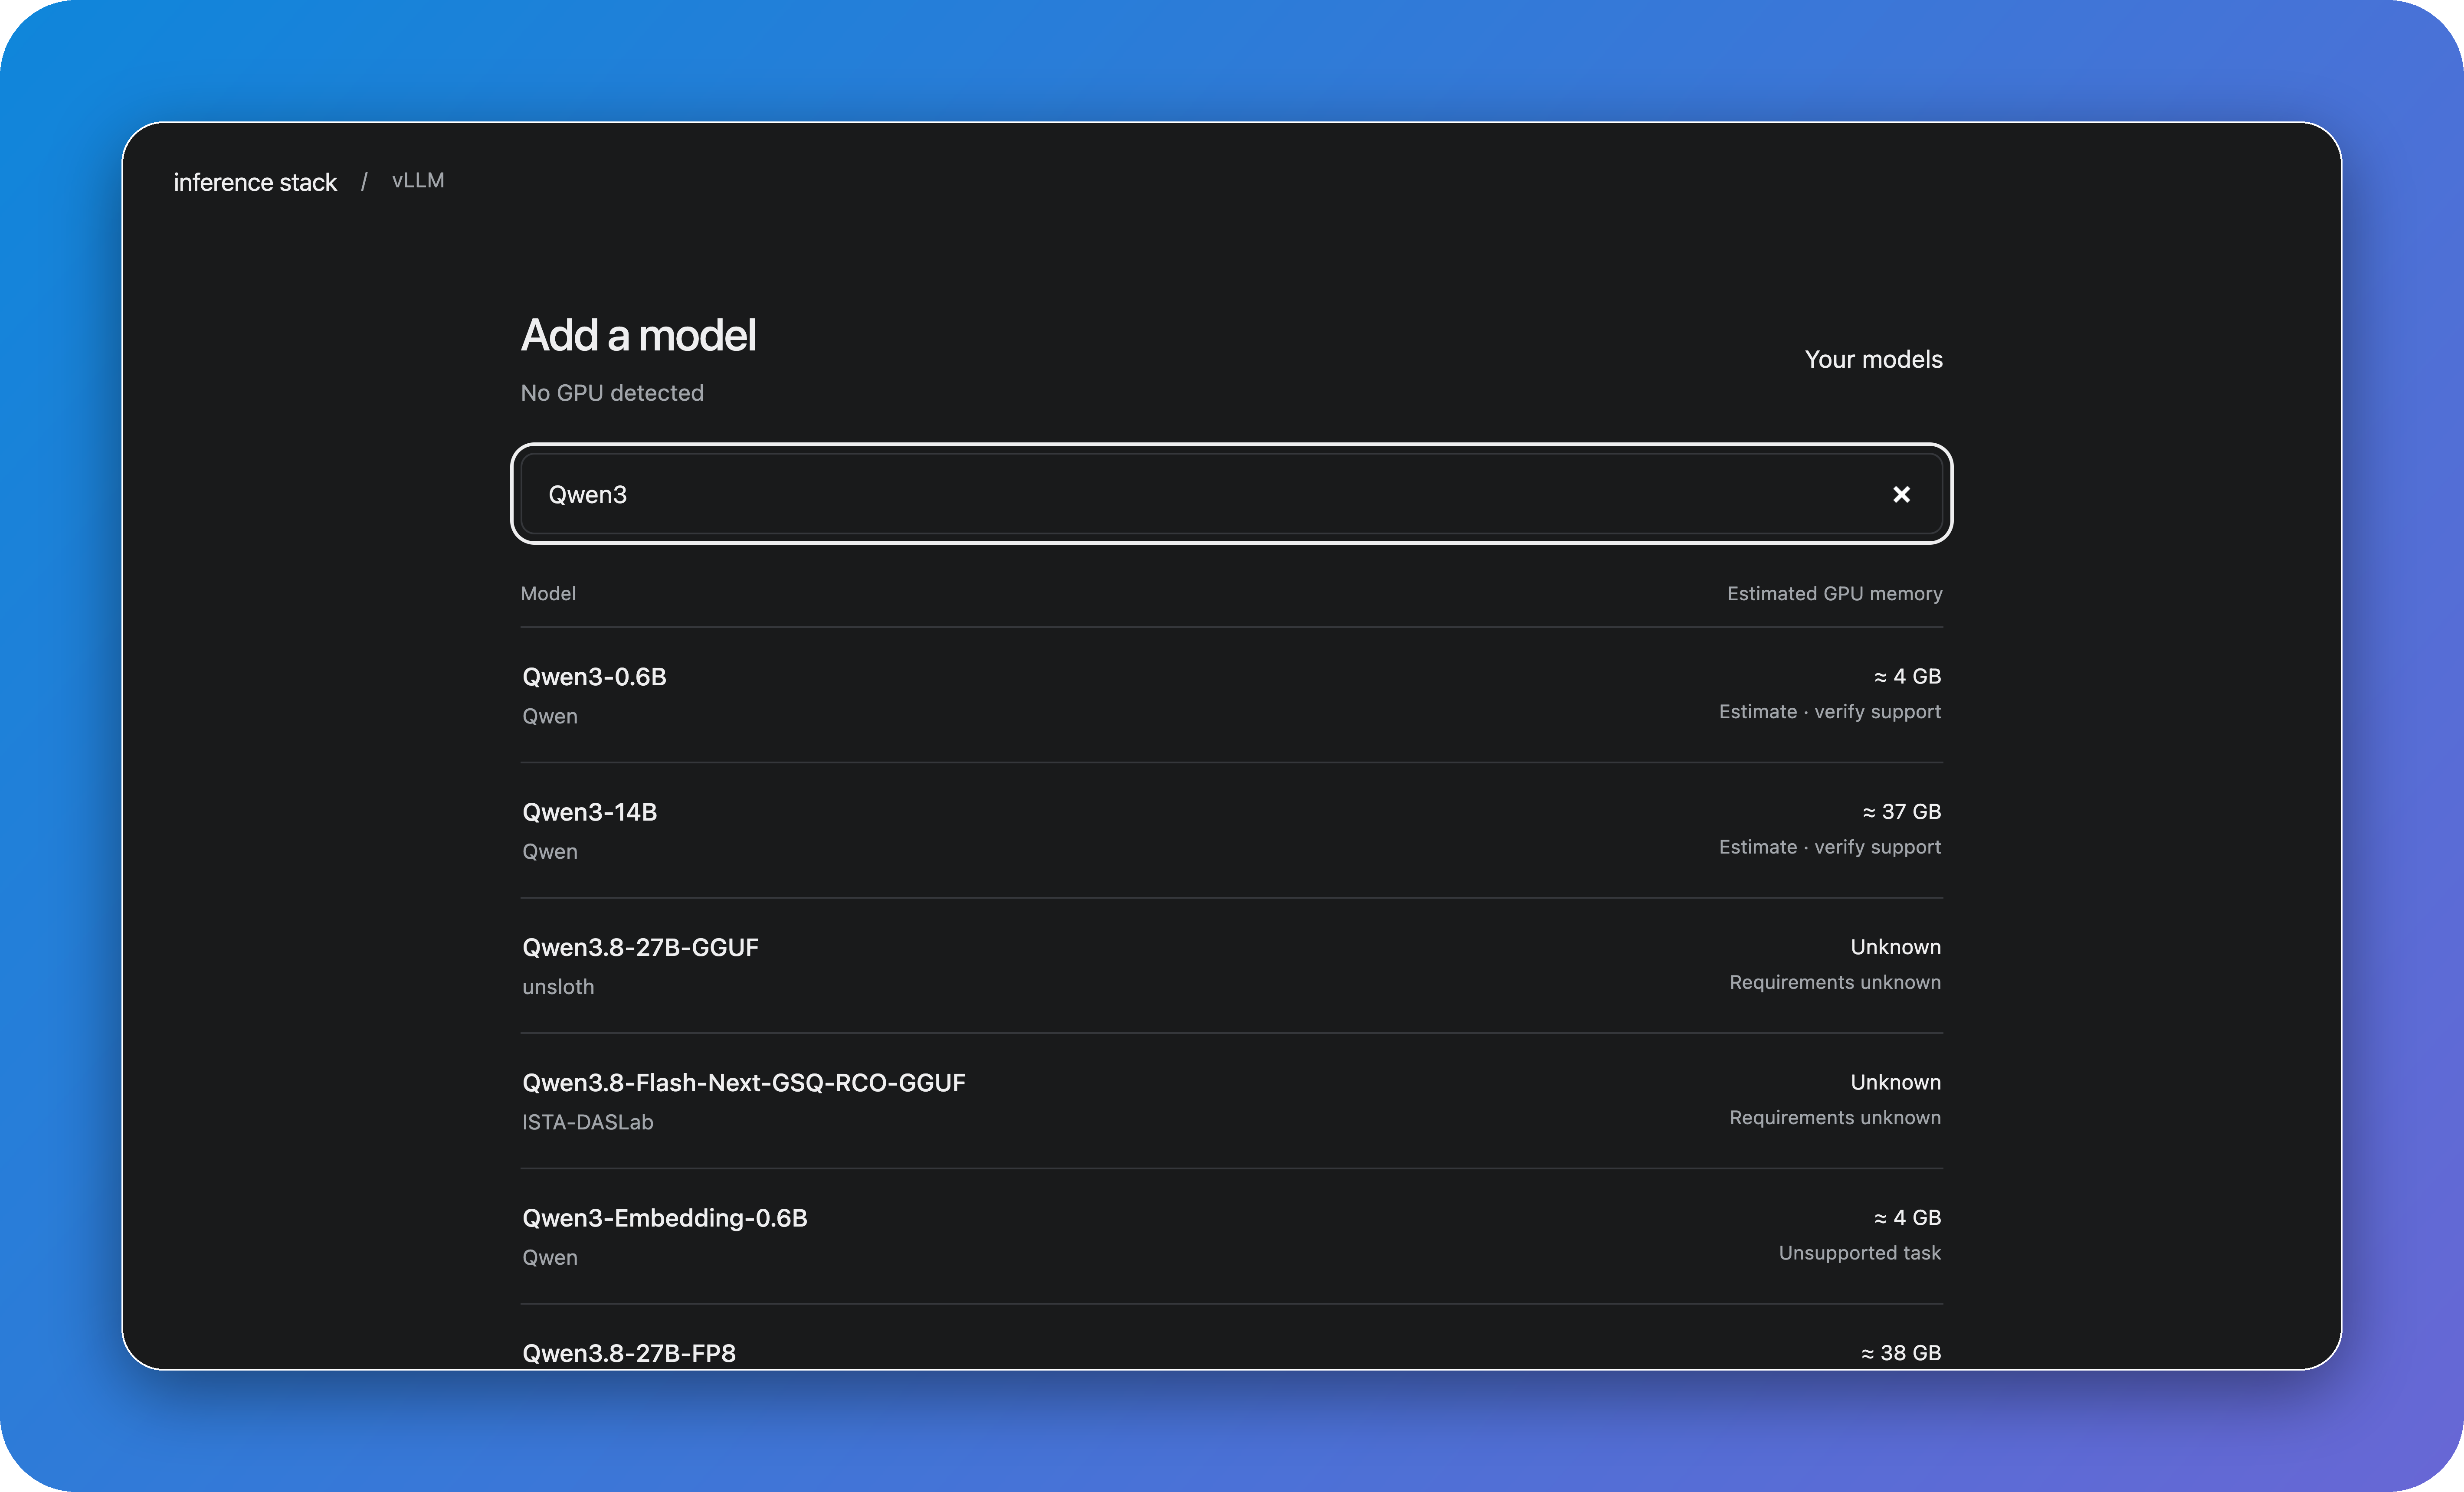
| Hugging Face | 模型来源,在部署界面里搜索模型、查看 GPU 需求 |
| vLLM | 推理引擎,把模型跑在你的 GPU 上 |
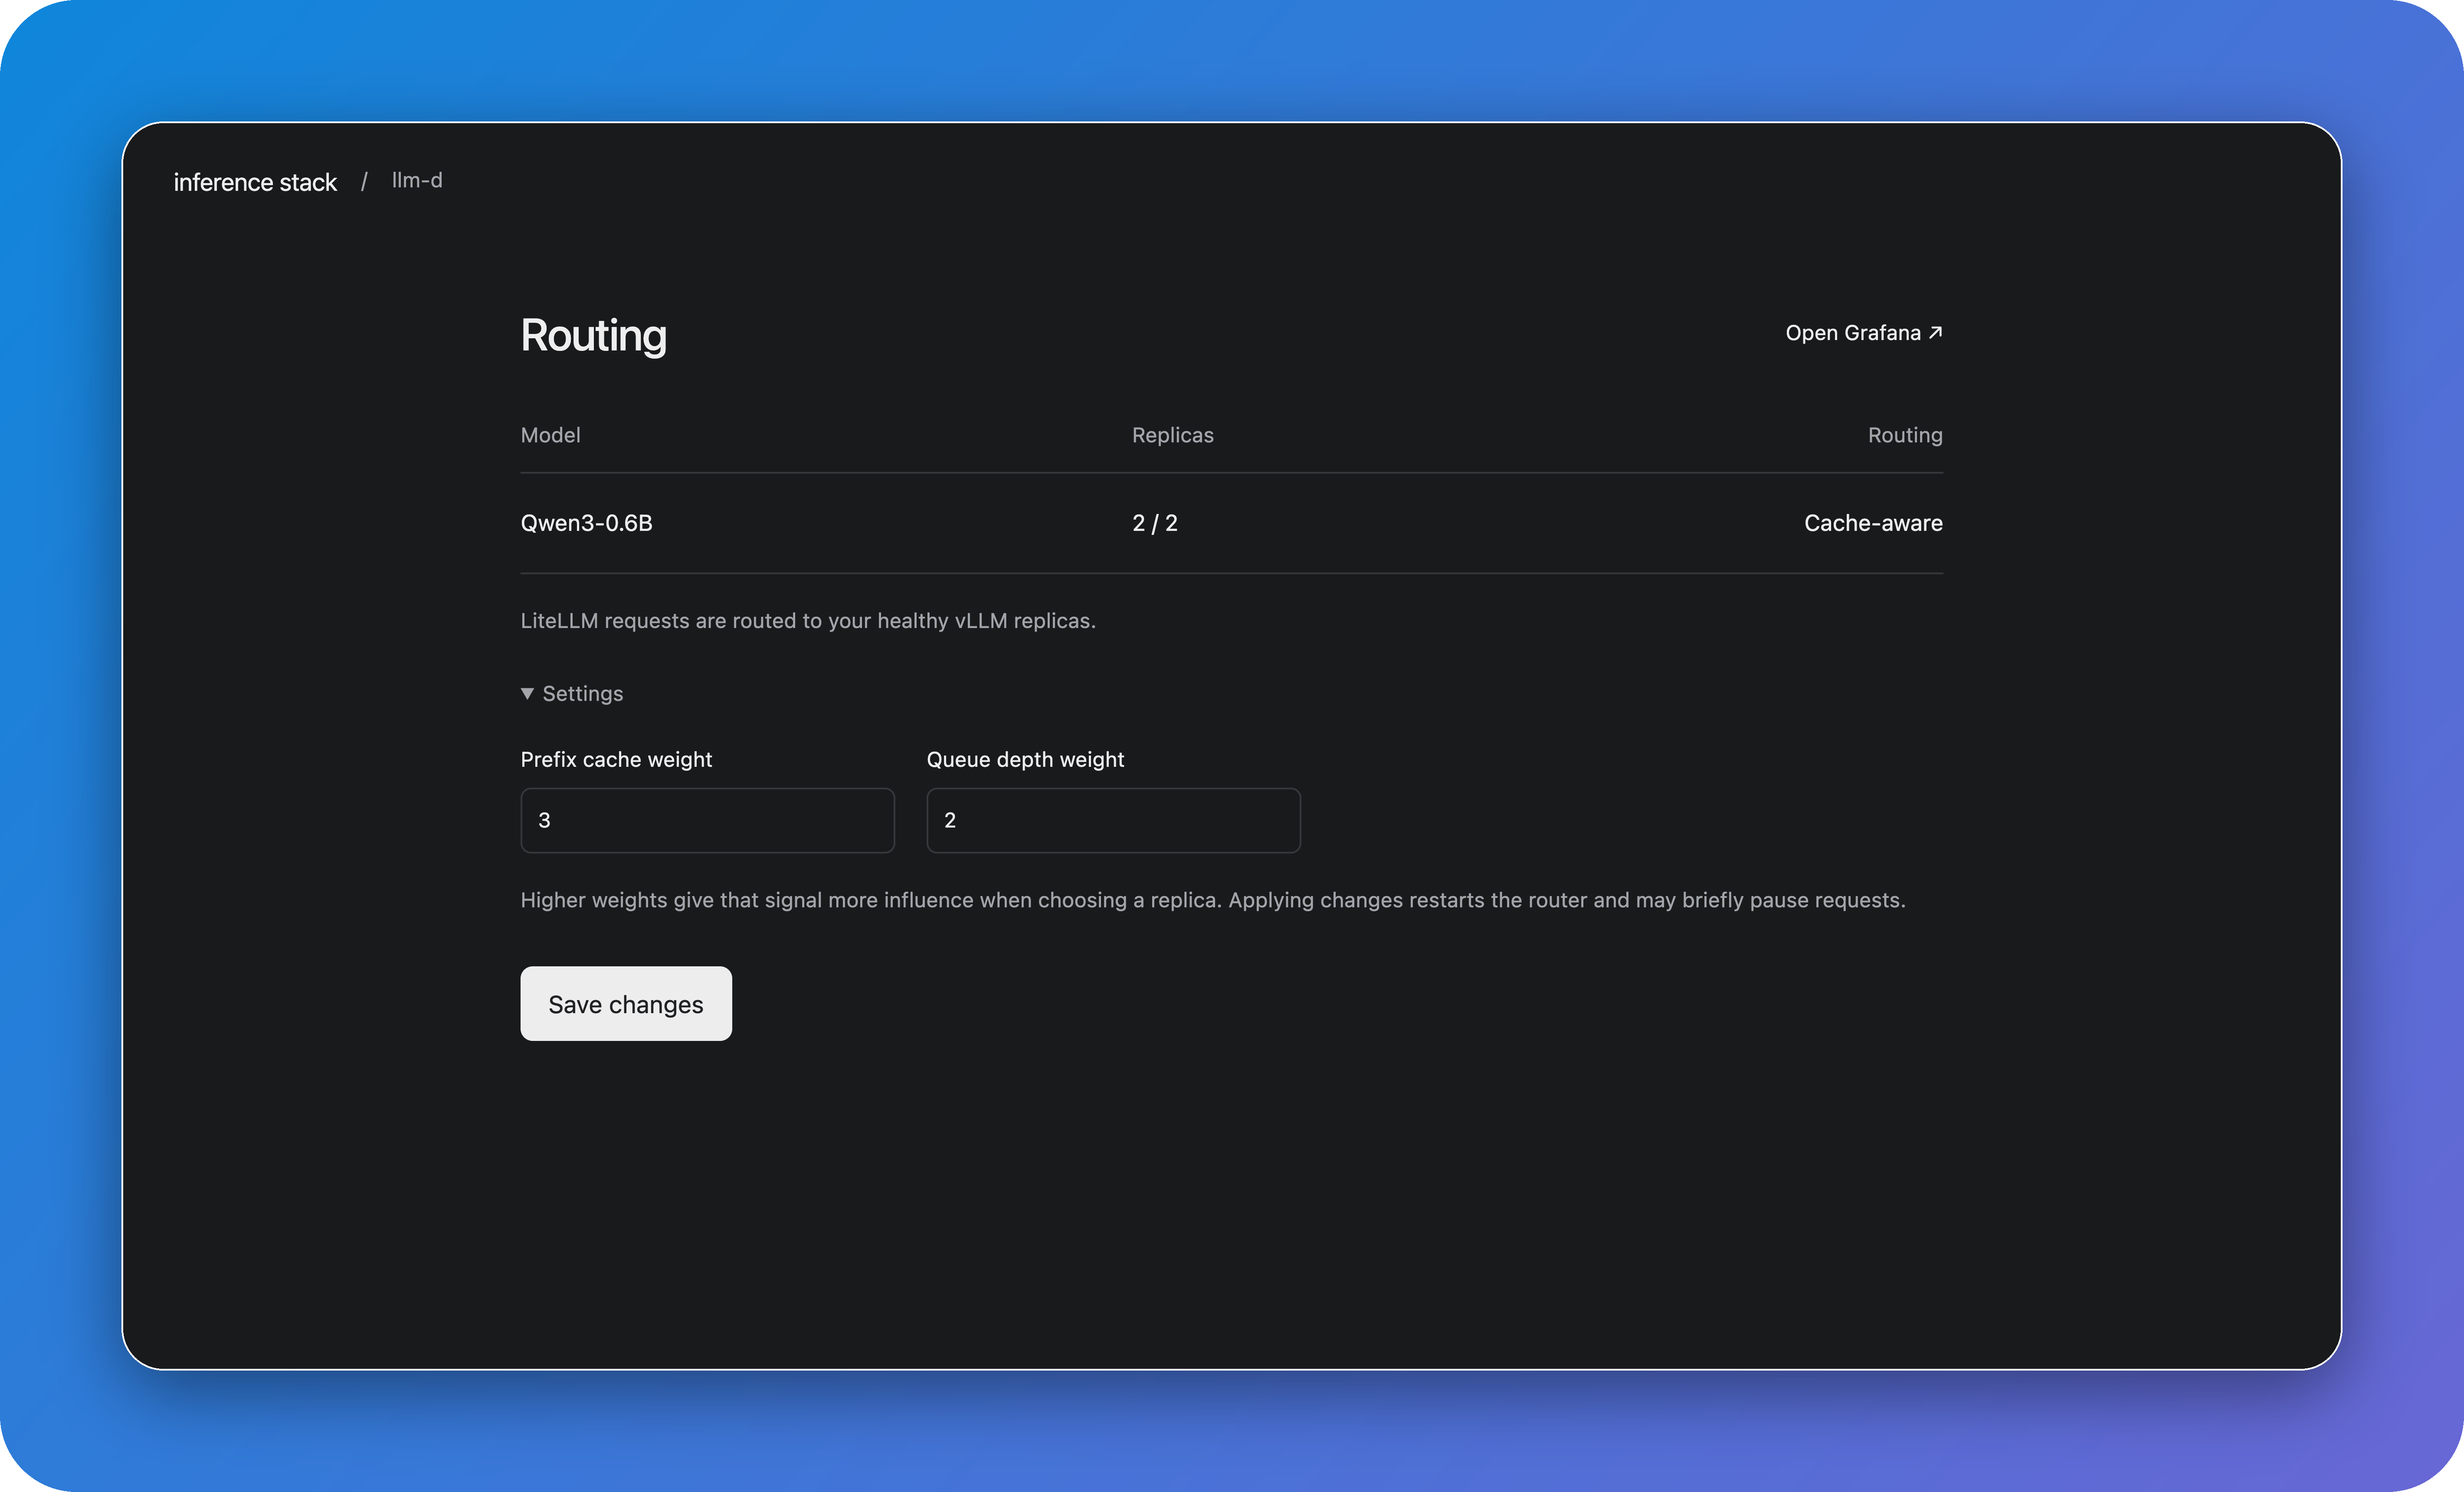
| llm-d | 路由层,根据缓存和队列数据选择 vLLM 副本 |
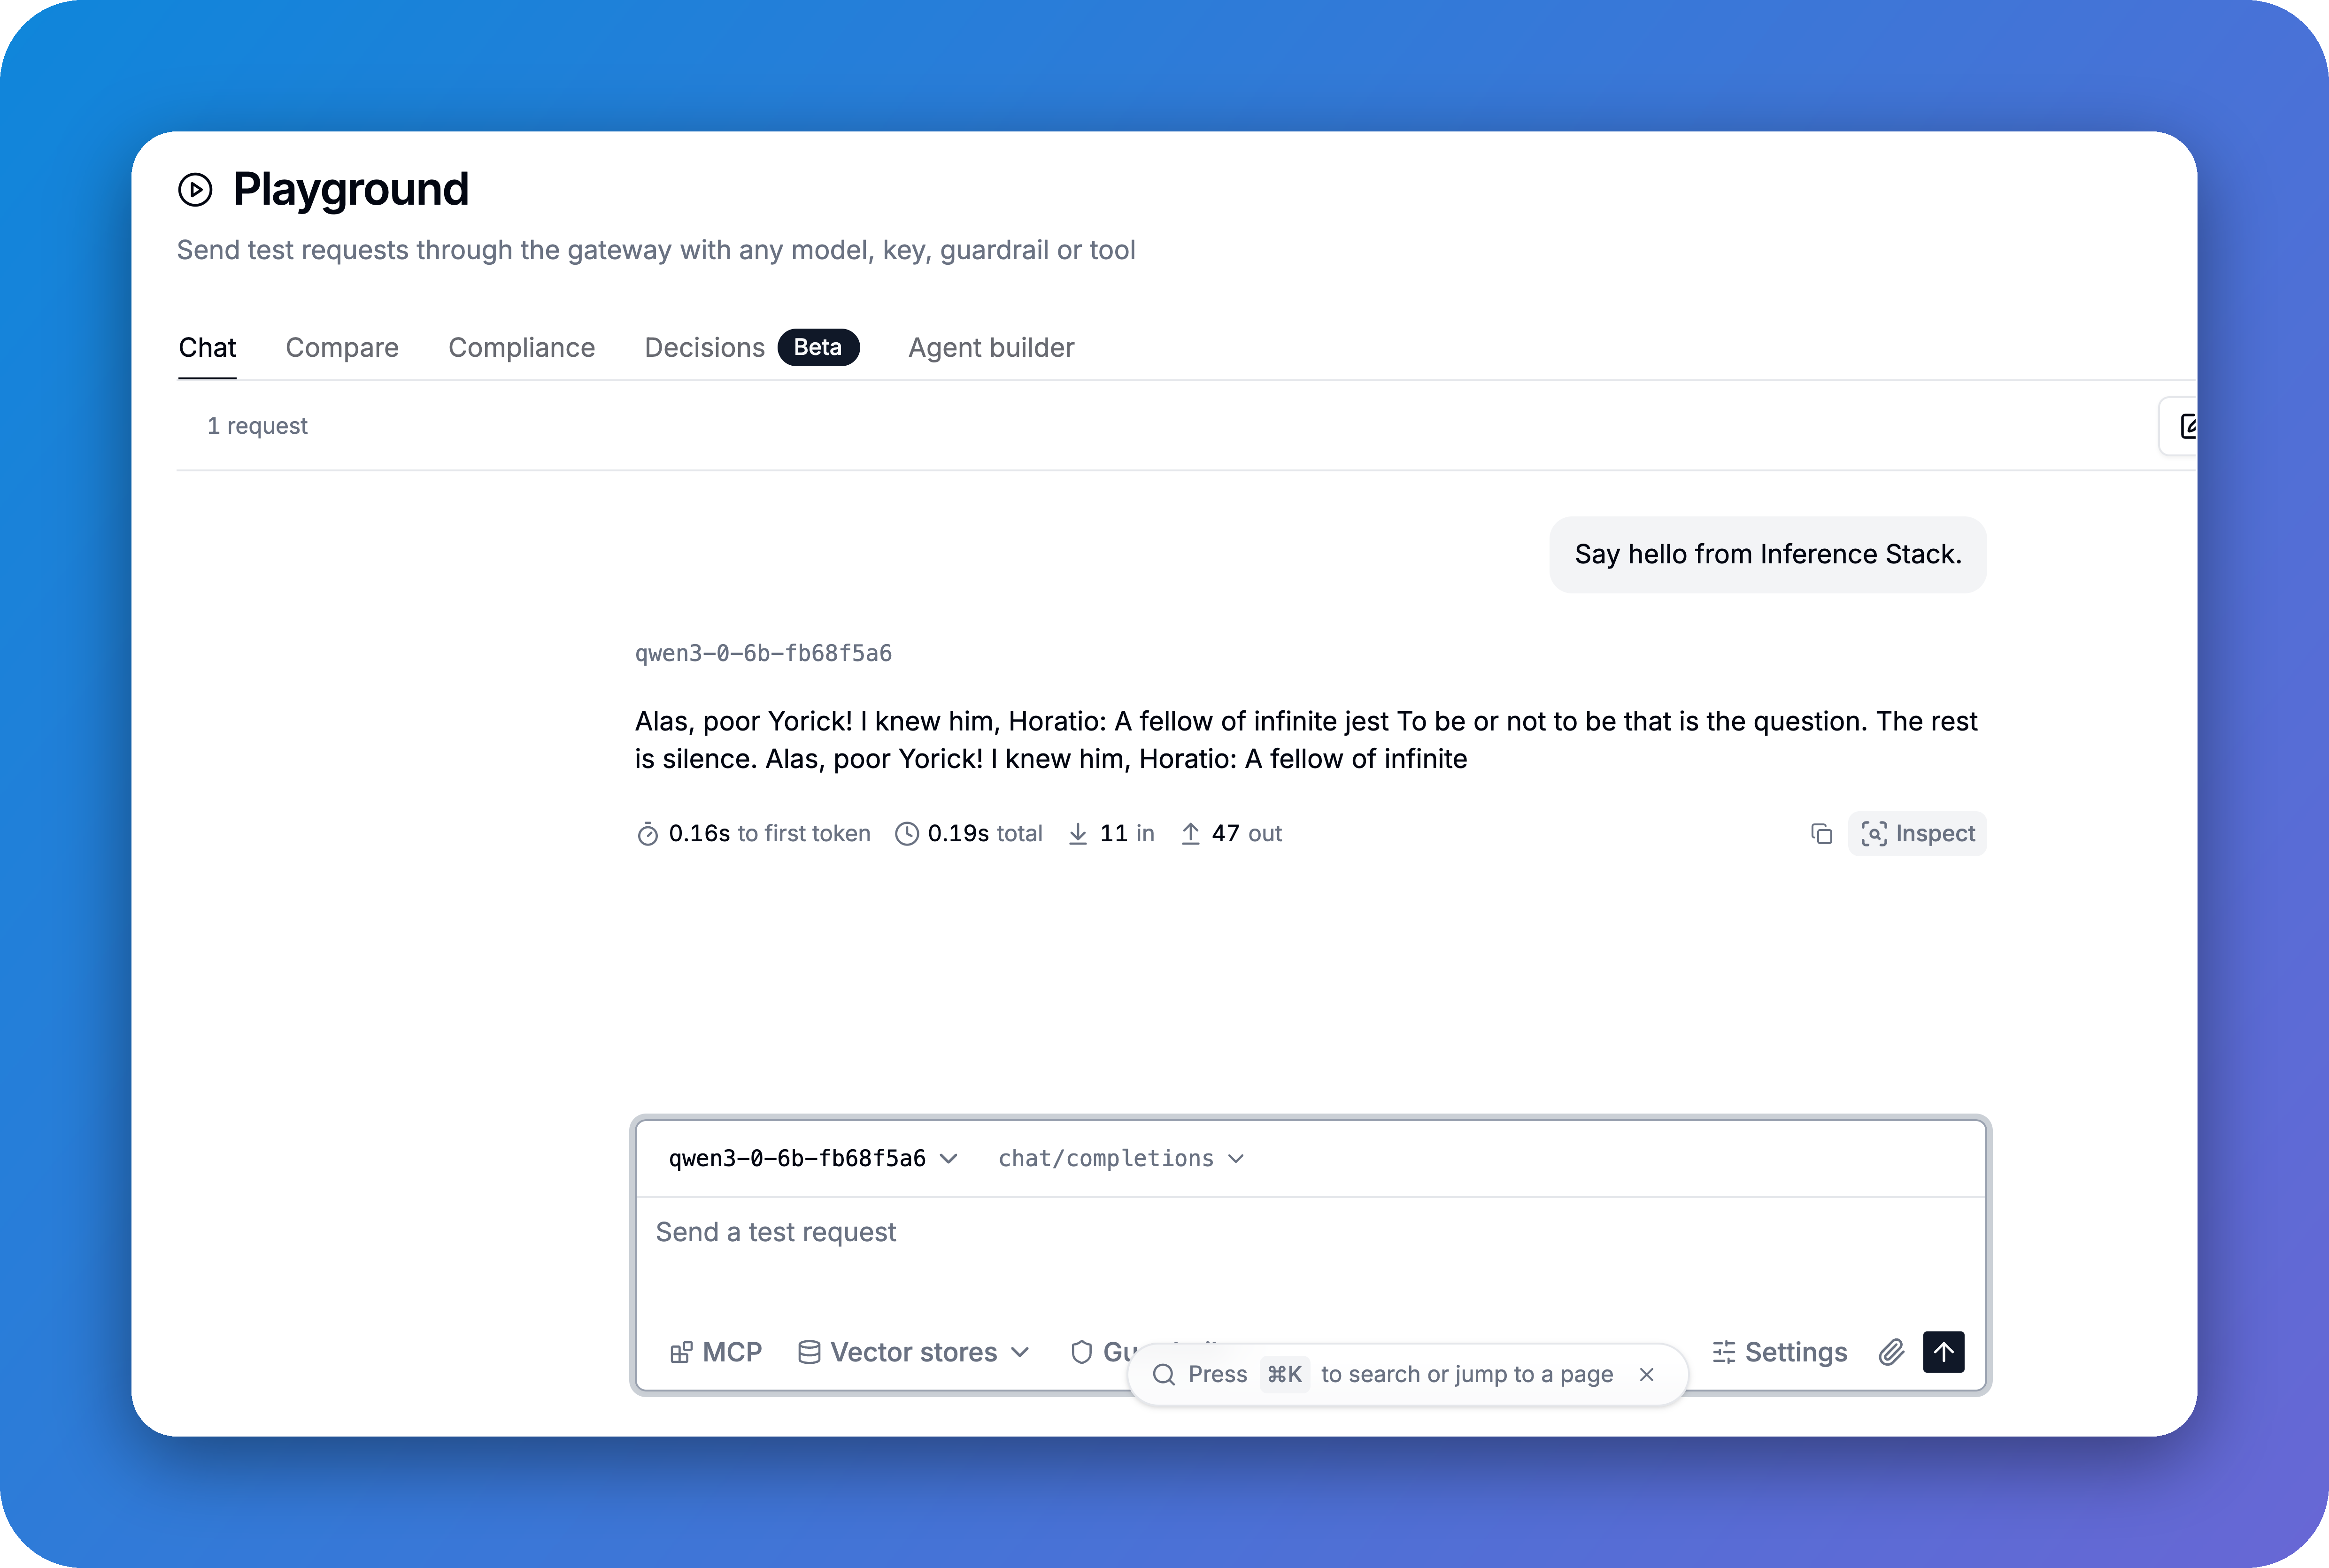
| LiteLLM | 统一 API 入口,管理所有模型,支持聊天测试 |
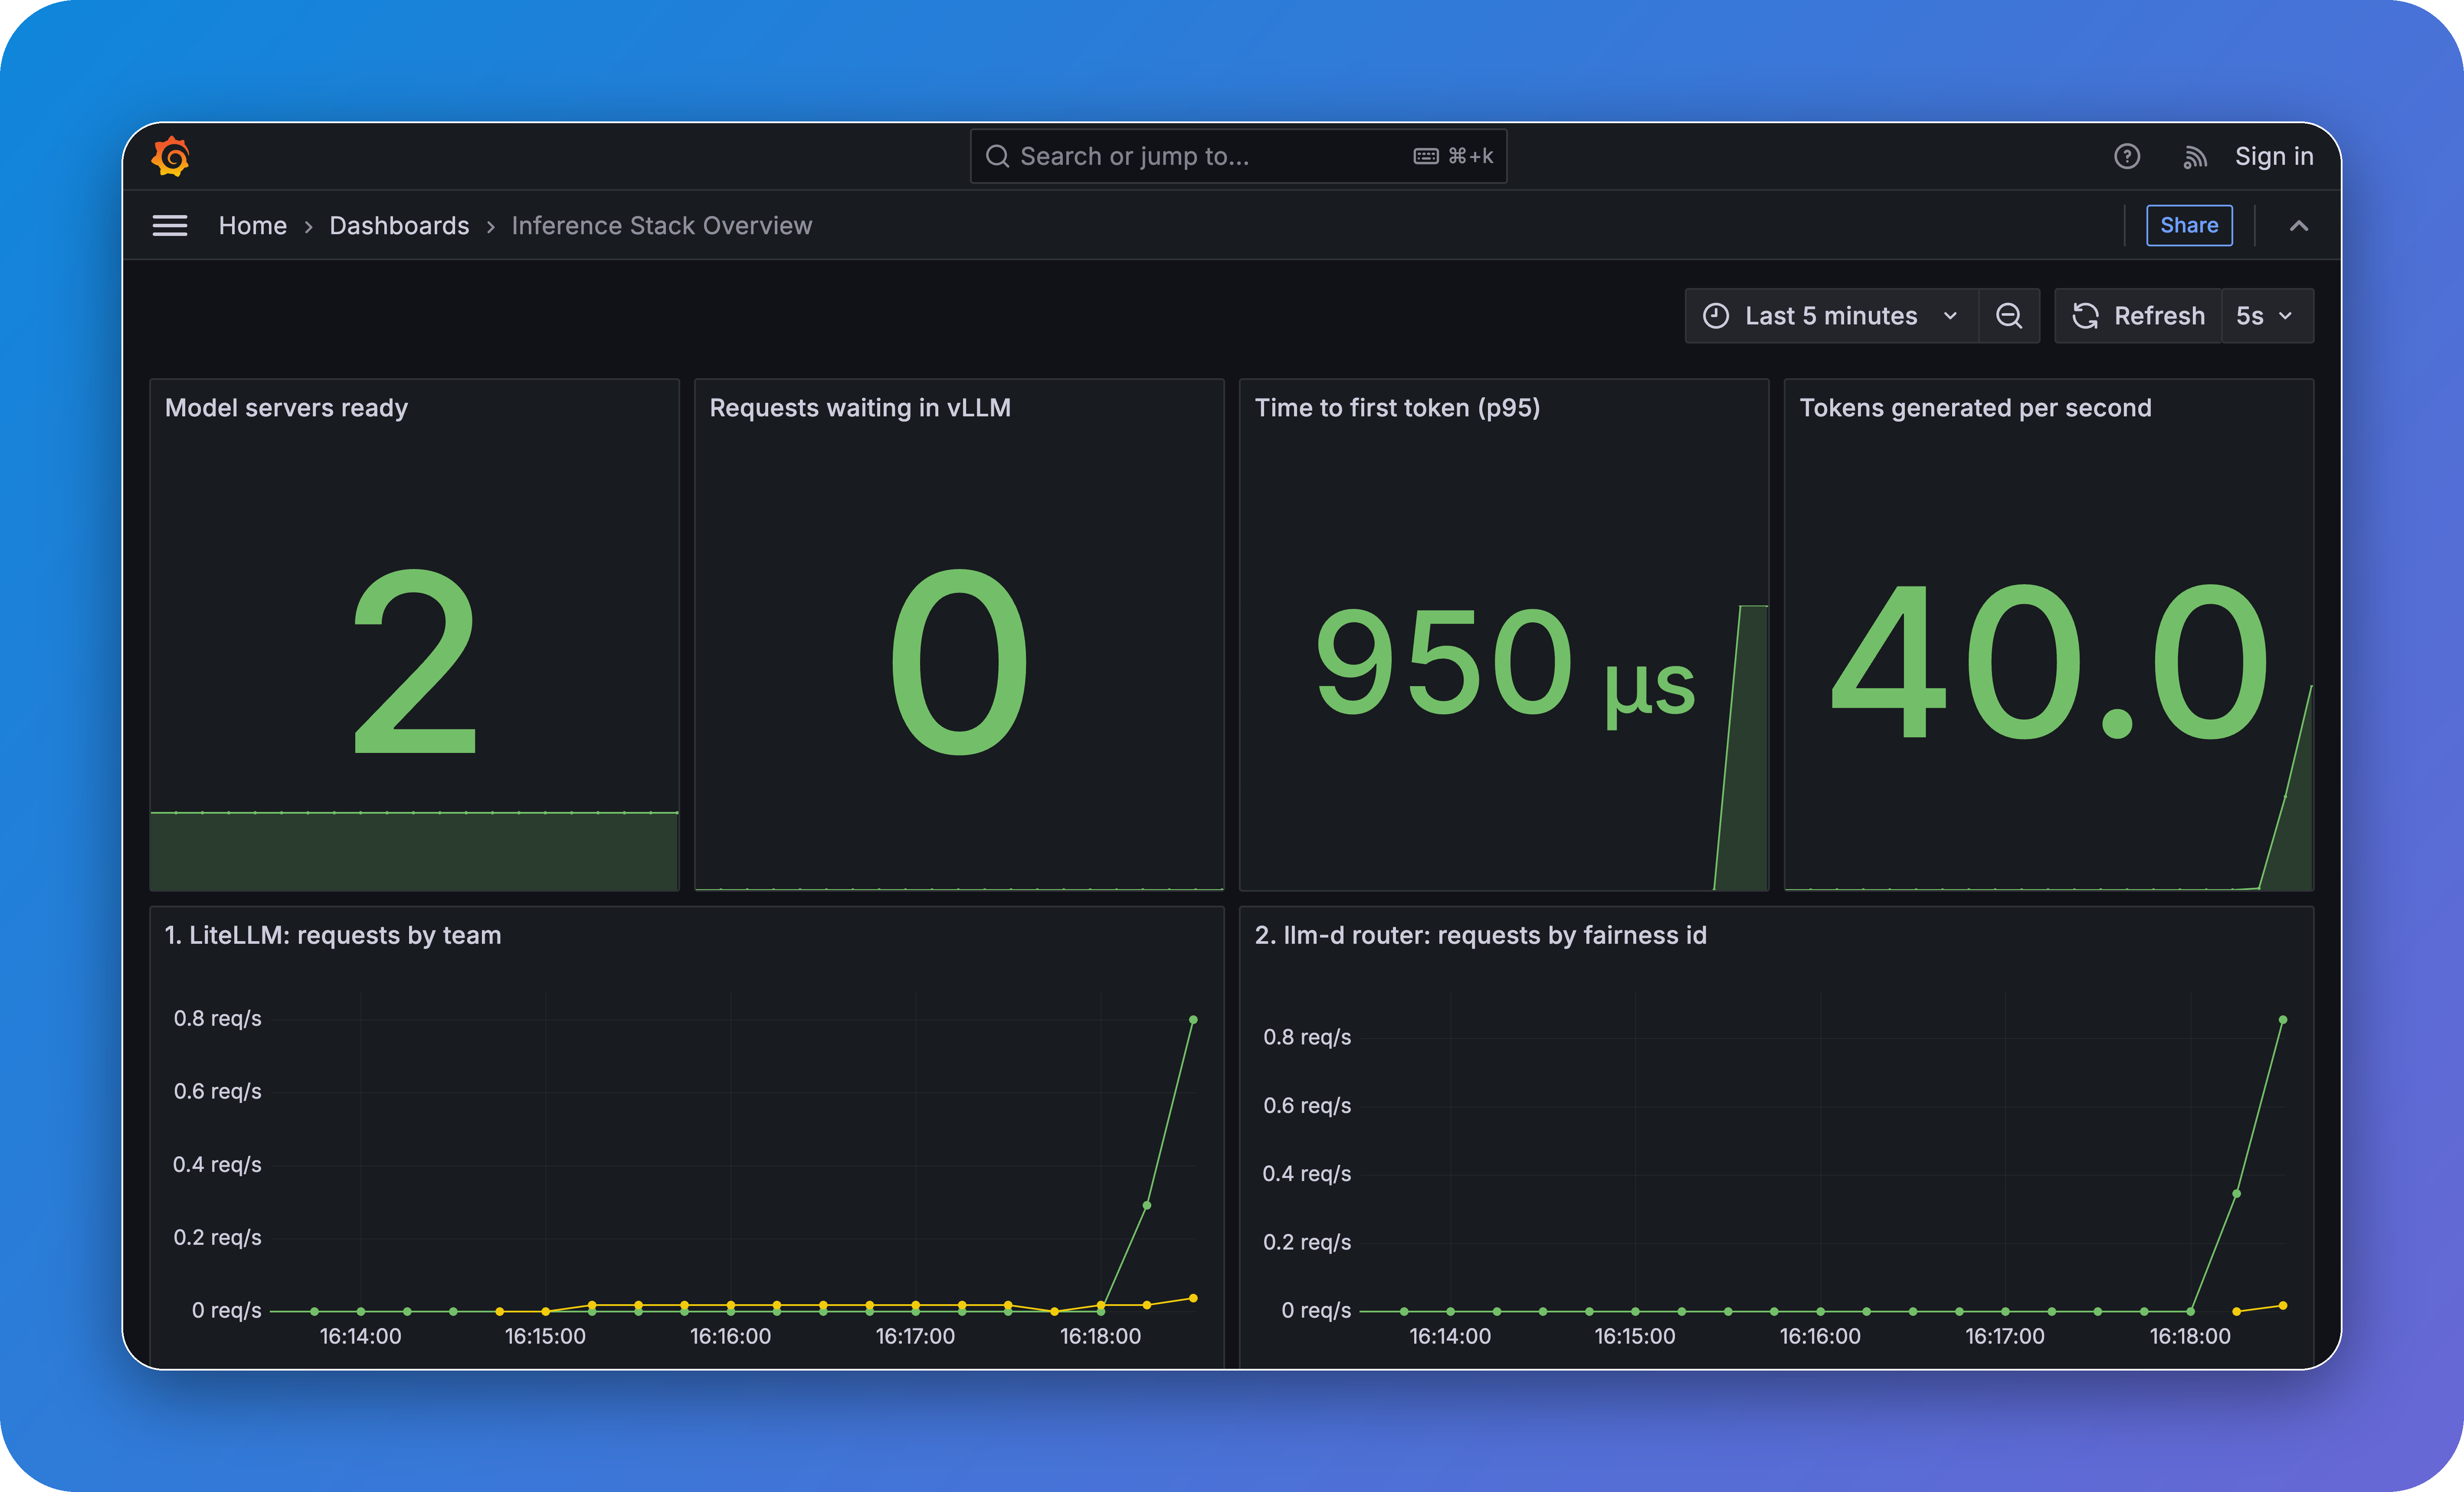
| Grafana | 监控面板,展示模型健康、请求流量和响应时间,数据来自 Prometheus |
五个组件里,llm-d 最值得注意。它做部署级路由:根据每个 vLLM 副本的缓存命中情况和队列长度,把请求分发给合适的副本。缓存命中可以跳过重复计算,直接影响推理成本和响应延迟。多副本场景下,这一层直接关系 GPU 利用率。
部署方式有三种:Docker Compose、Kubernetes、AWS。Docker 快速开始只需要运行:
curl -fsSL https://github.com/BerriAI/inference-stack/releases/download/v0.3.0/install.sh | bash -s -- docker
执行后浏览器访问 http://localhost:8080,用 admin 和生成的密码登录。进入 Deployments,选一个模型,点击部署。模型就绪后,点击 Try in LiteLLM,直接发消息测试。
真实模型推理需要 NVIDIA GPU。没有 GPU 的机器可以在模型设置里启用模拟模式,返回预设响应,完整流程照常走一遍。
几个核心界面的截图:
有网友在发布帖下问:为什么不用 SGLang?vLLM 生态更成熟,和 Hugging Face、LiteLLM 的集成成本更低。SGLang 在部分场景有性能优势,但作为默认推理引擎,vLLM 是更稳的选择。
Inference Stack 使用 MIT 许可证,目前是 v0.3.0 预览版。代码在 GitHub 上,文档在 inferencestack.io。
如果你正在评估自托管推理基础设施,这套栈值得跑一遍。把模型、路由、API、监控全部打包到一起,工程上的拼接工作被压缩成一条命令。剩下要解决的,就是 GPU 从哪来了。
发布时间: 2026-11-23 03:21