算力已经转移,科学还没跟上:post-training的六个未解问题
前沿实验室的post-training/RL算力占比已达55%,预训练只剩7%。Nathan Lambert在Cornell的51页分享,列出了post-training领域六个还没人解决的开放问题。
Nathan Lambert上周在Cornell做了一场分享。51页slides,主题是Pushing Frontiers in Open Language Model Post-Training。核心判断:算力重心已经从预训练转移到post-training,但这个领域的科学基础还远没跟上。
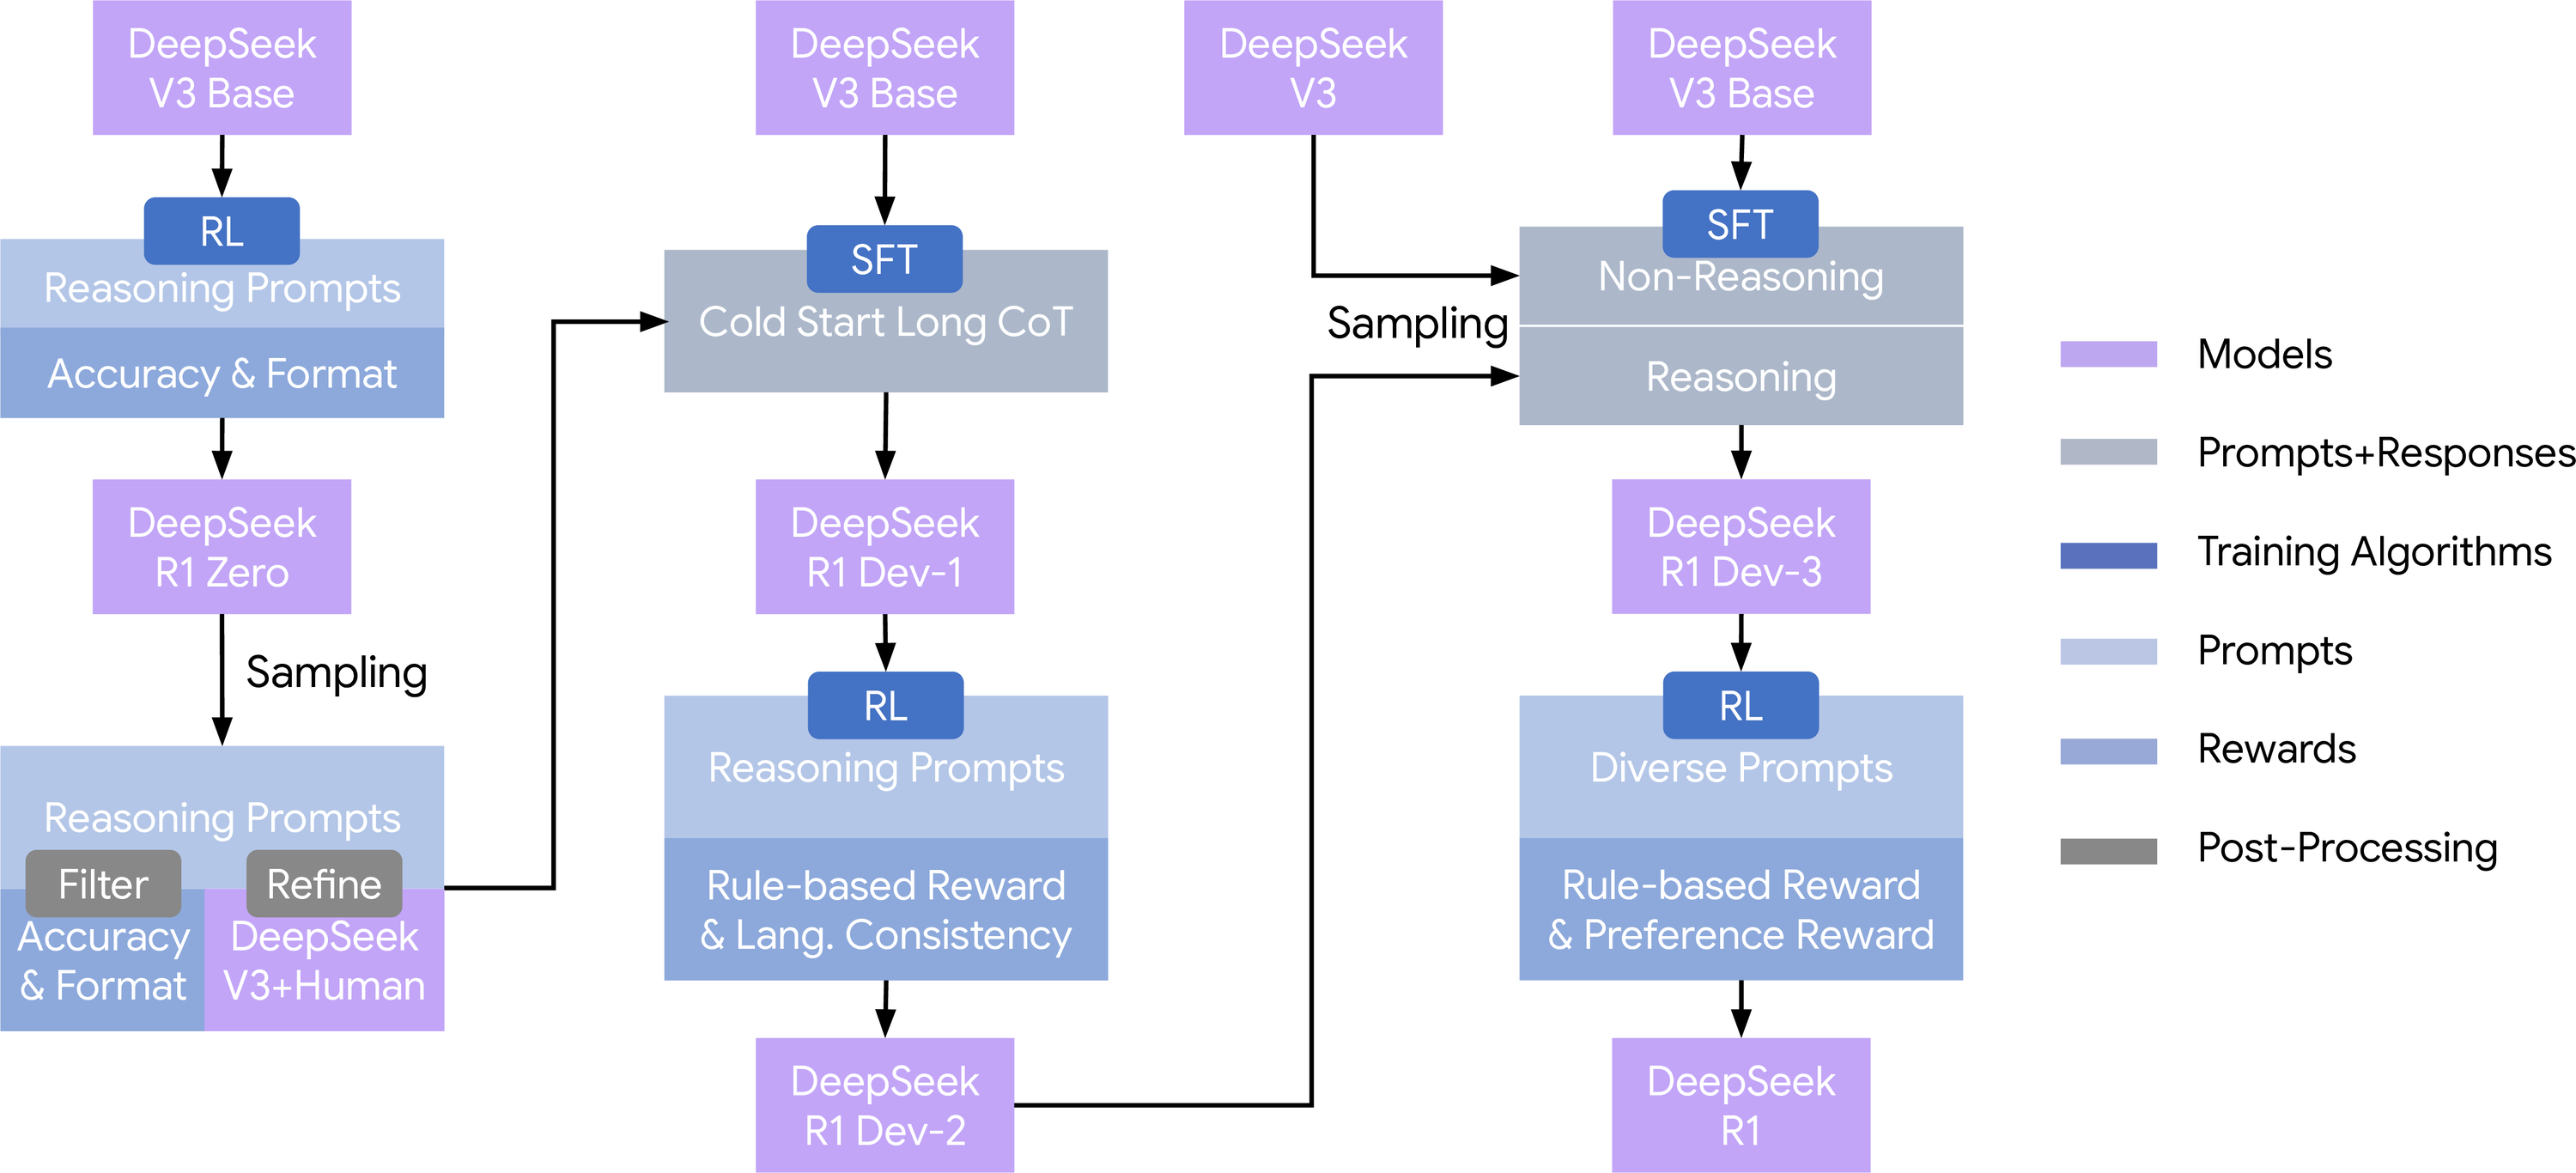
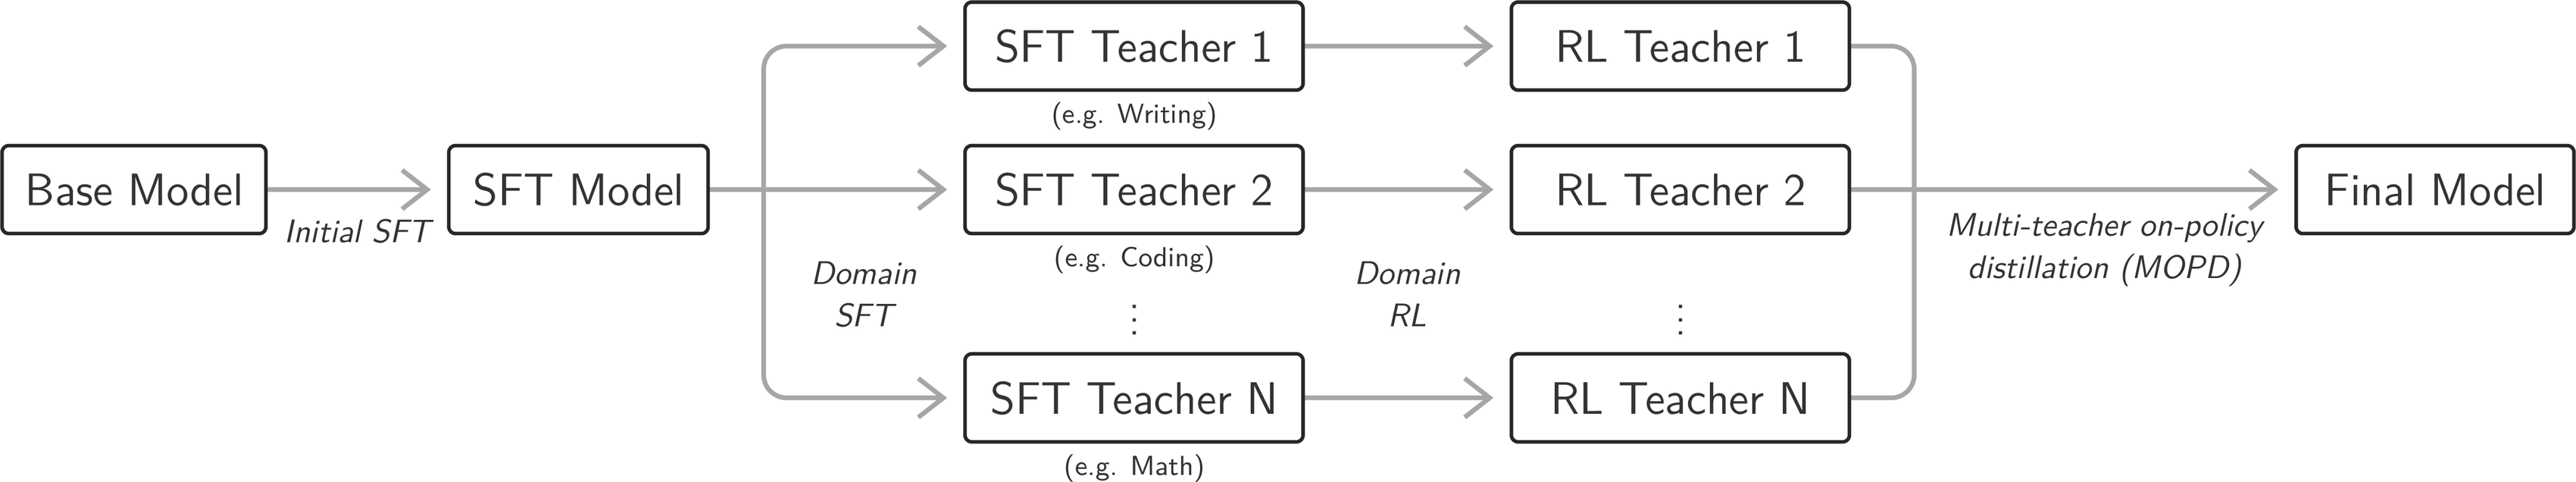
先看recipe的演化。2022年InstructGPT是三件套:SFT → reward model → PPO。2024年Llama 3和Tülu 3加了RLVR,配方开始成熟。2025年DeepSeek R1把大规模RL变成中心环节,纯RL先跑出推理行为,再做SFT和RL混合。2026年MiMo-V2-Flash带来MOPD:训练多个领域专家,再蒸馏回一个最终模型。配方在过去一年的变化比之前三年都大。大约每两年出现一波新的核心技术:2022-2023年的RLHF和DPO,2024-2025年的RLVR和工具使用,2026-2027年的on-policy distillation。下一波是什么,还没人知道。
算力转移的数字更直白。SemiAnalysis的数据显示,Anthropic和OpenAI的算力分配中,pre-training从2024年Q1的67%降到2026年Q4的约7%,post-training和RL从5%涨到55%。单个模型层面,DeepSeek R1的RL算力约为pre-training的5%,Beam超过1.7倍,Inkling 2 Small约4倍。post-training已经不是配角。

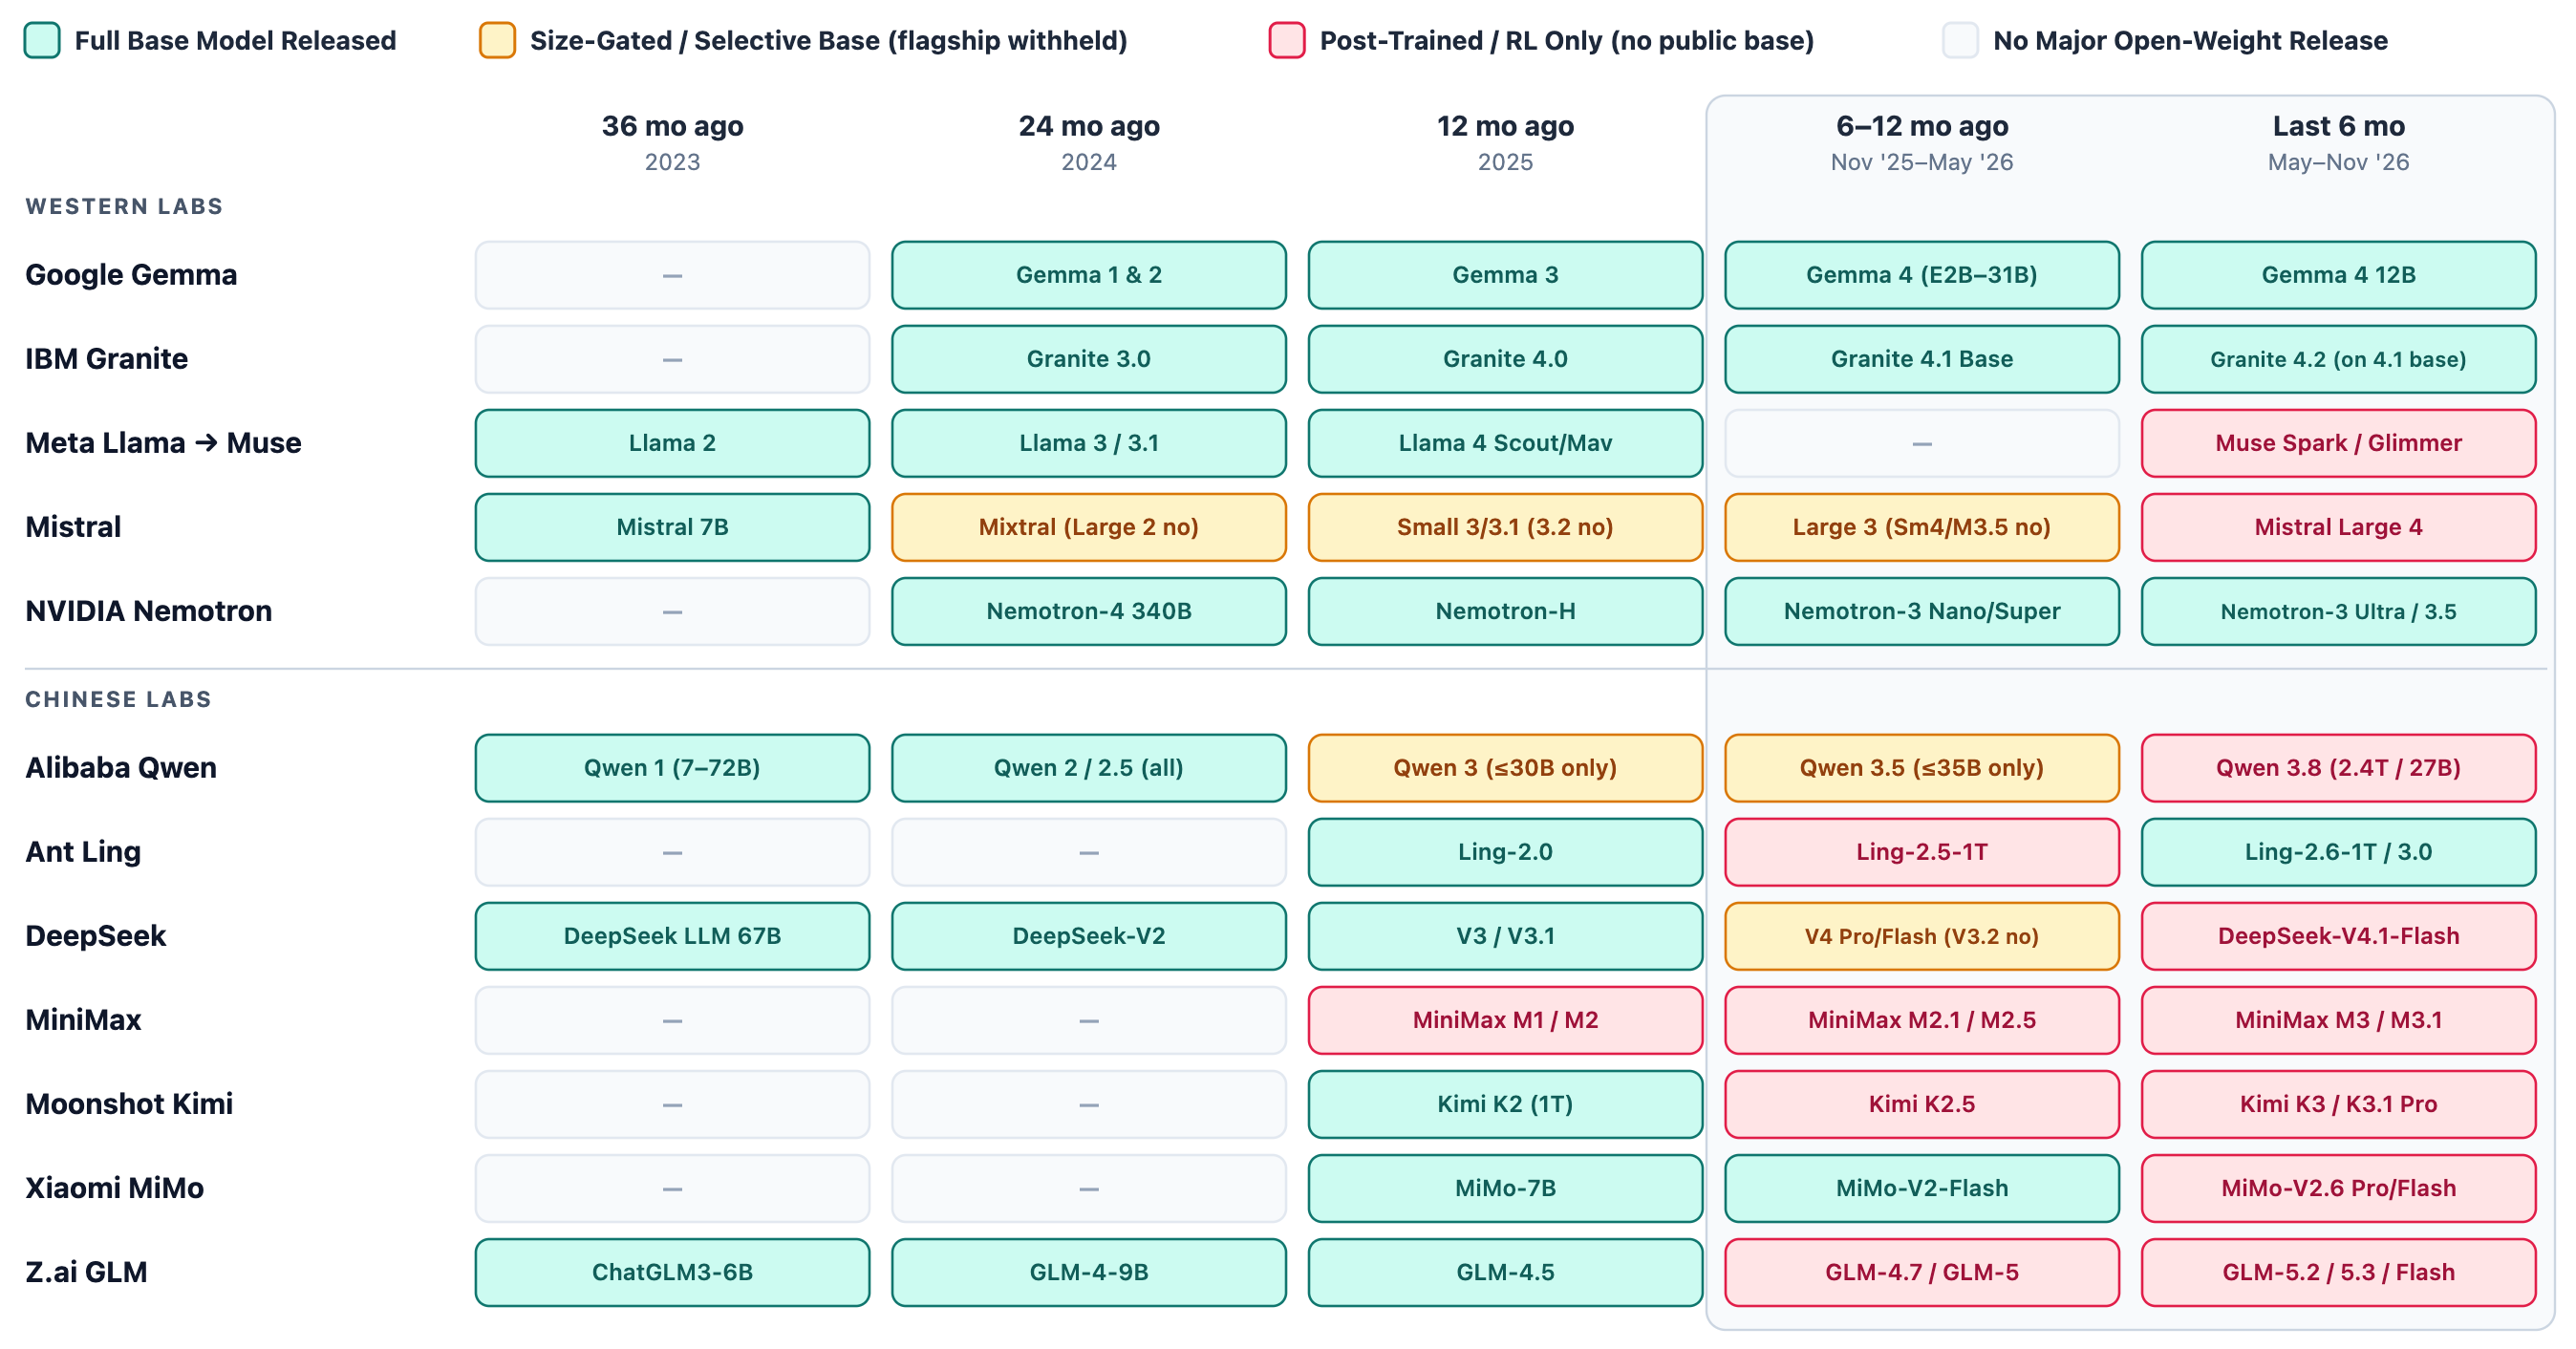
一个直接后果是base model发布越来越少。12家开源权重实验室里,过去12个月大部分从发布完整base model转向只发布post-trained权重。随之而来的一个新概念:post-post-training,直接拿现成的推理模型做领域适配,而不是从base model开始。Harvey用Kimi K3 base做了法律领域post-training,让律所拥有自己的模型。Mercor和SkyRL把Qwen3.5-397B用RL训练成知识工作agent,脚本和weights都开源了。这正在变成一门生意。
Lambert列了六个他认为最重要的开放问题,按算力需求从低到高。
1. Harness specialization and design
怎么设计环境和上下文管理方式,让模型在特定任务上高效工作。这个设计空间很少被认真探索。他的CLM(Context Language Models)是一个方向:模型直接编辑自己的上下文,而不是通过外部harness命令。评论区有人提到PhantomEnvironments,用纯规则生成的虚构世界训练搜索agent,迁移到真实多跳检索基准,效果比真实数据训练还好。这类工作都属于这个象限。
2. Character training
模型的性格和价值观怎么训练,如何影响安全、信任和扩散。行业里OpenAI已经在为agent写新版Model Spec,开源文献没跟上。Lambert参与的Open Character Training用Constitutional AI给Llama 3.1 8B做性格训练,不同性格的模型回答同一问题时风格差异明显,但量化评测极难。有网友补充说,希望看到更多关于模型为什么会写出恼人的AI味语言的研究。
3. Open-source RL environments
Post-training研究缺少pre-training时代那样的数据公共资源。好的数据项目往往有一个特征:主要作者把每一条数据都读了一遍。TMax项目通过九维任务采样生成terminal-bench数据,把2B到27B的Qwen模型做成SOTA终端agent,数据pipeline的复杂程度远超一般合成数据流程。
4. Reasoning efficiency in RL
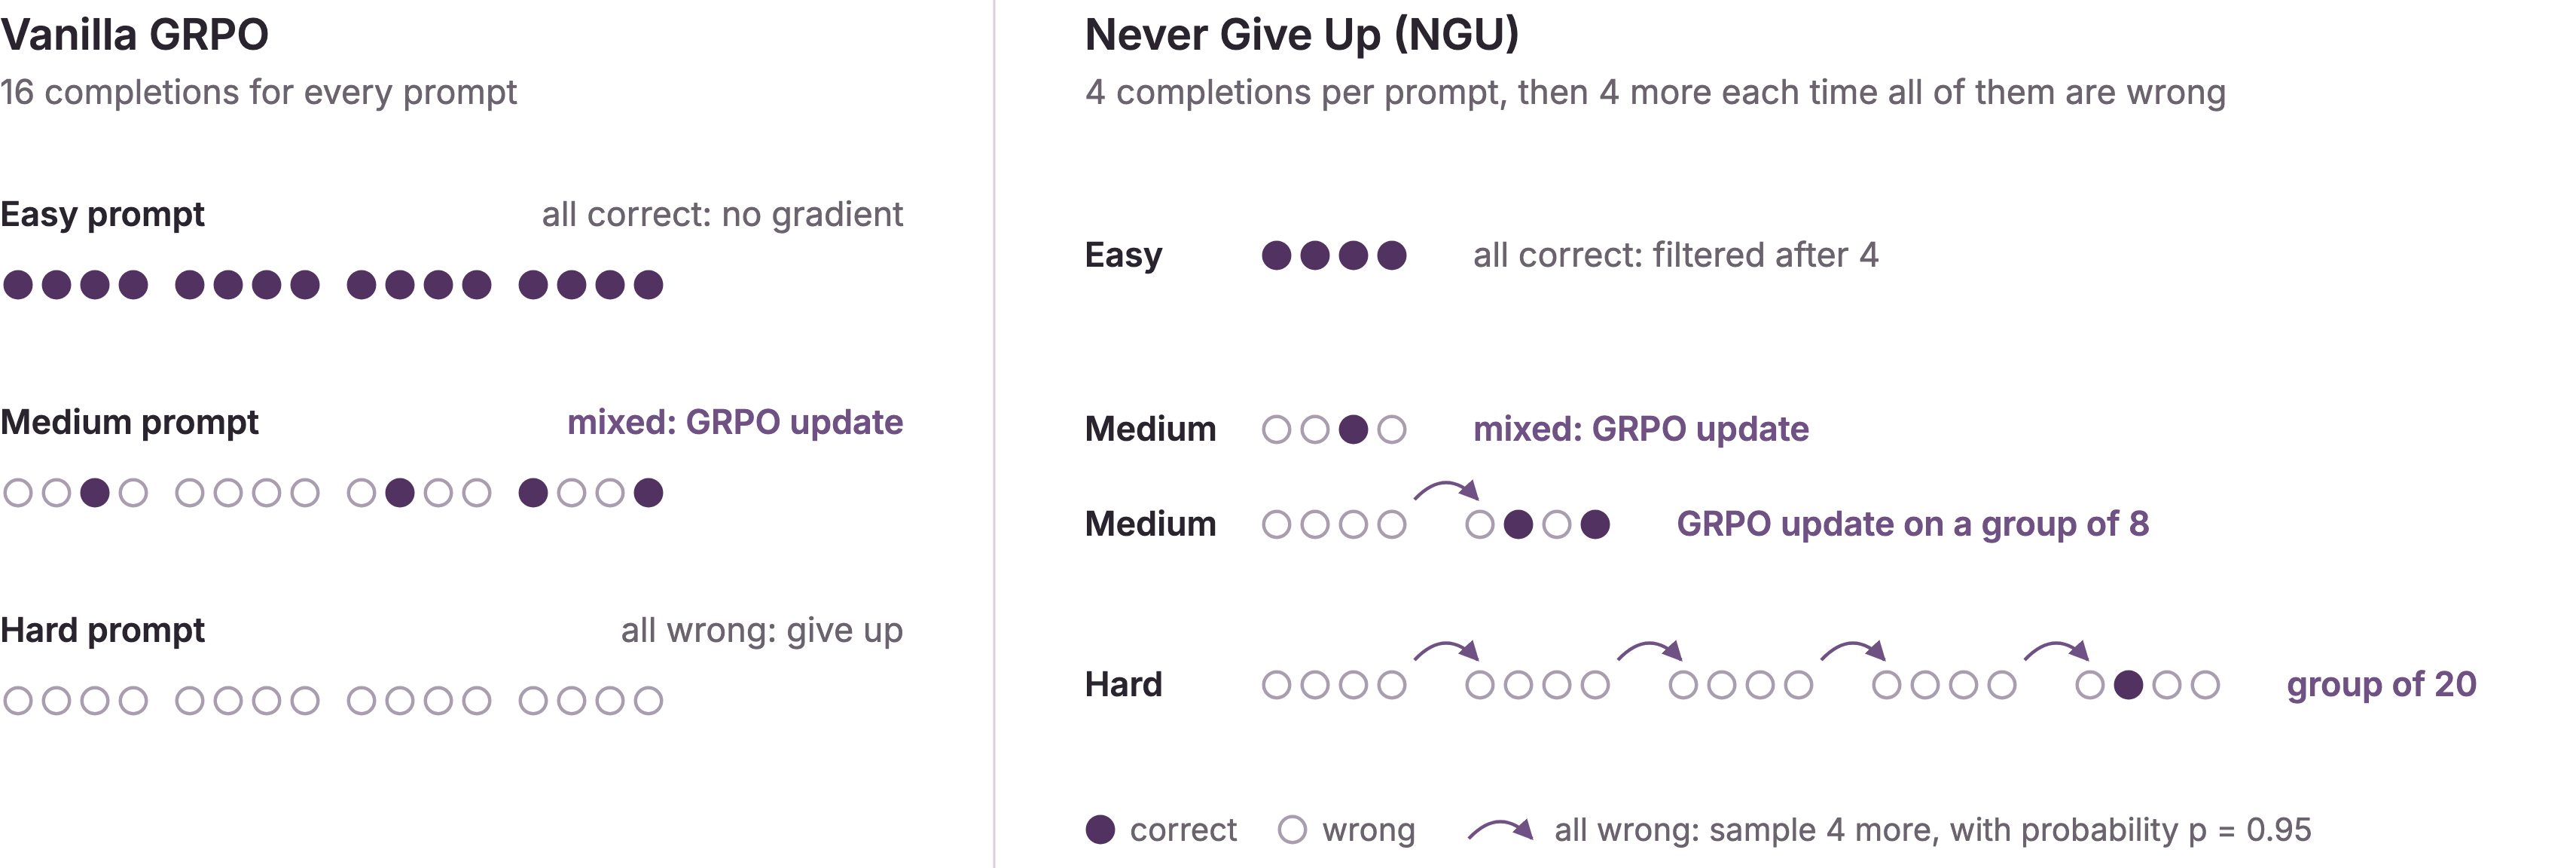
怎么控制推理链的token消耗和效率。常见RL实践对简单问题提升明显,最难的问题几乎推不动。NGU(Never Give Up)的思路是:一批completions全错就继续采样。在Manufactoria上,hard test的pass@1从19%提到88%。实验公平性极难保证,但方向很确定。
5. Scaling laws for RL
预训练有ladder方法预测大规模run的性能,RL没有等价物。ScaleRL用sigmoid拟合reward和log compute的关系,是个开始,但离可用的方法论还远。
6. Multi-agent scaling laws
多智能体系统值得认真研究:哪些任务真的受益于并行加速?模型多样性怎么用?训练时需要为sub-agent改变什么?OpenAI的GPT-5.6和Anthropic的Claude Opus 5.5都展示了更多agent能更快达到更高分数,但基本是经验性的。
slides最后讨论RSI(递归自我改进)对研究生态的冲击。Anthropic的R&D自动化指数显示,由Claude主导的R&D任务占比从2月的不到1%涨到8月的26%。但Lambert的观点是:LLM加速产出,不加速理解。Lambert说自己代码写得少了,但作为科学家的忙碌程度没变。年轻研究者手工做低效工作,往往是建立理解的唯一方式。
一个历史注脚:2023年DPO论文5月发布,Zephyr β和Tülu 2到10月、11月才出来。所有人都在试那个方法,但没人抢先落地。Chris Manning后来感谢Lambert用这两个模型救了DPO。这类应用已知方案的工作,现在会快得多。但像Tülu 3、Olmo 2和3这种涉及组织复杂性的工作,节奏没有变。
Lambert把六个开放问题作为Trillium Labs的研究方向,slides本身就是一份目标声明。算力已经转移,科学还没跟上。这大概是未来几年最值得盯的战场。完整slides在natolambert.com,视频很快会重新录制。
发布时间: 2026-11-22 18:40